Ursprünglich auf Französisch verfasst. Von KI übersetzt — der Sinn wurde bewahrt, nicht der Stil.
Graphify ist ein Werkzeug, das Code kartiert, indem es eine KI dafür bezahlt, jede Datei zu lesen. Ich habe es zweckentfremdet, um mein Wissens-Wiki zu kartieren – ohne KI und ohne API-Schlüssel. Eine einzige Python-Datei mit 160 Zeilen, 0,2 Sekunden Rechenzeit, und tausend Notizen werden zu einem Graphen, den man erkunden, abfragen und durchwandern kann.
Tausend Notizen über Marketing. Atomare Notizen, Glossar-Definitionen, Lesekarten pro Buch. Alle miteinander verlinkt, und jeder Link erklärt, warum es ihn gibt.
Und trotzdem fehlt das Gesamtbild. Einfache Fragen lassen sich nicht beantworten: Was verbindet Cialdinis Reziprozität mit dem Churn eines SaaS-Unternehmens? Welche Notizen bilden den Kern des Themas, und welche sind isoliert?
Die Graphansicht von Obsidian zeigt ein Wollknäuel. Hübsch, aber stumm.
In diesem Artikel erzähle ich, wie ich aus diesem Wiki einen brauchbaren Graphen gewonnen habe, indem ich Graphify zweckentfremdet habe – ein Werkzeug, das eigentlich für Code gedacht ist. Und was mir dieser Graph über meine eigene Wissensbasis beigebracht hat.
Der Ausgangspunkt: ein Wiki, in dem die Links eine Bedeutung haben
Ich habe schon erzählt, warum ich eine KI-gepflegte Wissensbasis aufgebaut habe. Das Prinzip: Ich gebe Claude Bücher und Dokumente, Claude zieht daraus atomare Notizen, Glossar-Einträge und weitere Arten von Notizen und verlinkt sie miteinander.
Für alles Weitere zählt eine Regel mehr als alle anderen: Ein Link ist nie Dekoration. Auf jeden Link folgt ein kurzer Satz, der die Beziehung erklärt.
- [[GLO00614-marche-minimal-viable]] — der MVMarket ist die Strategie,
  um den Chasm zu überqueren, nicht der Chasm selbst.
- [[GLO00619-technology-adoption-life-cycle]] — Rahmen, in den
  sich der Chasm einfügt.
Anders gesagt: Die Beziehungen zwischen den Ideen stehen schon schwarz auf weiß in den Notizen. Genau dieses Detail macht alles Weitere möglich.
Was ist Graphify?
Graphify verwandelt einen Ordner mit Code oder Dokumenten in einen Wissensgraphen, den man anschließend aus einem Assistenten wie Claude Code heraus abfragen kann.
Es arbeitet in zwei Phasen.
- Der Aufbau. Graphify lässt jede Datei von einer KI lesen, die daraus die wichtigen Elemente und die Beziehungen zwischen ihnen ableitet. Das ist der teure Schritt: Er verbraucht Token, und das Ergebnis schwankt von Lauf zu Lauf.
- Die Erkundung. Steht der Graph, zerlegt Graphify ihn in Gruppen eng benachbarter Knoten, erzeugt eine interaktive Karte und einen Bericht und beantwortet Fragen: Welche Verbindungen hat dieses Element, welcher Pfad führt von A nach B?
Die Idee der Zweckentfremdung
Bei einem Code-Repository ist der Aufbau sinnvoll: Niemand hat schwarz auf weiß aufgeschrieben, dass diese Funktion jene aufruft – man muss es ableiten.
In meinem Wiki ist es umgekehrt. Die KI hätte nichts zu erraten. Die Beziehungen sind schon da, von Hand geschrieben oder beim Einlesen bestätigt. Eine KI dafür zu bezahlen, sie neu zu entdecken, wäre teuer, langsam und ungenauer als das, was bereits dasteht.
Also habe ich den Aufbau durch ein kleines eigenes Skript ersetzt und den Rest von Graphify behalten.
Notizen des Wikis (.md)
      │
      │  eigenes Skript: liest die Links [[...]] und ihre Erklärung
      ▼
graph.json  (NetworkX-Standardformat)
      │
      │  Graphify: Gruppen, Karte, Bericht, Fragen
      ▼
graph.html · GRAPH_REPORT.md · explain · path · query
Was die Zweckentfremdung möglich macht: Graphify akzeptiert jeden Graphen im Standardformat der Bibliothek NetworkX. Woher der Graph stammt, prüft es nicht. Man muss ihn nur übergeben.
Unter der Haube: eine einzige Datei
Das Skript erledigt drei Dinge.
1. Die Notizen erfassen. Jede Markdown-Datei wird zu einem Knoten. Ihre Kennung ist der Dateiname, ihr Typ ergibt sich aus dem Präfix: ATO für eine atomare Notiz, GLO für das Glossar, MOC für eine Lesekarte usw.
2. Die Links finden. Ein regulärer Ausdruck findet jedes [[ID-slug]] im Text. Existiert die Zielnotiz, entsteht ein Link.
3. Die Beziehung benennen. Der Text nach dem Gedankenstrich, der auf den Link folgt, wird zum Namen der Beziehung. Deshalb kann Graphify „der MVMarket ist die Strategie, um den Chasm zu überqueren“ anzeigen statt eines schlichten „Link“.
for line in text.splitlines():
    matches = LINK_RE.findall(line)
    relation_match = re.search(r"\]\]\s*[—-]+\s*(.+)", line)
    relation = relation_match.group(1).strip()[:80] if relation_match else "links"
Keine Bibliothek zu installieren: Das Skript nutzt nur Module, die mit Python ausgeliefert werden. Hier die vollständige Datei.
"""
Build graph.json from Obsidian [[links]] in wiki notes — no LLM needed.
Output format: NetworkX node_link_graph (compatible with graphify path/explain/query).

Usage:
    .venv/bin/python scripts/build_graph.py [--theme maintenance] [--output _GRAPHITY/]
"""

import argparse
import json
import re
import uuid
from pathlib import Path

WIKI_ROOT = Path(__file__).resolve().parent.parent.parent.parent / "wiki"
LINK_RE = re.compile(r"\[\[([A-Z]{2,3}\d{5}-[^\]\|]+?)(?:\|[^\]]*)?\]\]")
FRONTMATTER_RE = re.compile(r"^---\n(.*?)\n---", re.DOTALL)

TYPE_MAP = {
    "ATO": "atomic_note",
    "GLO": "glossary_term",
    "NOR": "norm_reference",
    "EXN": "normative_requirement",
    "PRO": "business_process",
    "OBJ": "domain_object",
    "BRL": "business_rule",
    "REG": "regulatory_text",
    "HAB": "habilitation",
    "IND": "indicator",
    "MOC": "moc",
    "SRC": "source_record",
}


def parse_frontmatter(text: str) -> dict:
    m = FRONTMATTER_RE.match(text)
    if not m:
        return {}
    result = {}
    for line in m.group(1).splitlines():
        if ":" in line:
            k, _, v = line.partition(":")
            result[k.strip()] = v.strip().strip('"')
    return result


def slug_to_id(slug: str) -> str:
    """Extract the ID prefix (e.g. 'ATO00001') from a slug like 'ATO00001-some-title'."""
    parts = slug.split("-", 1)
    return parts[0].upper()


def build_graph(theme: str, output_dir: Path) -> dict:
    notes_root = WIKI_ROOT / "themes" / theme / "notes"
    if not notes_root.exists():
        raise SystemExit(f"Notes directory not found: {notes_root}")

    nodes = {}   # node_id -> node dict
    edges = []   # list of {source, target, relation}

    md_files = list(notes_root.rglob("*.md"))
    md_files = [f for f in md_files if f.name != "README.md"]

    # Index: slug -> node_id (file stem without extension)
    slug_index = {}
    for f in md_files:
        stem = f.stem  # e.g. ATO00001-some-title
        slug_index[stem] = stem
        # Also index by bare ID (ATO00001) for robustness
        bare_id = stem.split("-")[0]
        slug_index.setdefault(bare_id, stem)

    print(f"[build_graph] {len(md_files)} notes found in {notes_root}")

    for f in md_files:
        text = f.read_text(encoding="utf-8")
        fm = parse_frontmatter(text)

        node_id = f.stem
        prefix = node_id[:3].upper()
        node_type = TYPE_MAP.get(prefix, "note")
        title = fm.get("title") or fm.get("term") or fm.get("name") or node_id
        subdir = f.parent.name  # e.g. "atomiques", "glossaire"

        nodes[node_id] = {
            "id": node_id,
            # label = slug so graphify path/explain resolve by ID (e.g. "ATO00001-...")
            "label": node_id,
            "title": title,
            # norm_label includes slug tokens for fuzzy matching
            "norm_label": node_id.lower().replace("-", " "),
            "type": node_type,
            "kind": node_type,
            "source_file": str(f.relative_to(WIKI_ROOT.parent)),
            "subdir": subdir,
            "status": fm.get("status", "draft"),
            "uid": fm.get("uid") or str(uuid.uuid4()),
            "wiki_id": fm.get("id", ""),
        }

    # Second pass: extract links
    seen_edges = set()
    for f in md_files:
        text = f.read_text(encoding="utf-8")
        source_id = f.stem

        # Extract label from link context line (text after — )
        for line in text.splitlines():
            matches = LINK_RE.findall(line)
            # Extract relation label from "— relation text" after the link
            relation_match = re.search(r"\]\]\s*[—-]+\s*(.+)", line)
            relation = relation_match.group(1).strip()[:80] if relation_match else "links"

            for slug in matches:
                # Resolve target
                target_id = slug_index.get(slug) or slug_index.get(slug.split("-")[0])
                if not target_id or target_id == source_id:
                    continue
                if target_id not in nodes:
                    continue
                key = (source_id, target_id)
                if key in seen_edges:
                    continue
                seen_edges.add(key)
                edges.append({
                    "source": source_id,
                    "target": target_id,
                    "relation": relation,
                    "key": 0,
                })

    node_list = list(nodes.values())

    graph_data = {
        "directed": True,
        "multigraph": False,
        "graph": {"theme": theme},
        "nodes": node_list,
        "links": edges,
    }

    output_dir.mkdir(parents=True, exist_ok=True)
    graph_path = output_dir / "graph.json"
    graph_path.write_text(json.dumps(graph_data, ensure_ascii=False, indent=2), encoding="utf-8")

    print(f"[build_graph] {len(node_list)} nodes, {len(edges)} edges")
    print(f"[build_graph] graph.json → {graph_path}")
    return graph_data


if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("--theme", default="maintenance")
    parser.add_argument("--output", default="_GRAPHITY/")
    args = parser.parse_args()

    build_graph(args.theme, Path(args.output) / args.theme)
Was dabei für das Thema Marketing herauskommt
Das Thema Marketing in meinem Wiki speist sich aus rund zwanzig Büchern: Dunford, Seth Godin, Cialdini, Moore, Ries und Trout, Nagle, Byron Sharp, Rob Fitzpatrick …
| Messgröße | Wert |
|---|---|
| Notizen | 1 013 |
| Links | 6 442 |
| Erkannte Gruppen von Notizen | 22 |
| Zeit für den Aufbau des Graphen | 0,2 Sekunden |
| Verbrauchte KI-Token | 0 |
Die Karte und ihre Gruppen von Notizen
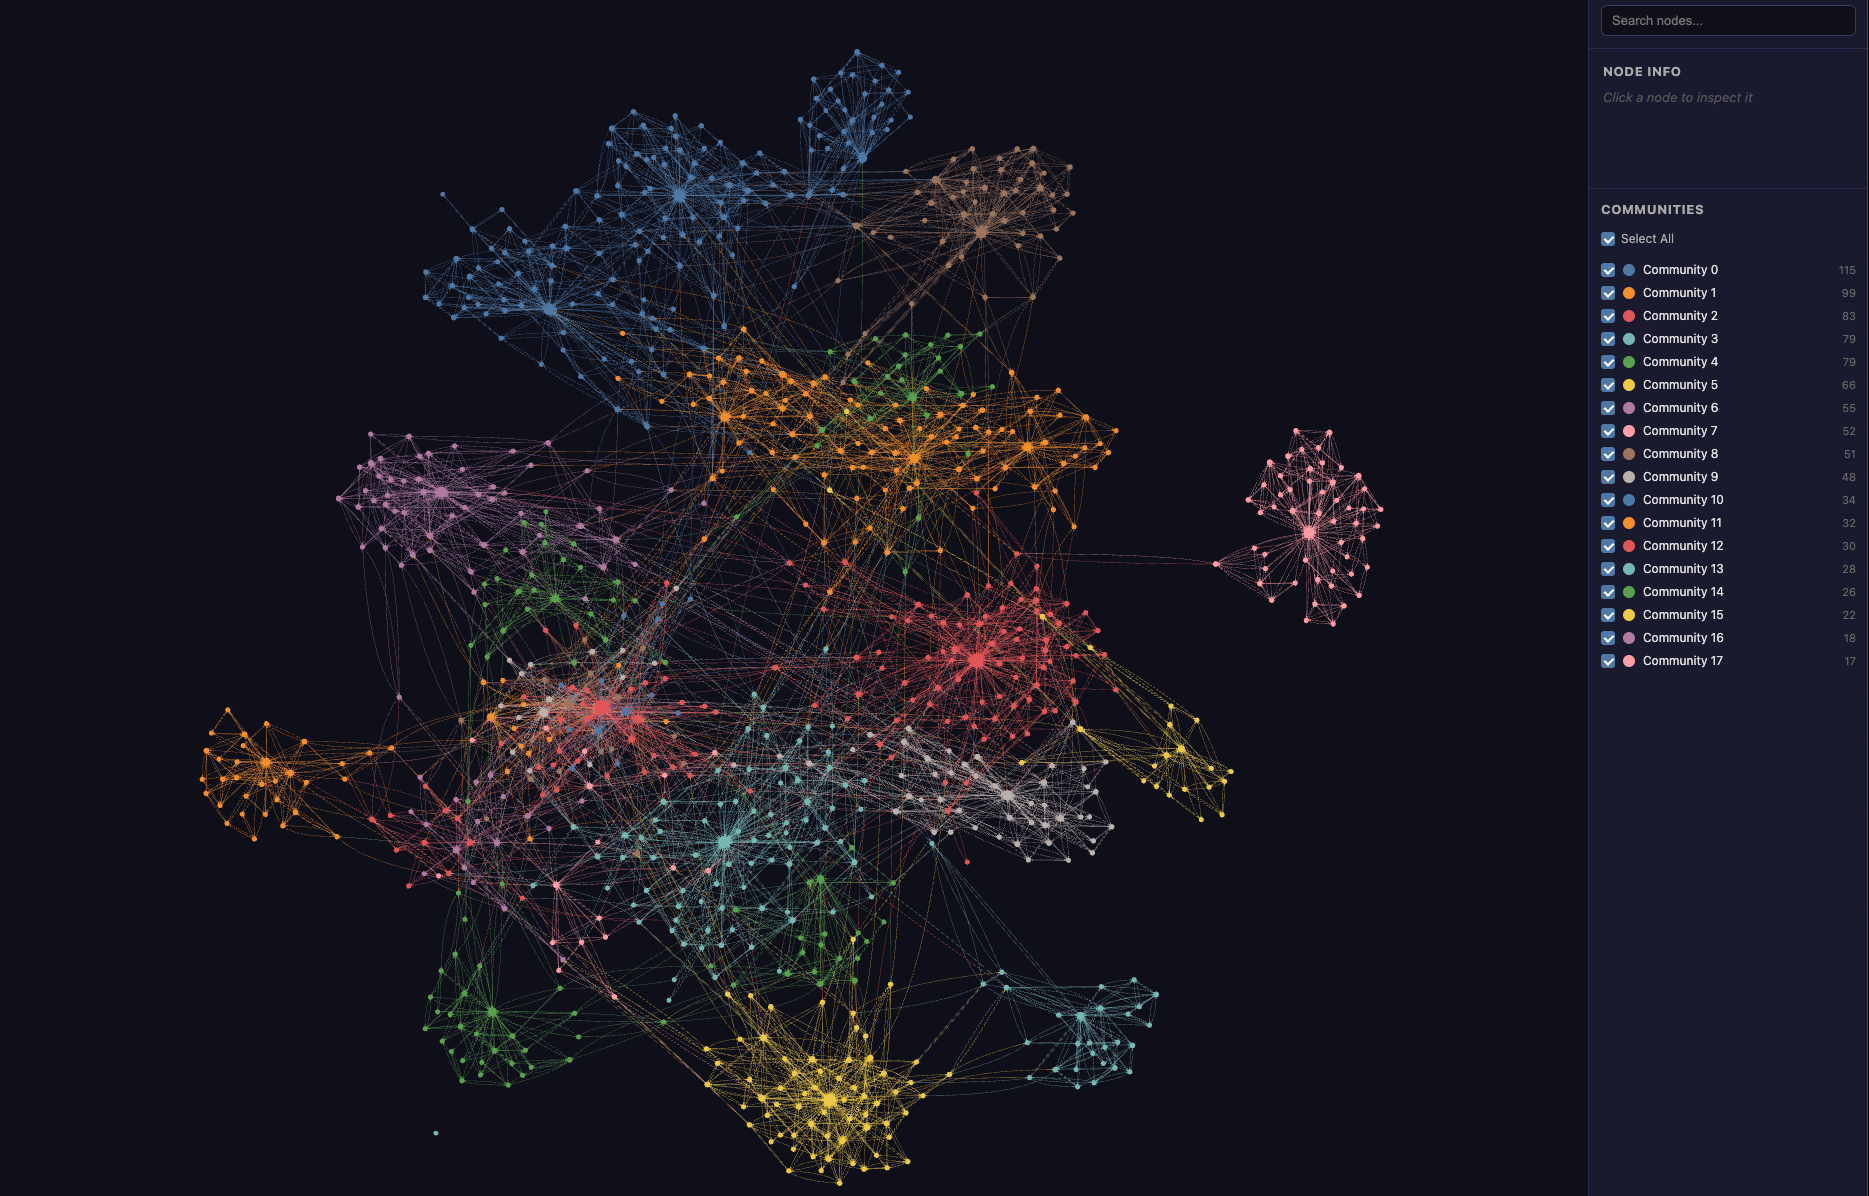
Graphify zerlegt den Graphen in Gruppen von Notizen, die untereinander stärker verlinkt sind als mit dem Rest. Einige Gruppen aus dem Thema Marketing:
- Eine Gruppe von 53 Notizen rund um den Mom Test: Kundengespräche, Komplimente, die nichts wert sind, vergangene Fakten statt Versprechen.
- Eine Gruppe von 52 Notizen über Einfluss: Cialdinis sechs Prinzipien, die Reziprozität, der Wahrnehmungskontrast, das „weil“, das Gehorsam auslöst.
- Eine Gruppe von 46 Notizen über den Chasm: die Kluft zwischen den Early Adopters und der pragmatischen Mehrheit, die Bowling-Pin-Strategie.
- Eine Gruppe von 26 Notizen über Customer Success: Churn als Todesspirale, der Unterschied zwischen Customer Success und Support.
Der Bericht nennt außerdem die am stärksten verbundenen Notizen. Die ersten zehn sind allesamt Lesekarten: Die zu Obviously Awesome von Dunford liegt mit 180 Links vorn, vor This is Marketing von Seth Godin mit 156 Links.
Schließlich meldet er die isolierten Notizen. Eine einzige von 1 013: eine Notiz über die Marketing-Persona, die mit nichts sonst verbunden ist. Eine Lücke im Wiki, kostenlos gefunden.
Die Verbindungen einer Notiz
Man bittet Graphify, die Glossar-Notiz zum Chasm zu erklären:
graphify explain "GLO00618-chasm"
Die Antwort: ihre 30 Verbindungen in beide Richtungen, jeweils mit ihrer Beziehung. Ein Auszug:
| Richtung | Verlinkte Notiz | In der Notiz geschriebene Beziehung |
|---|---|---|
| ← | Lesekarte Crossing the Chasm | die zentrale Kluft des Modells |
| → | Technologie-Adoptionszyklus | Rahmen, in den sich der Chasm einfügt |
| → | Early Adopters suchen einen radikalen Vorteil, die Mehrheit eine schrittweise Verbesserung | erklärt die psychografische Ursache des Chasm |
| ← | Vollständiges Produkt (whole product) | der Chasm entsteht zum Teil, weil ein vollständiges Produkt fehlt |
| ← | Bowling Alley | beginnt nach der Überquerung des Chasm |
| → | Moores Kluft trennt die Early Adopters vom Massenmarkt | dieselbe Idee, von Seth Godin, der Moore zitiert |
→: Der Chasm zitiert diese Notiz. ←: Diese Notiz zitiert den Chasm.
Die letzte Zeile ist die interessanteste. Der Chasm stammt von Geoffrey Moore, aber Seth Godin spricht in einem anderen Buch ebenfalls davon. Der Graph zeigt, dass beide Quellen bei derselben Idee zusammenkommen.
Der Pfad zwischen zwei weit entfernten Ideen
Was hat Cialdinis Reziprozitätsregel, ein Prinzip der Sozialpsychologie, mit dem Churn in einem Abo-Geschäft zu tun?
graphify path \
  "ATO01269-la-regle-de-reciprocite..." \
  "ATO01404-dans-un-business-de-revenus-recurrents-le-churn..."
Graphify findet einen Pfad in 8 Schritten:
- Die Reziprozitätsregel ist universell und begründet die menschliche Kooperation
- → die Lesekarte zu Influence (Cialdini)
- → Die erste Zusage verändert das Selbstbild und erzeugt automatische Konsistenz
- → Hohes Risiko schafft Vertrauen; den Preis zu senken, verringert es
- → nahe an: ein hoher Preis signalisiert Qualität und stützt das Vertrauen → Der Preis-Qualitäts-Effekt lässt einen hohen Preis als Qualitätssignal erscheinen
- → die Lesekarte zu The Strategy and Tactics of Pricing (Nagle)
- → Wechselkosten senken die Preissensibilität → konvergiert: Switching Costs sind ein wichtiger Hebel für die Kundenbindung → Kundenbindung ist der stärkste Wachstumsmultiplikator
- → Konvergenz mit der These von Customer Success: Churn zerstört Wachstum → In einem wiederkehrenden Geschäft ist Churn eine Todesspirale
Der Pfad erzählt eine Geschichte: von der Psychologie der Zusage über den Preis als Vertrauenssignal bis zu den Wechselkosten und der Kundenbindung. Niemand hat diese Argumentation in einem Stück aufgeschrieben. Sie entsteht aus den Links, die Notiz für Notiz, Buch für Buch gesetzt wurden.
Was das über die Graphansicht von Obsidian hinaus bringt
Die Graphansicht von Obsidian zeichnet die Links. Graphify kann zusätzlich:
- Gruppen von Notizen automatisch erkennen;
- Beziehungen benennen, indem es die in der Notiz geschriebene Erklärung übernimmt;
- den kürzesten Pfad zwischen zwei Notizen finden;
- einen Bericht erstellen: zentrale Notizen, isolierte Notizen, unerwartete Verbindungen;
- über die Kommandozeile laufen, sodass Claude es selbst abfragen kann, während es am Wiki arbeitet.
Die Grenzen
Die Suche per Frage liest nur die Titel. Graphify hat auch einen Befehl für die freie Suche. Er sucht die Wörter der Frage im Namen der Notizen, nicht in ihrem Inhalt, und weitet die Suche dann auf benachbarte Notizen aus. Verwendet die Frage nicht die Wörter des Titels, findet er nichts.
Die Gruppen folgen eher den Büchern als den Konzepten. Die Positionierung zum Beispiel zerfällt in fünf Gruppen, im Wesentlichen nach Herkunftsbuch: Dunford auf der einen Seite, Ries und Trout auf der anderen. Die Lesekarten pro Buch bündeln so viele Links, dass sie den ganzen Graphen strukturieren. Dieselbe Wirkung bei den Pfaden: Der Pfad vom Chasm zur Zahlungsbereitschaft führt über drei Lesekarten – zutreffend, aber wenig aufschlussreich.
Die Gruppen haben keine Namen. Graphify kann sie mit einer KI benennen, aber damit käme genau der Aufwand zurück, den ich vermeiden wollte. Sie heißen also „Community 0“, „Community 1“ … und die Deutung bleibt mir überlassen.
Graphify bleibt ein Werkzeug für Code. Bei jedem Aufbau meldet es 12 884 Warnungen: Den Links fehlt eine „Quelldatei“, ein Begriff, der nur für Code Sinn ergibt. Folgen hat das keine, aber es erinnert daran, dass man das Werkzeug außerhalb seines vorgesehenen Zwecks einsetzt.
Der Graph ist nur so gut wie die Links. Ein Link ohne Erklärung wird zu einer stummen Beziehung „links“. Eine schlecht verlinkte Notiz bleibt isoliert. Der Graph korrigiert nichts, er macht nur sichtbar.
Selbst nachbauen
Du brauchst eine Sammlung von Markdown-Notizen, die über [[...]]-Links verbunden sind:
- entweder einen Obsidian-Vault, den du selbst verlinkst;
- oder ein von einer KI gepflegtes Wiki, wie das in diesem Artikel beschriebene.
Das Skript oben setzt Kennungen der Form ATO00001-slug und eine Ordnerstruktur nach Themen voraus. Den regulären Ausdruck für die Links und den Notizordner musst du an deine eigene Organisation anpassen.
Danach drei Befehle:
pip install graphifyy

python build_graph.py --theme marketing --output _GRAPHITY/

graphify cluster-only _GRAPHITY/marketing/ --no-label \
  --graph _GRAPHITY/marketing/graph.json
Die interaktive Karte liegt dann in _GRAPHITY/marketing/graphify-out/graph.html, der Bericht in GRAPH_REPORT.md daneben. Die Befehle explain und path funktionieren direkt auf der Datei graph.json.
Die KI hatte nichts zu erraten. Es genügte, zu lesen, was schon geschrieben stand.