Escrito originalmente em francês. Traduzido por IA — o sentido foi preservado, não a prosa.
O Graphify é uma ferramenta feita para mapear código pagando uma IA para ler cada arquivo. Eu a adaptei para mapear meu wiki de conhecimento, sem IA e sem chave de API. Um único arquivo Python de 160 linhas, 0,2 segundo de cálculo, e mil notas viram um grafo que você pode explorar, consultar e percorrer.
Mil notas sobre marketing. Notas atômicas, definições de glossário, mapas de leitura por livro. Todas ligadas entre si, e cada link explica por que existe.
Mesmo assim, era impossível enxergar a forma do conjunto. Impossível responder de um jeito simples a perguntas como: o que liga a reciprocidade de Cialdini ao churn de um SaaS? Quais notas estão no coração do tema, e quais estão isoladas?
A visão de grafo do Obsidian mostra um novelo de lã. Bonito, mas mudo.
Este artigo conta como consegui um grafo utilizável desse wiki usando o Graphify, uma ferramenta pensada para código, para outro fim — e o que esse grafo me ensinou sobre a minha própria base.
O ponto de partida: um wiki em que os links fazem sentido
Já contei por que construí uma base de conhecimento mantida por uma IA. O princípio: eu entrego livros e documentos ao Claude, que extrai deles notas atômicas, entradas de glossário e outros tipos de ficha, e depois liga tudo entre si.
Uma regra conta mais que todas as outras para o que vem a seguir: um link nunca deve ser decorativo. Cada link vem seguido de uma frase curta que explica a relação.
- [[GLO00614-marche-minimal-viable]] — o MVMarket é a estratégia
  para atravessar o chasm, não o chasm em si.
- [[GLO00619-technology-adoption-life-cycle]] — quadro em que
  o chasm se insere.
Em outras palavras, as relações entre as ideias já estão escritas, preto no branco, nas notas. É esse detalhe que torna todo o resto possível.
O que é o Graphify?
O Graphify transforma uma pasta de código ou de documentos em grafo de conhecimento, que depois você pode consultar a partir de um assistente como o Claude Code.
Ele funciona em duas fases.
- A construção. O Graphify pede a uma IA que leia cada arquivo e deduza dele os elementos importantes e as relações entre eles. É a etapa cara: consome tokens, e o resultado varia de uma execução para outra.
- A exploração. Com o grafo construído, o Graphify o divide em grupos de nós próximos, gera um mapa interativo e um relatório, e responde a perguntas: quais são as conexões de tal elemento, que caminho liga A a B.
A ideia do uso alternativo
Num repositório de código, a etapa de construção faz sentido: ninguém escreveu preto no branco que tal função chama tal outra, é preciso deduzir.
No meu wiki, é o contrário. A IA não teria nada a adivinhar. As relações já estão lá, escritas à mão ou validadas no momento da ingestão. Pagar uma IA para redescobri-las seria caro, lento e menos fiel do que o que já está escrito.
Então troquei a construção por um pequeno script caseiro e mantive todo o resto do Graphify.
Notas do wiki (.md)
      │
      │  script caseiro: lê os links [[...]] e a explicação de cada um
      ▼
graph.json  (formato padrão NetworkX)
      │
      │  Graphify: grupos, mapa, relatório, perguntas
      ▼
graph.html · GRAPH_REPORT.md · explain · path · query
O que torna esse uso alternativo possível: o Graphify aceita qualquer grafo no formato padrão da biblioteca NetworkX. Ele não verifica de onde vem esse grafo. Basta entregá-lo.
Por baixo do capô: um único arquivo
O script faz três coisas.
1. Listar as notas. Cada arquivo Markdown vira um nó. O identificador é o nome do arquivo, e o tipo é deduzido do prefixo: ATO para uma nota atômica, GLO para o glossário, MOC para um mapa de leitura etc.
2. Encontrar os links. Uma expressão regular encontra cada [[ID-slug]] no texto. Se a nota de destino existe, um link é criado.
3. Dar nome à relação. O texto escrito depois do travessão que segue o link vira o nome da relação. É isso que permite ao Graphify mostrar "o MVMarket é a estratégia para atravessar o chasm" em vez de um simples "link".
for line in text.splitlines():
    matches = LINK_RE.findall(line)
    relation_match = re.search(r"\]\]\s*[—-]+\s*(.+)", line)
    relation = relation_match.group(1).strip()[:80] if relation_match else "links"
Nenhuma biblioteca para instalar: o script usa só módulos que já vêm com o Python. Aqui está o arquivo completo.
"""
Build graph.json from Obsidian [[links]] in wiki notes — no LLM needed.
Output format: NetworkX node_link_graph (compatible with graphify path/explain/query).

Usage:
    .venv/bin/python scripts/build_graph.py [--theme maintenance] [--output _GRAPHITY/]
"""

import argparse
import json
import re
import uuid
from pathlib import Path

WIKI_ROOT = Path(__file__).resolve().parent.parent.parent.parent / "wiki"
LINK_RE = re.compile(r"\[\[([A-Z]{2,3}\d{5}-[^\]\|]+?)(?:\|[^\]]*)?\]\]")
FRONTMATTER_RE = re.compile(r"^---\n(.*?)\n---", re.DOTALL)

TYPE_MAP = {
    "ATO": "atomic_note",
    "GLO": "glossary_term",
    "NOR": "norm_reference",
    "EXN": "normative_requirement",
    "PRO": "business_process",
    "OBJ": "domain_object",
    "BRL": "business_rule",
    "REG": "regulatory_text",
    "HAB": "habilitation",
    "IND": "indicator",
    "MOC": "moc",
    "SRC": "source_record",
}


def parse_frontmatter(text: str) -> dict:
    m = FRONTMATTER_RE.match(text)
    if not m:
        return {}
    result = {}
    for line in m.group(1).splitlines():
        if ":" in line:
            k, _, v = line.partition(":")
            result[k.strip()] = v.strip().strip('"')
    return result


def slug_to_id(slug: str) -> str:
    """Extract the ID prefix (e.g. 'ATO00001') from a slug like 'ATO00001-some-title'."""
    parts = slug.split("-", 1)
    return parts[0].upper()


def build_graph(theme: str, output_dir: Path) -> dict:
    notes_root = WIKI_ROOT / "themes" / theme / "notes"
    if not notes_root.exists():
        raise SystemExit(f"Notes directory not found: {notes_root}")

    nodes = {}   # node_id -> node dict
    edges = []   # list of {source, target, relation}

    md_files = list(notes_root.rglob("*.md"))
    md_files = [f for f in md_files if f.name != "README.md"]

    # Index: slug -> node_id (file stem without extension)
    slug_index = {}
    for f in md_files:
        stem = f.stem  # e.g. ATO00001-some-title
        slug_index[stem] = stem
        # Also index by bare ID (ATO00001) for robustness
        bare_id = stem.split("-")[0]
        slug_index.setdefault(bare_id, stem)

    print(f"[build_graph] {len(md_files)} notes found in {notes_root}")

    for f in md_files:
        text = f.read_text(encoding="utf-8")
        fm = parse_frontmatter(text)

        node_id = f.stem
        prefix = node_id[:3].upper()
        node_type = TYPE_MAP.get(prefix, "note")
        title = fm.get("title") or fm.get("term") or fm.get("name") or node_id
        subdir = f.parent.name  # e.g. "atomiques", "glossaire"

        nodes[node_id] = {
            "id": node_id,
            # label = slug so graphify path/explain resolve by ID (e.g. "ATO00001-...")
            "label": node_id,
            "title": title,
            # norm_label includes slug tokens for fuzzy matching
            "norm_label": node_id.lower().replace("-", " "),
            "type": node_type,
            "kind": node_type,
            "source_file": str(f.relative_to(WIKI_ROOT.parent)),
            "subdir": subdir,
            "status": fm.get("status", "draft"),
            "uid": fm.get("uid") or str(uuid.uuid4()),
            "wiki_id": fm.get("id", ""),
        }

    # Second pass: extract links
    seen_edges = set()
    for f in md_files:
        text = f.read_text(encoding="utf-8")
        source_id = f.stem

        # Extract label from link context line (text after — )
        for line in text.splitlines():
            matches = LINK_RE.findall(line)
            # Extract relation label from "— relation text" after the link
            relation_match = re.search(r"\]\]\s*[—-]+\s*(.+)", line)
            relation = relation_match.group(1).strip()[:80] if relation_match else "links"

            for slug in matches:
                # Resolve target
                target_id = slug_index.get(slug) or slug_index.get(slug.split("-")[0])
                if not target_id or target_id == source_id:
                    continue
                if target_id not in nodes:
                    continue
                key = (source_id, target_id)
                if key in seen_edges:
                    continue
                seen_edges.add(key)
                edges.append({
                    "source": source_id,
                    "target": target_id,
                    "relation": relation,
                    "key": 0,
                })

    node_list = list(nodes.values())

    graph_data = {
        "directed": True,
        "multigraph": False,
        "graph": {"theme": theme},
        "nodes": node_list,
        "links": edges,
    }

    output_dir.mkdir(parents=True, exist_ok=True)
    graph_path = output_dir / "graph.json"
    graph_path.write_text(json.dumps(graph_data, ensure_ascii=False, indent=2), encoding="utf-8")

    print(f"[build_graph] {len(node_list)} nodes, {len(edges)} edges")
    print(f"[build_graph] graph.json → {graph_path}")
    return graph_data


if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("--theme", default="maintenance")
    parser.add_argument("--output", default="_GRAPHITY/")
    args = parser.parse_args()

    build_graph(args.theme, Path(args.output) / args.theme)
O resultado no tema marketing
O tema marketing do meu wiki é alimentado por uns vinte livros: Dunford, Seth Godin, Cialdini, Moore, Ries e Trout, Nagle, Byron Sharp, Rob Fitzpatrick…
| Medida | Valor |
|---|---|
| Notas | 1 013 |
| Links | 6 442 |
| Grupos de notas detectados | 22 |
| Tempo de construção do grafo | 0,2 segundo |
| Tokens de IA consumidos | 0 |
O mapa e seus grupos de notas
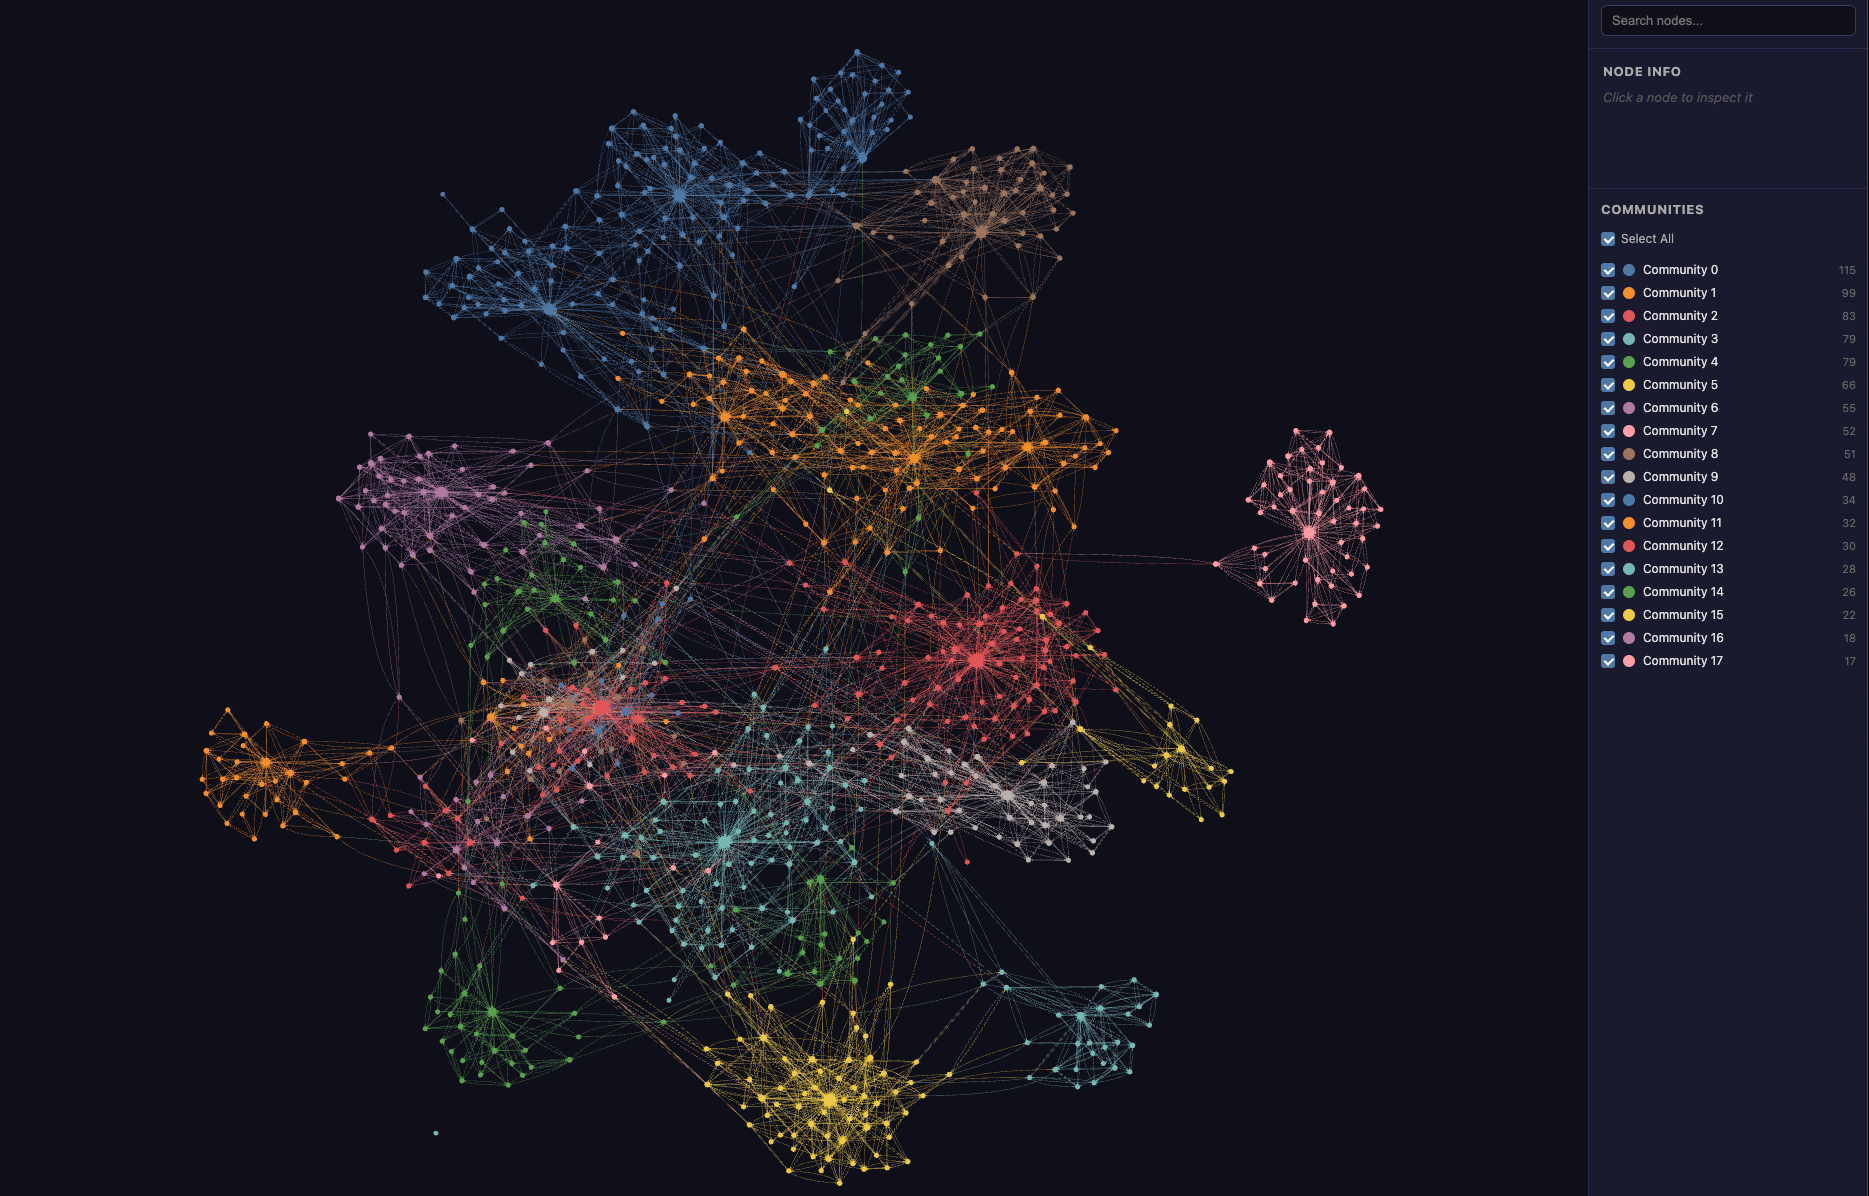
O Graphify divide o grafo em grupos de notas mais ligadas entre si do que com o resto. Alguns grupos encontrados no tema marketing:
- Um grupo de 53 notas em torno do Mom Test: as conversas com clientes, os elogios que não valem nada, os fatos passados em vez das promessas.
- Um grupo de 52 notas sobre influência: os seis princípios de Cialdini, a reciprocidade, o contraste perceptivo, o "porque" que dispara a obediência.
- Um grupo de 46 notas sobre o chasm: o abismo entre os early adopters e a maioria pragmática, a estratégia do pino de boliche.
- Um grupo de 26 notas sobre customer success: o churn como espiral mortal, a diferença entre customer success e suporte.
O relatório também identifica as notas mais conectadas. As dez primeiras são todas mapas de leitura: o de Obviously Awesome, da Dunford, fica em primeiro com 180 links, à frente de This is Marketing, do Seth Godin, com 156.
Por fim, ele aponta as notas isoladas. Uma só em 1 013: uma nota sobre persona de marketing, que nada liga ao resto. É um buraco no wiki, encontrado de graça.
As conexões de uma nota
Pedimos ao Graphify que explique a nota de glossário sobre o chasm:
graphify explain "GLO00618-chasm"
Ele responde com as 30 conexões da nota, nas duas direções, e a relação de cada uma. Um trecho:
| Direção | Nota ligada | Relação escrita na nota |
|---|---|---|
| ← | Mapa de leitura de Crossing the Chasm | o abismo central do modelo |
| → | Ciclo de adoção de tecnologia | quadro em que o chasm se insere |
| → | Os early adopters buscam uma vantagem radical, a maioria uma melhoria gradual | explica a causa psicográfica do chasm |
| ← | Produto completo (whole product) | o chasm é em parte causado pela ausência de produto completo |
| ← | Bowling alley | começa depois da travessia do chasm |
| → | O abismo de Moore separa os early adopters do mercado de massa | mesma ideia, vinda de Seth Godin citando Moore |
→: o chasm cita esta nota. ←: esta nota cita o chasm.
A última linha é a mais interessante. O chasm vem de Geoffrey Moore, mas Seth Godin também fala dele em outro livro. O grafo mostra que as duas fontes se encontram na mesma ideia.
O caminho entre duas ideias distantes
O que liga a regra da reciprocidade de Cialdini, um princípio de psicologia social, ao churn num negócio de assinatura?
graphify path \
  "ATO01269-la-regle-de-reciprocite..." \
  "ATO01404-dans-un-business-de-revenus-recurrents-le-churn..."
O Graphify encontra um caminho de 8 etapas:
- A regra da reciprocidade é universal e sustenta a cooperação humana
- → o mapa de leitura de Influence (Cialdini)
- → O compromisso inicial muda a autoimagem e produz uma coerência automática
- → O risco alto gera confiança; baixar o preço a diminui
- → próximo de: um preço alto sinaliza qualidade e sustenta a confiança → O efeito preço-qualidade faz um preço alto ser percebido como sinal de qualidade
- → o mapa de leitura de The Strategy and Tactics of Pricing (Nagle)
- → O custo de troca reduz a sensibilidade ao preço → converge: os switching costs são uma alavanca importante de retenção → A retenção é o multiplicador de crescimento mais poderoso
- → convergência com a tese de Customer Success: o churn destrói o crescimento → Num negócio recorrente, o churn é uma espiral mortal
O caminho conta uma história: da psicologia do compromisso ao preço como sinal de confiança, e depois do custo de troca à retenção. Ninguém escreveu esse raciocínio de uma vez. Ele surge dos links criados nota após nota, livro após livro.
O que isso traz a mais que a visão de grafo do Obsidian
A visão de grafo do Obsidian desenha os links. O Graphify, além disso:
- detecta os grupos de notas automaticamente;
- dá nome às relações, retomando a explicação escrita na nota;
- encontra o caminho mais curto entre duas notas;
- produz um relatório: notas centrais, notas isoladas, conexões inesperadas;
- roda na linha de comando, então o próprio Claude pode consultá-lo enquanto trabalha no wiki.
Os limites
A busca por pergunta só lê os títulos. O Graphify também tem um comando de busca livre. Ele procura as palavras da pergunta no nome das notas, não no conteúdo, e depois amplia para as notas vizinhas. Se a pergunta não usa as palavras do título, ele não encontra nada.
Os grupos seguem os livros mais do que os conceitos. O posicionamento, por exemplo, aparece espalhado em cinco grupos, basicamente conforme o livro de origem: Dunford de um lado, Ries e Trout do outro. Os mapas de leitura por livro concentram tantos links que estruturam o grafo inteiro. O mesmo efeito aparece nos caminhos: o que vai do chasm à disposição a pagar passa por três mapas de leitura, o que é verdade, mas ensina pouco.
Os grupos não têm nome. O Graphify pode nomeá-los com uma IA, mas isso traria de volta o custo que eu queria evitar. Eles se chamam, portanto, "Community 0", "Community 1"… e cabe a mim interpretá-los.
O Graphify continua sendo uma ferramenta para código. A cada construção, ele emite 12 884 avisos: os links não têm "arquivo de origem", uma noção que só faz sentido para código. Isso não traz consequências, mas lembra que estamos usando a ferramenta fora do uso previsto.
O grafo só vale o que valem os links. Um link sem explicação vira uma relação "links" muda. Uma nota mal ligada continua isolada. O grafo não corrige nada, ele mostra.
Como reproduzir em casa
Você precisa de um conjunto de notas em Markdown ligadas por links [[...]]:
- ou um cofre do Obsidian que você mesmo vai ligando;
- ou um wiki mantido por uma IA, como o descrito neste artigo.
O script acima pressupõe identificadores do tipo ATO00001-slug e uma árvore de pastas por tema. Adapte a expressão regular dos links e a pasta das notas à sua própria organização.
Depois, três comandos:
pip install graphifyy

python build_graph.py --theme marketing --output _GRAPHITY/

graphify cluster-only _GRAPHITY/marketing/ --no-label \
  --graph _GRAPHITY/marketing/graph.json
O mapa interativo fica então em _GRAPHITY/marketing/graphify-out/graph.html, e o relatório em GRAPH_REPORT.md, ao lado. Os comandos explain e path funcionam direto sobre o arquivo graph.json.
A IA não tinha nada a adivinhar. Bastava ler o que já tínhamos escrito.