Scritto originalmente in francese. Tradotto dall'IA — il significato è stato preservato, non la prosa.
Graphify è uno strumento pensato per mappare il codice pagando un'IA perché legga ogni file. Io l'ho riadattato per mappare il mio wiki di conoscenze, senza IA e senza chiave API. Un solo file Python di 160 righe, 0,2 secondi di calcolo, e mille note diventano un grafo che puoi esplorare, interrogare e percorrere.
Mille note sul marketing. Note atomiche, definizioni di glossario, mappe di lettura per libro. Tutte collegate tra loro, e ogni collegamento spiega perché esiste.
Eppure è impossibile vedere la forma d'insieme. Impossibile rispondere in modo semplice a domande come: cosa lega la reciprocità di Cialdini al churn di un SaaS? Quali note stanno al centro del tema, e quali sono isolate?
La vista grafo di Obsidian mostra un gomitolo di lana. Bello, ma muto.
In questo articolo racconto come ho ottenuto un grafo davvero utilizzabile di questo wiki riadattando Graphify, uno strumento pensato per il codice, e cosa mi ha insegnato quel grafo sulla mia base.
Il punto di partenza: un wiki in cui i collegamenti hanno un senso
Ho già raccontato perché ho costruito una base di conoscenza mantenuta da un'IA. Il principio: do libri e documenti a Claude, che ne estrae note atomiche, voci di glossario e altri tipi di schede, e poi le collega tra loro.
Per quello che segue, una regola conta più di tutte le altre: un collegamento non deve mai essere decorativo. Ogni collegamento è seguito da una breve frase che spiega la relazione.
- [[GLO00614-marche-minimal-viable]] — il MVMarket è la strategia
  per attraversare il chasm, non il chasm in sé.
- [[GLO00619-technology-adoption-life-cycle]] — quadro in cui
  si colloca il chasm.
In altre parole, le relazioni tra le idee sono già scritte, nero su bianco, dentro le note. È questo dettaglio a rendere possibile tutto il resto.
Che cos'è Graphify?
Graphify trasforma una cartella di codice o di documenti in un grafo della conoscenza, che puoi poi interrogare da un assistente come Claude Code.
Funziona in due tempi.
- La costruzione. Graphify fa leggere ogni file a un'IA, che ne deduce gli elementi importanti e le relazioni tra loro. È la fase costosa: consuma token, e il risultato cambia da un'esecuzione all'altra.
- L'esplorazione. Una volta costruito il grafo, Graphify lo suddivide in gruppi di nodi vicini, genera una mappa interattiva e un report, e risponde a domande: quali sono le connessioni di un certo elemento, quale percorso collega A a B.
L'idea: un uso alternativo
Su un repository di codice, la fase di costruzione ha senso: nessuno ha scritto nero su bianco che una certa funzione ne chiama un'altra, bisogna dedurlo.
Sul mio wiki è il contrario. L'IA non avrebbe niente da indovinare. Le relazioni ci sono già, scritte a mano o convalidate al momento dell'ingestione. Pagare un'IA per riscoprirle sarebbe costoso, lento e meno fedele di ciò che è già scritto.
Così ho sostituito la costruzione con un piccolo script fatto in casa, e ho tenuto tutto il resto di Graphify.
Note del wiki (.md)
      │
      │  script fatto in casa: legge i collegamenti [[...]] e la loro spiegazione
      ▼
graph.json  (formato standard NetworkX)
      │
      │  Graphify: gruppi, mappa, report, domande
      ▼
graph.html · GRAPH_REPORT.md · explain · path · query
Ciò che rende possibile questo uso alternativo: Graphify accetta qualsiasi grafo nel formato standard della libreria NetworkX. Non controlla da dove arrivi quel grafo. Basta passarglielo.
Sotto il cofano: un solo file
Lo script fa tre cose.
1. Censire le note. Ogni file Markdown diventa un nodo. Il suo identificativo è il nome del file, e il suo tipo si ricava dal prefisso: ATO per una nota atomica, GLO per il glossario, MOC per una mappa di lettura, e così via.
2. Individuare i collegamenti. Un'espressione regolare trova ogni [[ID-slug]] nel testo. Se la nota di destinazione esiste, viene creato un collegamento.
3. Dare un nome alla relazione. Il testo scritto dopo il trattino che segue il collegamento diventa il nome della relazione. È questo che permette a Graphify di mostrare «il MVMarket è la strategia per attraversare il chasm» invece di un semplice «collegamento».
for line in text.splitlines():
    matches = LINK_RE.findall(line)
    relation_match = re.search(r"\]\]\s*[—-]+\s*(.+)", line)
    relation = relation_match.group(1).strip()[:80] if relation_match else "links"
Nessuna libreria da installare: lo script usa solo moduli forniti con Python. Ecco il file completo.
"""
Build graph.json from Obsidian [[links]] in wiki notes — no LLM needed.
Output format: NetworkX node_link_graph (compatible with graphify path/explain/query).

Usage:
    .venv/bin/python scripts/build_graph.py [--theme maintenance] [--output _GRAPHITY/]
"""

import argparse
import json
import re
import uuid
from pathlib import Path

WIKI_ROOT = Path(__file__).resolve().parent.parent.parent.parent / "wiki"
LINK_RE = re.compile(r"\[\[([A-Z]{2,3}\d{5}-[^\]\|]+?)(?:\|[^\]]*)?\]\]")
FRONTMATTER_RE = re.compile(r"^---\n(.*?)\n---", re.DOTALL)

TYPE_MAP = {
    "ATO": "atomic_note",
    "GLO": "glossary_term",
    "NOR": "norm_reference",
    "EXN": "normative_requirement",
    "PRO": "business_process",
    "OBJ": "domain_object",
    "BRL": "business_rule",
    "REG": "regulatory_text",
    "HAB": "habilitation",
    "IND": "indicator",
    "MOC": "moc",
    "SRC": "source_record",
}


def parse_frontmatter(text: str) -> dict:
    m = FRONTMATTER_RE.match(text)
    if not m:
        return {}
    result = {}
    for line in m.group(1).splitlines():
        if ":" in line:
            k, _, v = line.partition(":")
            result[k.strip()] = v.strip().strip('"')
    return result


def slug_to_id(slug: str) -> str:
    """Extract the ID prefix (e.g. 'ATO00001') from a slug like 'ATO00001-some-title'."""
    parts = slug.split("-", 1)
    return parts[0].upper()


def build_graph(theme: str, output_dir: Path) -> dict:
    notes_root = WIKI_ROOT / "themes" / theme / "notes"
    if not notes_root.exists():
        raise SystemExit(f"Notes directory not found: {notes_root}")

    nodes = {}   # node_id -> node dict
    edges = []   # list of {source, target, relation}

    md_files = list(notes_root.rglob("*.md"))
    md_files = [f for f in md_files if f.name != "README.md"]

    # Index: slug -> node_id (file stem without extension)
    slug_index = {}
    for f in md_files:
        stem = f.stem  # e.g. ATO00001-some-title
        slug_index[stem] = stem
        # Also index by bare ID (ATO00001) for robustness
        bare_id = stem.split("-")[0]
        slug_index.setdefault(bare_id, stem)

    print(f"[build_graph] {len(md_files)} notes found in {notes_root}")

    for f in md_files:
        text = f.read_text(encoding="utf-8")
        fm = parse_frontmatter(text)

        node_id = f.stem
        prefix = node_id[:3].upper()
        node_type = TYPE_MAP.get(prefix, "note")
        title = fm.get("title") or fm.get("term") or fm.get("name") or node_id
        subdir = f.parent.name  # e.g. "atomiques", "glossaire"

        nodes[node_id] = {
            "id": node_id,
            # label = slug so graphify path/explain resolve by ID (e.g. "ATO00001-...")
            "label": node_id,
            "title": title,
            # norm_label includes slug tokens for fuzzy matching
            "norm_label": node_id.lower().replace("-", " "),
            "type": node_type,
            "kind": node_type,
            "source_file": str(f.relative_to(WIKI_ROOT.parent)),
            "subdir": subdir,
            "status": fm.get("status", "draft"),
            "uid": fm.get("uid") or str(uuid.uuid4()),
            "wiki_id": fm.get("id", ""),
        }

    # Second pass: extract links
    seen_edges = set()
    for f in md_files:
        text = f.read_text(encoding="utf-8")
        source_id = f.stem

        # Extract label from link context line (text after — )
        for line in text.splitlines():
            matches = LINK_RE.findall(line)
            # Extract relation label from "— relation text" after the link
            relation_match = re.search(r"\]\]\s*[—-]+\s*(.+)", line)
            relation = relation_match.group(1).strip()[:80] if relation_match else "links"

            for slug in matches:
                # Resolve target
                target_id = slug_index.get(slug) or slug_index.get(slug.split("-")[0])
                if not target_id or target_id == source_id:
                    continue
                if target_id not in nodes:
                    continue
                key = (source_id, target_id)
                if key in seen_edges:
                    continue
                seen_edges.add(key)
                edges.append({
                    "source": source_id,
                    "target": target_id,
                    "relation": relation,
                    "key": 0,
                })

    node_list = list(nodes.values())

    graph_data = {
        "directed": True,
        "multigraph": False,
        "graph": {"theme": theme},
        "nodes": node_list,
        "links": edges,
    }

    output_dir.mkdir(parents=True, exist_ok=True)
    graph_path = output_dir / "graph.json"
    graph_path.write_text(json.dumps(graph_data, ensure_ascii=False, indent=2), encoding="utf-8")

    print(f"[build_graph] {len(node_list)} nodes, {len(edges)} edges")
    print(f"[build_graph] graph.json → {graph_path}")
    return graph_data


if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("--theme", default="maintenance")
    parser.add_argument("--output", default="_GRAPHITY/")
    args = parser.parse_args()

    build_graph(args.theme, Path(args.output) / args.theme)
Cosa succede sul tema marketing
Il tema marketing del mio wiki è alimentato da una ventina di libri: Dunford, Seth Godin, Cialdini, Moore, Ries e Trout, Nagle, Byron Sharp, Rob Fitzpatrick…
| Misura | Valore |
|---|---|
| Note | 1 013 |
| Collegamenti | 6 442 |
| Gruppi di note rilevati | 22 |
| Tempo di costruzione del grafo | 0,2 secondi |
| Token di IA consumati | 0 |
La mappa e i suoi gruppi di note
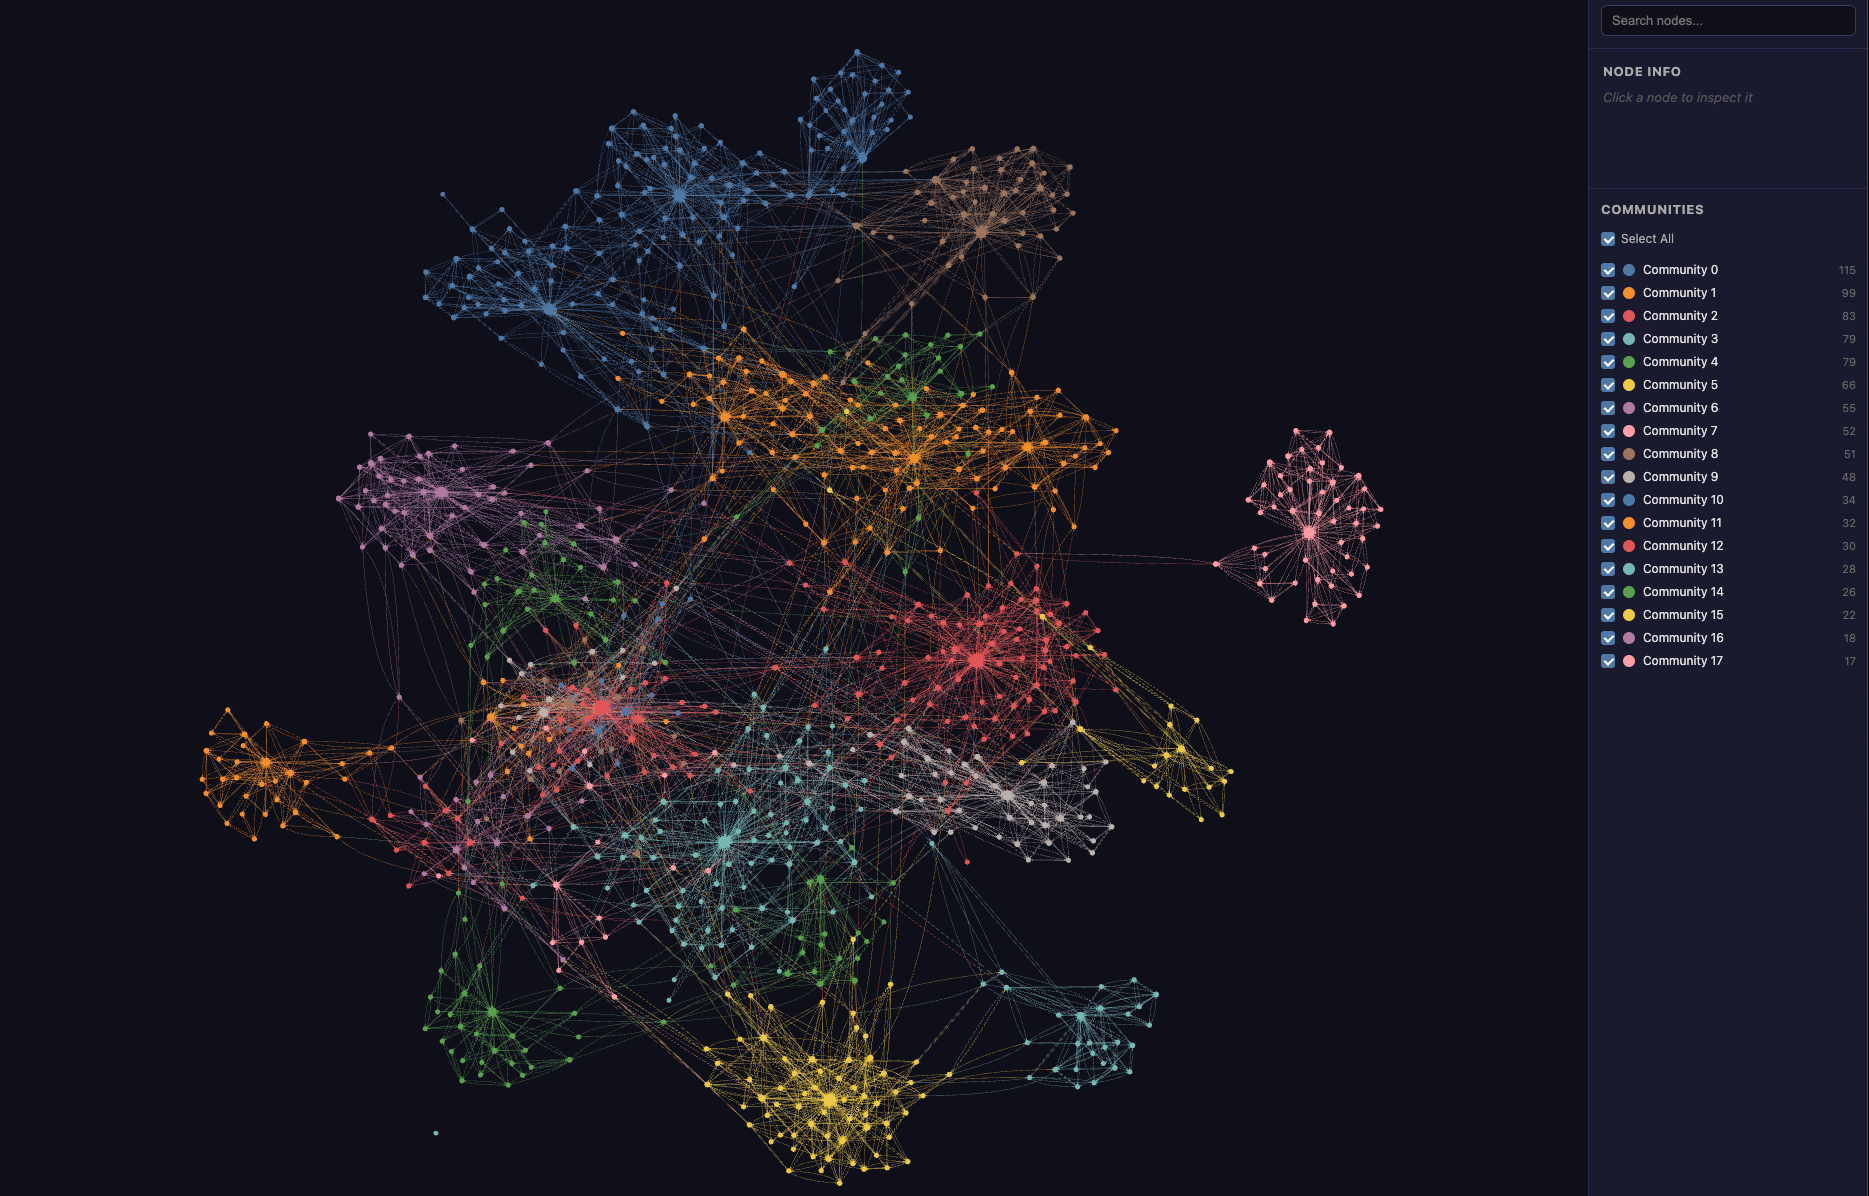
Graphify suddivide il grafo in gruppi di note più collegate tra loro che con il resto. Alcuni gruppi trovati sul tema marketing:
- Un gruppo di 53 note attorno al Mom Test: le conversazioni con i clienti, i complimenti che non valgono niente, i fatti passati invece delle promesse.
- Un gruppo di 52 note sull'influenza: i sei principi di Cialdini, la reciprocità, il contrasto percettivo, il «perché» che fa scattare l'obbedienza.
- Un gruppo di 46 note sul chasm: il fossato tra gli early adopter e la maggioranza pragmatica, la strategia del birillo da bowling.
- Un gruppo di 26 note sul customer success: il churn come spirale mortale, la differenza tra customer success e supporto.
Il report individua anche le note più connesse. Le prime dieci sono tutte mappe di lettura: quella di Obviously Awesome di Dunford è in testa con 180 collegamenti, davanti a This is Marketing di Seth Godin con 156.
Infine segnala le note isolate. Una sola su 1 013: una nota sulla persona di marketing, che niente collega al resto. È un buco nel wiki, trovato gratis.
Le connessioni di una nota
Chiediamo a Graphify di spiegare la voce di glossario sul chasm:
graphify explain "GLO00618-chasm"
Risponde con le sue 30 connessioni, in entrambe le direzioni, e la relazione di ciascuna. Un estratto:
| Direzione | Nota collegata | Relazione scritta nella nota |
|---|---|---|
| ← | Mappa di lettura di Crossing the Chasm | il fossato centrale del modello |
| → | Ciclo di adozione tecnologica | quadro in cui si colloca il chasm |
| → | Gli early adopter cercano un vantaggio radicale, la maggioranza un miglioramento graduale | spiega la causa psicografica del chasm |
| ← | Prodotto completo (whole product) | il chasm è causato in parte dall'assenza di un prodotto completo |
| ← | Bowling alley | comincia dopo l'attraversamento del chasm |
| → | Il baratro di Moore separa gli early adopter dal mercato di massa | stessa idea, da Seth Godin che cita Moore |
→: il chasm cita questa nota. ←: questa nota cita il chasm.
L'ultima riga è la più interessante. Il chasm viene da Geoffrey Moore, ma Seth Godin ne parla anche in un altro libro. Il grafo mostra che le due fonti convergono sulla stessa idea.
Il percorso tra due idee lontane
Cosa lega la regola della reciprocità di Cialdini, un principio di psicologia sociale, al churn in un business ad abbonamento?
graphify path \
  "ATO01269-la-regle-de-reciprocite..." \
  "ATO01404-dans-un-business-de-revenus-recurrents-le-churn..."
Graphify trova un percorso in 8 tappe:
- La regola della reciprocità è universale e fonda la cooperazione umana
- → la mappa di lettura di Influence (Cialdini)
- → L'impegno iniziale modifica l'immagine di sé e produce una coerenza automatica
- → Il rischio elevato costruisce la fiducia; abbassare il prezzo la riduce
- → vicino a: un prezzo elevato segnala qualità e sostiene la fiducia → L'effetto prezzo-qualità fa percepire un prezzo elevato come segnale di qualità
- → la mappa di lettura di The Strategy and Tactics of Pricing (Nagle)
- → Il costo di cambiamento riduce la sensibilità al prezzo → converge: gli switching cost sono una leva importante di retention → La retention è il moltiplicatore di crescita più potente
- → convergenza con la tesi del Customer Success: il churn distrugge la crescita → In un business ricorrente, il churn è una spirale mortale
Il percorso racconta una storia: dalla psicologia dell'impegno al prezzo come segnale di fiducia, poi dal costo di cambiamento alla retention. Nessuno ha scritto questo ragionamento tutto d'un pezzo. Emerge dai collegamenti aggiunti nota dopo nota, libro dopo libro.
Cosa aggiunge rispetto alla vista grafo di Obsidian
La vista grafo di Obsidian disegna i collegamenti. Graphify, in più:
- rileva i gruppi di note in automatico;
- dà un nome alle relazioni, riprendendo la spiegazione scritta nella nota;
- trova il percorso più breve tra due note;
- produce un report: note centrali, note isolate, connessioni inattese;
- si usa da riga di comando, quindi Claude può interrogarlo da solo mentre lavora sul wiki.
I limiti
La ricerca per domanda legge solo i titoli. Graphify ha anche un comando di ricerca libera. Cerca le parole della domanda nel nome delle note, non nel loro contenuto, poi allarga alle note vicine. Se la domanda non usa le parole del titolo, non trova niente.
I gruppi seguono i libri più dei concetti. Il posizionamento, per esempio, è spezzato in cinque gruppi, soprattutto in base al libro d'origine: Dunford da una parte, Ries e Trout dall'altra. Le mappe di lettura per libro concentrano così tanti collegamenti da strutturare l'intero grafo. Stesso effetto sui percorsi: quello tra il chasm e la disponibilità a pagare passa per tre mappe di lettura, il che è vero ma poco istruttivo.
I gruppi non hanno un nome. Graphify può assegnarglielo con un'IA, ma vorrebbe dire reintrodurre il costo che volevo evitare. Si chiamano quindi «Community 0», «Community 1»… e tocca a me interpretarli.
Graphify resta uno strumento per il codice. A ogni costruzione segnala 12 884 avvisi: i collegamenti non hanno un «file sorgente», una nozione che ha senso solo per il codice. Non ha conseguenze, ma ricorda che stai usando lo strumento fuori dall'uso per cui è stato pensato.
Il grafo vale quanto valgono i collegamenti. Un collegamento senza spiegazione diventa una relazione «links» muta. Una nota collegata male resta isolata. Il grafo non corregge niente, mostra.
Riprodurlo da te
Ti serve un insieme di note in Markdown unite da collegamenti [[...]]:
- o un vault Obsidian che colleghi tu stesso;
- o un wiki mantenuto da un'IA, come quello descritto in questo articolo.
Lo script qui sopra presuppone identificativi del tipo ATO00001-slug e una struttura di cartelle per tema. Devi adattare l'espressione regolare dei collegamenti e la cartella delle note alla tua organizzazione.
Poi, tre comandi:
pip install graphifyy

python build_graph.py --theme marketing --output _GRAPHITY/

graphify cluster-only _GRAPHITY/marketing/ --no-label \
  --graph _GRAPHITY/marketing/graph.json
A quel punto la mappa interattiva si trova in _GRAPHITY/marketing/graphify-out/graph.html, e il report in GRAPH_REPORT.md accanto. I comandi explain e path funzionano direttamente sul file graph.json.
L'IA non aveva niente da indovinare. Bastava leggere ciò che avevamo già scritto.