Escrito originalmente en francés. Traducido por IA — se ha preservado el sentido, no la prosa.
Graphify es una herramienta pensada para cartografiar código pagando a una IA para que lea cada archivo. Yo la he reaprovechado para cartografiar mi wiki de conocimiento, sin IA y sin clave de API. Un único archivo Python de 160 líneas, 0,2 segundos de cálculo, y mil notas se convierten en un grafo que puedes explorar, consultar y recorrer.
Mil notas sobre marketing. Notas atómicas, definiciones de glosario, mapas de lectura por libro. Todas enlazadas entre sí, y cada enlace explica por qué existe.
Y aun así, imposible ver la forma del conjunto. Imposible responder con sencillez a preguntas como: ¿qué une la reciprocidad de Cialdini con el churn de un SaaS? ¿Qué notas están en el centro del tema y cuáles están aisladas?
La vista de grafo de Obsidian muestra un ovillo de lana. Bonito, pero mudo.
Este artículo cuenta cómo obtuve un grafo útil de este wiki reaprovechando Graphify, una herramienta pensada para el código, y lo que ese grafo me enseñó sobre mi propia base.
El punto de partida: un wiki donde los enlaces tienen sentido
Ya conté por qué construí una base de conocimiento mantenida por una IA. El principio: le doy libros y documentos a Claude, que extrae de ellos notas atómicas, entradas de glosario y otros tipos de fichas, y después las enlaza entre sí.
Para lo que sigue, una regla cuenta más que todas las demás: un enlace nunca debe ser decorativo. Cada enlace va seguido de una frase corta que explica la relación.
- [[GLO00614-marche-minimal-viable]] — el MVMarket es la estrategia
  para cruzar el chasm, no el chasm en sí.
- [[GLO00619-technology-adoption-life-cycle]] — marco en el que
  se inscribe el chasm.
Dicho de otro modo, las relaciones entre las ideas ya están escritas, negro sobre blanco, en las notas. Ese detalle es lo que hace posible todo lo demás.
¿Qué es Graphify?
Graphify convierte una carpeta de código o de documentos en un grafo de conocimiento, que después puedes consultar desde un asistente como Claude Code.
Funciona en dos fases.
- La construcción. Graphify hace que una IA lea cada archivo y deduzca de él los elementos importantes y las relaciones entre ellos. Es el paso caro: consume tokens, y el resultado cambia de una ejecución a otra.
- La exploración. Una vez construido el grafo, Graphify lo divide en grupos de nodos cercanos, genera un mapa interactivo y un informe, y responde a preguntas: cuáles son las conexiones de tal elemento, qué camino une A con B.
La idea del reaprovechamiento
En un repositorio de código, el paso de construcción tiene sentido: nadie ha escrito negro sobre blanco que tal función llama a tal otra, hay que deducirlo.
En mi wiki ocurre lo contrario. La IA no tendría nada que adivinar. Las relaciones ya están ahí, escritas a mano o validadas en el momento de la ingesta. Pagar a una IA para que las redescubra sería caro, lento y menos fiel que lo que ya está escrito.
Así que sustituí la construcción por un pequeño script propio y me quedé con todo lo demás de Graphify.
Notas del wiki (.md)
      │
      │  script propio: lee los enlaces [[...]] y su explicación
      ▼
graph.json  (formato estándar NetworkX)
      │
      │  Graphify: grupos, mapa, informe, preguntas
      ▼
graph.html · GRAPH_REPORT.md · explain · path · query
Lo que hace posible el reaprovechamiento: Graphify acepta cualquier grafo en el formato estándar de la librería NetworkX. No comprueba de dónde viene ese grafo. Basta con dárselo.
Bajo el capó: un solo archivo
El script hace tres cosas.
1. Inventariar las notas. Cada archivo Markdown se convierte en un nodo. Su identificador es el nombre del archivo, y su tipo se deduce del prefijo: ATO para una nota atómica, GLO para el glosario, MOC para un mapa de lectura, etc.
2. Localizar los enlaces. Una expresión regular encuentra cada [[ID-slug]] en el texto. Si la nota de destino existe, se crea un enlace.
3. Dar nombre a la relación. El texto escrito después del guion que sigue al enlace se convierte en el nombre de la relación. Es lo que permite que Graphify muestre "el MVMarket es la estrategia para cruzar el chasm" en lugar de un simple "enlace".
for line in text.splitlines():
    matches = LINK_RE.findall(line)
    relation_match = re.search(r"\]\]\s*[—-]+\s*(.+)", line)
    relation = relation_match.group(1).strip()[:80] if relation_match else "links"
No hay ninguna librería que instalar: el script solo usa módulos que vienen con Python. Este es el archivo completo.
"""
Build graph.json from Obsidian [[links]] in wiki notes — no LLM needed.
Output format: NetworkX node_link_graph (compatible with graphify path/explain/query).

Usage:
    .venv/bin/python scripts/build_graph.py [--theme maintenance] [--output _GRAPHITY/]
"""

import argparse
import json
import re
import uuid
from pathlib import Path

WIKI_ROOT = Path(__file__).resolve().parent.parent.parent.parent / "wiki"
LINK_RE = re.compile(r"\[\[([A-Z]{2,3}\d{5}-[^\]\|]+?)(?:\|[^\]]*)?\]\]")
FRONTMATTER_RE = re.compile(r"^---\n(.*?)\n---", re.DOTALL)

TYPE_MAP = {
    "ATO": "atomic_note",
    "GLO": "glossary_term",
    "NOR": "norm_reference",
    "EXN": "normative_requirement",
    "PRO": "business_process",
    "OBJ": "domain_object",
    "BRL": "business_rule",
    "REG": "regulatory_text",
    "HAB": "habilitation",
    "IND": "indicator",
    "MOC": "moc",
    "SRC": "source_record",
}


def parse_frontmatter(text: str) -> dict:
    m = FRONTMATTER_RE.match(text)
    if not m:
        return {}
    result = {}
    for line in m.group(1).splitlines():
        if ":" in line:
            k, _, v = line.partition(":")
            result[k.strip()] = v.strip().strip('"')
    return result


def slug_to_id(slug: str) -> str:
    """Extract the ID prefix (e.g. 'ATO00001') from a slug like 'ATO00001-some-title'."""
    parts = slug.split("-", 1)
    return parts[0].upper()


def build_graph(theme: str, output_dir: Path) -> dict:
    notes_root = WIKI_ROOT / "themes" / theme / "notes"
    if not notes_root.exists():
        raise SystemExit(f"Notes directory not found: {notes_root}")

    nodes = {}   # node_id -> node dict
    edges = []   # list of {source, target, relation}

    md_files = list(notes_root.rglob("*.md"))
    md_files = [f for f in md_files if f.name != "README.md"]

    # Index: slug -> node_id (file stem without extension)
    slug_index = {}
    for f in md_files:
        stem = f.stem  # e.g. ATO00001-some-title
        slug_index[stem] = stem
        # Also index by bare ID (ATO00001) for robustness
        bare_id = stem.split("-")[0]
        slug_index.setdefault(bare_id, stem)

    print(f"[build_graph] {len(md_files)} notes found in {notes_root}")

    for f in md_files:
        text = f.read_text(encoding="utf-8")
        fm = parse_frontmatter(text)

        node_id = f.stem
        prefix = node_id[:3].upper()
        node_type = TYPE_MAP.get(prefix, "note")
        title = fm.get("title") or fm.get("term") or fm.get("name") or node_id
        subdir = f.parent.name  # e.g. "atomiques", "glossaire"

        nodes[node_id] = {
            "id": node_id,
            # label = slug so graphify path/explain resolve by ID (e.g. "ATO00001-...")
            "label": node_id,
            "title": title,
            # norm_label includes slug tokens for fuzzy matching
            "norm_label": node_id.lower().replace("-", " "),
            "type": node_type,
            "kind": node_type,
            "source_file": str(f.relative_to(WIKI_ROOT.parent)),
            "subdir": subdir,
            "status": fm.get("status", "draft"),
            "uid": fm.get("uid") or str(uuid.uuid4()),
            "wiki_id": fm.get("id", ""),
        }

    # Second pass: extract links
    seen_edges = set()
    for f in md_files:
        text = f.read_text(encoding="utf-8")
        source_id = f.stem

        # Extract label from link context line (text after — )
        for line in text.splitlines():
            matches = LINK_RE.findall(line)
            # Extract relation label from "— relation text" after the link
            relation_match = re.search(r"\]\]\s*[—-]+\s*(.+)", line)
            relation = relation_match.group(1).strip()[:80] if relation_match else "links"

            for slug in matches:
                # Resolve target
                target_id = slug_index.get(slug) or slug_index.get(slug.split("-")[0])
                if not target_id or target_id == source_id:
                    continue
                if target_id not in nodes:
                    continue
                key = (source_id, target_id)
                if key in seen_edges:
                    continue
                seen_edges.add(key)
                edges.append({
                    "source": source_id,
                    "target": target_id,
                    "relation": relation,
                    "key": 0,
                })

    node_list = list(nodes.values())

    graph_data = {
        "directed": True,
        "multigraph": False,
        "graph": {"theme": theme},
        "nodes": node_list,
        "links": edges,
    }

    output_dir.mkdir(parents=True, exist_ok=True)
    graph_path = output_dir / "graph.json"
    graph_path.write_text(json.dumps(graph_data, ensure_ascii=False, indent=2), encoding="utf-8")

    print(f"[build_graph] {len(node_list)} nodes, {len(edges)} edges")
    print(f"[build_graph] graph.json → {graph_path}")
    return graph_data


if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("--theme", default="maintenance")
    parser.add_argument("--output", default="_GRAPHITY/")
    args = parser.parse_args()

    build_graph(args.theme, Path(args.output) / args.theme)
Resultados con el tema de marketing
El tema de marketing de mi wiki se alimenta de una veintena de libros: Dunford, Seth Godin, Cialdini, Moore, Ries y Trout, Nagle, Byron Sharp, Rob Fitzpatrick…
| Medida | Valor |
|---|---|
| Notas | 1013 |
| Enlaces | 6442 |
| Grupos de notas detectados | 22 |
| Tiempo de construcción del grafo | 0,2 segundos |
| Tokens de IA consumidos | 0 |
El mapa y sus grupos de notas
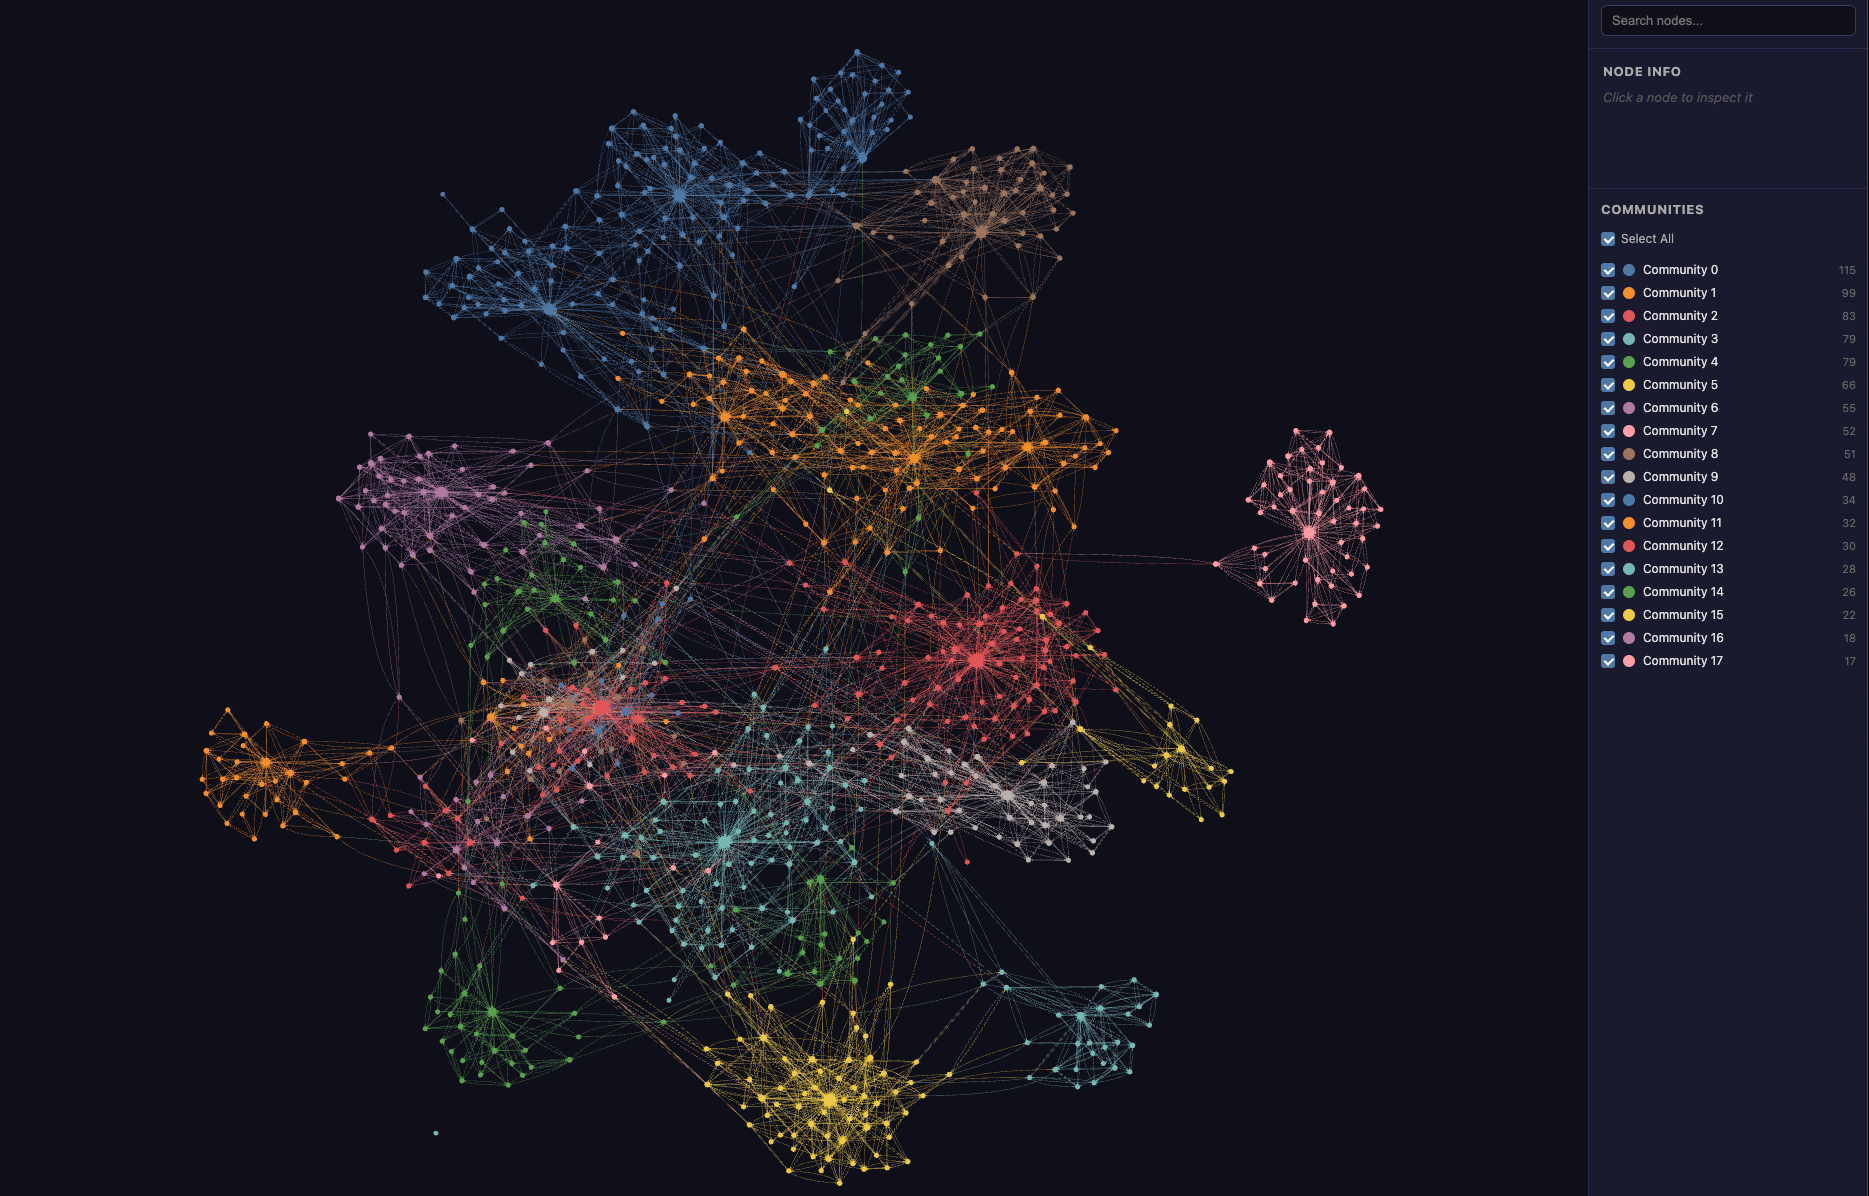
Graphify divide el grafo en grupos de notas más enlazadas entre sí que con el resto. Algunos grupos encontrados en el tema de marketing:
- Un grupo de 53 notas en torno al Mom Test: las conversaciones con clientes, los cumplidos que no valen nada, los hechos pasados en lugar de las promesas.
- Un grupo de 52 notas sobre la influencia: los seis principios de Cialdini, la reciprocidad, el contraste perceptivo, el "porque" que desencadena la obediencia.
- Un grupo de 46 notas sobre el chasm: la brecha entre los early adopters y la mayoría pragmática, la estrategia del bowling alley.
- Un grupo de 26 notas sobre el customer success: el churn como espiral mortal, la diferencia entre customer success y soporte.
El informe identifica también las notas más conectadas. Las diez primeras son todas mapas de lectura: el de Obviously Awesome de Dunford va en cabeza con 180 enlaces, por delante de This is Marketing de Seth Godin con 156.
Por último, señala las notas aisladas. Solo una de 1013: una nota sobre el buyer persona, que nada enlaza con el resto. Es un hueco en el wiki, encontrado gratis.
Las conexiones de una nota
Le pedimos a Graphify que explique la nota de glosario sobre el chasm:
graphify explain "GLO00618-chasm"
Responde con sus 30 conexiones, en ambas direcciones, y la relación de cada una. Extracto:
| Dirección | Nota enlazada | Relación escrita en la nota |
|---|---|---|
| ← | Mapa de lectura de Crossing the Chasm | la brecha central del modelo |
| → | Ciclo de adopción tecnológica | marco en el que se inscribe el chasm |
| → | Los early adopters buscan una ventaja radical; la mayoría, una mejora progresiva | explica la causa psicográfica del chasm |
| ← | Producto completo (whole product) | el chasm se debe en parte a la ausencia de un producto completo |
| ← | Bowling alley | empieza después de cruzar el chasm |
| → | El abismo de Moore separa a los early adopters del mercado de masas | misma idea, procedente de Seth Godin citando a Moore |
→: el chasm cita esta nota. ←: esta nota cita el chasm.
La última fila es la más interesante. El chasm viene de Geoffrey Moore, pero Seth Godin también habla de él en otro libro. El grafo muestra que las dos fuentes coinciden en la misma idea.
El camino entre dos ideas lejanas
¿Qué tiene que ver la regla de reciprocidad de Cialdini, un principio de psicología social, con el churn en un negocio de suscripción?
graphify path \
  "ATO01269-la-regle-de-reciprocite..." \
  "ATO01404-dans-un-business-de-revenus-recurrents-le-churn..."
Graphify encuentra un camino de 8 pasos:
- La regla de reciprocidad es universal y fundamenta la cooperación humana
- → el mapa de lectura de Influence (Cialdini)
- → El compromiso inicial modifica la imagen de uno mismo y produce una coherencia automática
- → El riesgo elevado genera confianza; bajar el precio la reduce
- → cercano a: un precio alto señala calidad y sostiene la confianza → El efecto precio-calidad hace percibir un precio alto como una señal de calidad
- → el mapa de lectura de The Strategy and Tactics of Pricing (Nagle)
- → El coste de cambio reduce la sensibilidad al precio → converge: los switching costs son una palanca clave de retención → La retención es el multiplicador de crecimiento más potente
- → convergencia con la tesis del Customer Success: el churn destruye el crecimiento → En un negocio recurrente, el churn es una espiral mortal
El camino cuenta una historia: de la psicología del compromiso al precio como señal de confianza, y después del coste de cambio a la retención. Nadie escribió ese razonamiento de una sola vez. Surge de los enlaces puestos nota tras nota, libro tras libro.
Lo que aporta frente a la vista de grafo de Obsidian
La vista de grafo de Obsidian dibuja los enlaces. Graphify, además:
- detecta los grupos de notas automáticamente;
- da nombre a las relaciones, retomando la explicación escrita en la nota;
- encuentra el camino más corto entre dos notas;
- genera un informe: notas centrales, notas aisladas, conexiones inesperadas;
- se usa desde la línea de comandos, así que Claude puede consultarlo por su cuenta mientras trabaja en el wiki.
Los límites
La búsqueda por pregunta solo lee los títulos. Graphify tiene también un comando de búsqueda libre. Busca las palabras de la pregunta en el nombre de las notas, no en su contenido, y después amplía a las notas vecinas. Si la pregunta no usa las palabras del título, no encuentra nada.
Los grupos siguen a los libros más que a los conceptos. El posicionamiento, por ejemplo, queda repartido en cinco grupos, sobre todo según el libro de origen: Dunford por un lado, Ries y Trout por otro. Los mapas de lectura por libro concentran tantos enlaces que estructuran todo el grafo. El mismo efecto se nota en los caminos: el que va del chasm a la disposición a pagar pasa por tres mapas de lectura, lo cual es cierto pero poco instructivo.
Los grupos no tienen nombre. Graphify puede nombrarlos con una IA, pero eso sería reintroducir el coste que quería evitar. Así que se llaman "Community 0", "Community 1"… y me toca a mí interpretarlos.
Graphify sigue siendo una herramienta para código. En cada construcción emite 12 884 avisos: los enlaces no tienen "archivo fuente", una noción que solo tiene sentido para el código. No tiene consecuencias, pero recuerda que estamos usando la herramienta fuera del uso para el que fue pensada.
El grafo solo vale lo que valen los enlaces. Un enlace sin explicación se convierte en una relación "links" muda. Una nota mal enlazada se queda aislada. El grafo no corrige nada: muestra.
Reproducirlo en casa
Necesitas un conjunto de notas en Markdown enlazadas con enlaces [[...]]:
- o bien un vault de Obsidian que enlazas tú mismo;
- o bien un wiki mantenido por una IA, como el que se describe en este artículo.
El script anterior da por hecho identificadores del tipo ATO00001-slug y una estructura de carpetas por tema. Hay que adaptar la expresión regular de los enlaces y la carpeta de las notas a tu propia organización.
Después, tres comandos:
pip install graphifyy

python build_graph.py --theme marketing --output _GRAPHITY/

graphify cluster-only _GRAPHITY/marketing/ --no-label \
  --graph _GRAPHITY/marketing/graph.json
El mapa interactivo queda entonces en _GRAPHITY/marketing/graphify-out/graph.html, y el informe en GRAPH_REPORT.md, al lado. Los comandos explain y path funcionan directamente sobre el archivo graph.json.
La IA no tenía nada que adivinar. Bastaba con leer lo que ya habíamos escrito.