Escrito originalmente en francés. Traducido por IA — se ha preservado el sentido, no la prosa.
Este tema se desarrolla en mi libro Le Contexte. Para leerlo, descárgalo o cómpralo en Amazon. La edición de Amazon solo está disponible en francés; si deseas una versión en otro idioma, contáctame.
Este artículo es la continuación de «Persiste esto»: sacar una información de ChatGPT hacia un almacenamiento permanente.
En aquel primer apaño descubrí algo bastante sencillo, pero que cambiaba muchas cosas: ChatGPT podía escribir una información en Google Sheets y, por tanto, sacarla de su propia ventana de contexto.
Dicho de otro modo, podía darle una memoria externa persistente.
En ese momento, Google Sheets me servía sobre todo de bandeja de salida.
Luego me hice otra pregunta:
¿bastaba ese mismo mecanismo para hacer funcionar directamente dentro de ChatGPT mi sistema de Contextos?
Por qué quería sacar el Contexto del Mac
Desde hace un tiempo uso Contextos con Codex y Claude Code.
Y cuando hablo de «Contexto» no me refiero simplemente a un historial de conversación ni a un sitio donde guardar unas cuantas notas.
La definición que manejo es mucho más amplia:
Un Contexto es un sistema delimitado por una misión humana, dentro del cual una IA organiza y moviliza lo que se sabe, de dónde se sabe, cómo se relacionan los elementos y en qué punto está el trabajo, para ayudar al humano a alcanzar su objetivo sin volver a empezar de cero. Al hacerlo, el sistema constituye y hace crecer un capital informacional duradero: el conocimiento producido sigue disponible, se enriquece con el tiempo y puede reutilizarse para otros objetivos.
Ya había construido un motor que permitía hacer funcionar ese principio con Codex o Claude Code.
En mi Mac funciona bien.
Desde el móvil también había encontrado una solución: acceder a distancia a Codex, que se ejecuta en el Mac.
Pero tiene una debilidad bastante evidente.
Hace falta que:
- el Mac esté encendido;
- siga conectado a Internet;
- el acceso remoto funcione.
En casa no resulta muy molesto.
Sobre el terreno, mucho más.
El caso que me interesaba especialmente era el de dos ferias profesionales que tenía por delante: pasar una semana solo con el móvil, hablar con los expositores, recoger información, preparar entrevistas y quizá publicar un artículo el mismo día.
No me apetecía depender de un Mac encendido en algún sitio a decenas o centenares de kilómetros.
Así que me pregunté si podía eliminarlo por completo de la ecuación.
El chispazo: ChatGPT ya tenía casi todo
Al mirar el problema de otra manera, me di cuenta de que un motor de Contexto necesitaba, en el fondo, tres grandes bloques.
- Hace falta un motor capaz de razonar sobre la información.
- ChatGPT ya sabe hacerlo.
- Hacen falta reglas que le expliquen al motor cómo trabajar.
- Las directrices de Proyecto de ChatGPT pueden cumplir ese papel.
- Y hace falta, por último, una memoria que sobreviva a las conversaciones.
- Esa era la pieza que faltaba.
Mi arquitectura podía convertirse entonces en:
Motor         → ChatGPT
Directrices   → Proyecto ChatGPT
Persistencia  → Google Sheets
El hack de persistencia de mi artículo anterior aportaba justamente ese tercer bloque.
A partir de ahí, portar mi motor de Contexto a ChatGPT pasó a parecer mucho menos exótico.
No necesitaba recrear un sistema completo alrededor de ChatGPT.
El motor de IA ya estaba ahí.
Lo que había que darle, sobre todo, eran sus reglas y una memoria externa que supiera leer y modificar.
Cómo porté el motor a ChatGPT
Al principio intenté meter todas las reglas del motor directamente en las directrices del Proyecto.
No aguantó mucho tiempo.
Las directrices de Proyecto están limitadas a unos 8.000 caracteres y mi motor ya necesitaba bastante más.
Así que separé las reglas en dos niveles.
El primer nivel es el CORE.
Es la parte que va directamente en las directrices del Proyecto ChatGPT.
Contiene los elementos absolutamente imprescindibles para que el motor funcione:
- qué es un Contexto;
- dónde está almacenado;
- qué comandos existen;
- cómo abrir un Contexto;
- cómo persistir una fuente;
- la estructura de los archivos;
- los principales invariantes;
- la jerarquía de las directrices.
El segundo nivel es una directriz ampliada.
Es mucho más voluminosa y vive en un Google Doc.
Contiene, por ejemplo:
- el método detallado de ingestión;
- los criterios de creación de los conocimientos atómicos;
- la gestión del state y de la synthesis;
- las decisiones;
- las contradicciones;
- los todo;
- las estrategias de lectura;
- las reglas de producción;
- la gestión de los errores y de los casos límite.
La jerarquía queda así:
CORE
  ↓
Directriz ampliada
  ↓
Directrices propias del Contexto
El CORE sabe dónde se encuentra la directriz ampliada e indica a ChatGPT que la cargue al inicio de cada nueva conversación.
Así pues, la separación no está ahí solo para hacer el sistema más elegante.
Responde ante todo a una restricción muy concreta: el motor entero no cabe en las directrices de un Proyecto ChatGPT.
Google Sheets se convierte en la memoria del Contexto
Quedaba después representar el Contexto en sí.
Podría haber usado varios Google Docs.
- Un documento para las fuentes.
- Otro para el estado.
- Otro para los conocimientos.
- Otro para las tareas.
- ...
Pero habría acabado enseguida con un montón de archivos que localizar y otros tantos identificadores que gestionar (más adelante veremos esa restricción tecnológica).
Google Sheets resultó mucho más práctico.
Un Contexto corresponde a un Spreadsheet.
Dentro del Spreadsheet, cada tipo de información tiene su pestaña.
Ahora mismo uso esta estructura:
00-FRAME
01-STATE
03-SESSIONS
04-ATOMIC
05-OUTPUTS
00-FRAME contiene en particular la misión y las posibles directrices propias del Contexto.
01-STATE contiene la información necesaria para saber en qué punto está el trabajo:
- state;
- synthesis;
- todo;
- decisiones;
- contradicciones;
- handoff.
03-SESSIONS contiene las fuentes en bruto persistidas.
04-ATOMIC contiene los conocimientos estabilizados.
05-OUTPUTS contiene los entregables producidos a partir del Contexto.
Google Sheets ya no es, por tanto, solo el sitio donde ChatGPT escribe una información para guardarla.
El Spreadsheet se convierte en la memoria estructurada completa del Contexto.
Ante todo, no recargarlo entero
Eso no significa que ChatGPT cargue el Spreadsheet entero en cada conversación.
Seguramente sería una idea pésima.
Cuando escribo:
Abre Mi Contexto
ChatGPT empieza por localizar el Spreadsheet correspondiente.
Después carga únicamente su núcleo:
- misión;
- directrices;
- state;
- synthesis;
- todo;
- decisiones;
- contradicciones;
- handoff.
Las fuentes, los conocimientos atómicos y los outputs antiguos se quedan en el Sheet.
ChatGPT solo los consulta cuando se vuelven necesarios.
Es un punto importante en mi manera de concebir el sistema.
La memoria no funciona así:
vuelvo a meter todo lo que sé en el prompt en cada conversación.
Funciona más bien así:
tengo una memoria externa en la que puedo ir a buscar la información pertinente en el momento en que resulta útil.
El Contexto se convierte en una memoria externa direccionable.
El detalle que hacía perder muchísimo tiempo
En una primera versión, aún no había optimizado la resolución de los identificadores de Google.
Cada vez que ChatGPT quería leer o escribir en un Contexto, tenía que buscar el Spreadsheet correspondiente y luego localizar su ID.
Y en la operación siguiente, vuelta a empezar.
Funcionaba, pero algunas operaciones podían acercarse a los cincuenta segundos.
Buena parte del tiempo se dedicaba simplemente a volver a encontrar algo que ya se había encontrado unos segundos antes.
Así que añadí una regla muy sencilla.
Una vez abierto el Contexto, ChatGPT conserva durante la conversación:
nombre del Contexto
→ Spreadsheet
→ Spreadsheet ID
Todas las operaciones siguientes usan directamente ese ID.
Solo se vuelve a resolver si:
- se cambia de Contexto;
- el ID ya no está disponible;
- el acceso falla.
Parece bastante obvio.
Pero cambia enormemente la fluidez del sistema.
Persistir no es aprender
El motor en sí expone, a fin de cuentas, muy pocos comandos.
Abre <contexto>
Persiste <contenido>
Todo <acción>
Ingiere
Guarda
Abre carga un Contexto.
Persiste conserva una fuente nueva.
Todo añade una acción pendiente.
Ingiere analiza las fuentes nuevas y actualiza el conocimiento estructurado (creación o enriquecimiento de notas).
Guarda actualiza los elementos que permiten retomar correctamente la misión en la próxima conversación.
Pero la distinción más importante del sistema es probablemente esta:
Persiste no es Ingiere.
Cuando digo:
Persiste ...
no le estoy pidiendo al motor que dé por cierto lo que acabo de decir.
Le pido únicamente:
conserva este material.
Se convierte en una fuente.
Durante la ingestión, el motor puede determinar después que lo que contiene corresponde a:
- una decisión realmente tomada;
- una tarea;
- una contradicción;
- una información útil para el estado actual;
- un conocimiento lo bastante estabilizado como para convertirse en una nota atómica;
- o simplemente algo que hay que conservar como fuente sin ir más lejos.
Eso evita una deriva que me parece especialmente peligrosa en los sistemas de memoria para IA.
Si toda producción de la IA se convierte automáticamente en un conocimiento del sistema, la IA acaba pudiendo usar sus propias producciones anteriores como prueba.
Por eso intento mantener una separación estricta:
fuente ≠ conocimiento ≠ estado ≠ síntesis ≠ entregable
Una fuente dice:
esto es lo que se dijo o se observó.
Un conocimiento estabilizado dice otra cosa:
esto es lo que el sistema considera ya lo bastante establecido y reutilizable.
Un Contexto en el bolsillo
Es en el móvil donde esta adaptación se vuelve realmente interesante para mí.
Ya trabajo muchísimo con dictado por voz.
Y en este caso concreto cambia por completo la relación con el sistema.
Volvamos al ejemplo de una feria profesional.
Llego con un Contexto ya preparado.
Desde el móvil:
Abre Feria-X
Hablo con un primer expositor.
Al salir del estand no me apetece necesariamente pararme, abrir una aplicación de notas y teclear cinco minutos en un teclado diminuto.
Camino hacia el estand siguiente y le dicto sin más a ChatGPT lo que acabo de aprender.
Luego:
Persiste <lo que acabo de dictar>
Puede tardar unas decenas de segundos.
Sigo con mi jornada.
Después de varias conversaciones:
Ingiere
El motor empieza entonces a estructurar lo que he recogido.
Y ahí es donde el uso se vuelve más interesante que un simple sistema de toma de notas.
Puedo preguntarle a ChatGPT:
¿Qué me falta todavía para entender de verdad este tema?
O bien:
¿Qué contradicciones debería verificar con el próximo expositor?
O también:
¿Qué preguntas importantes no le he hecho todavía a nadie?
Puedo obtener esa respuesta mientras sigo en la feria.
Y, por tanto, ir a hacer de inmediato las preguntas que faltan.
El ciclo queda así:
conversación
   ↓
dictado por voz mientras camino
   ↓
Persiste
   ↓
Ingiere
   ↓
buscar los puntos ciegos
   ↓
volver a hacer preguntas
   ↓
completar el Contexto
Probablemente sea esto lo que más cambia mi forma de usarlo.
La IA ya no interviene solo después de la recogida para ayudarme a producir algo.
Puede intervenir durante la recogida, cuando todavía se puede mejorar la calidad de la información.
Plaud: hacer entrar las conversaciones en el Contexto
También uso un Plaud Note Pro.
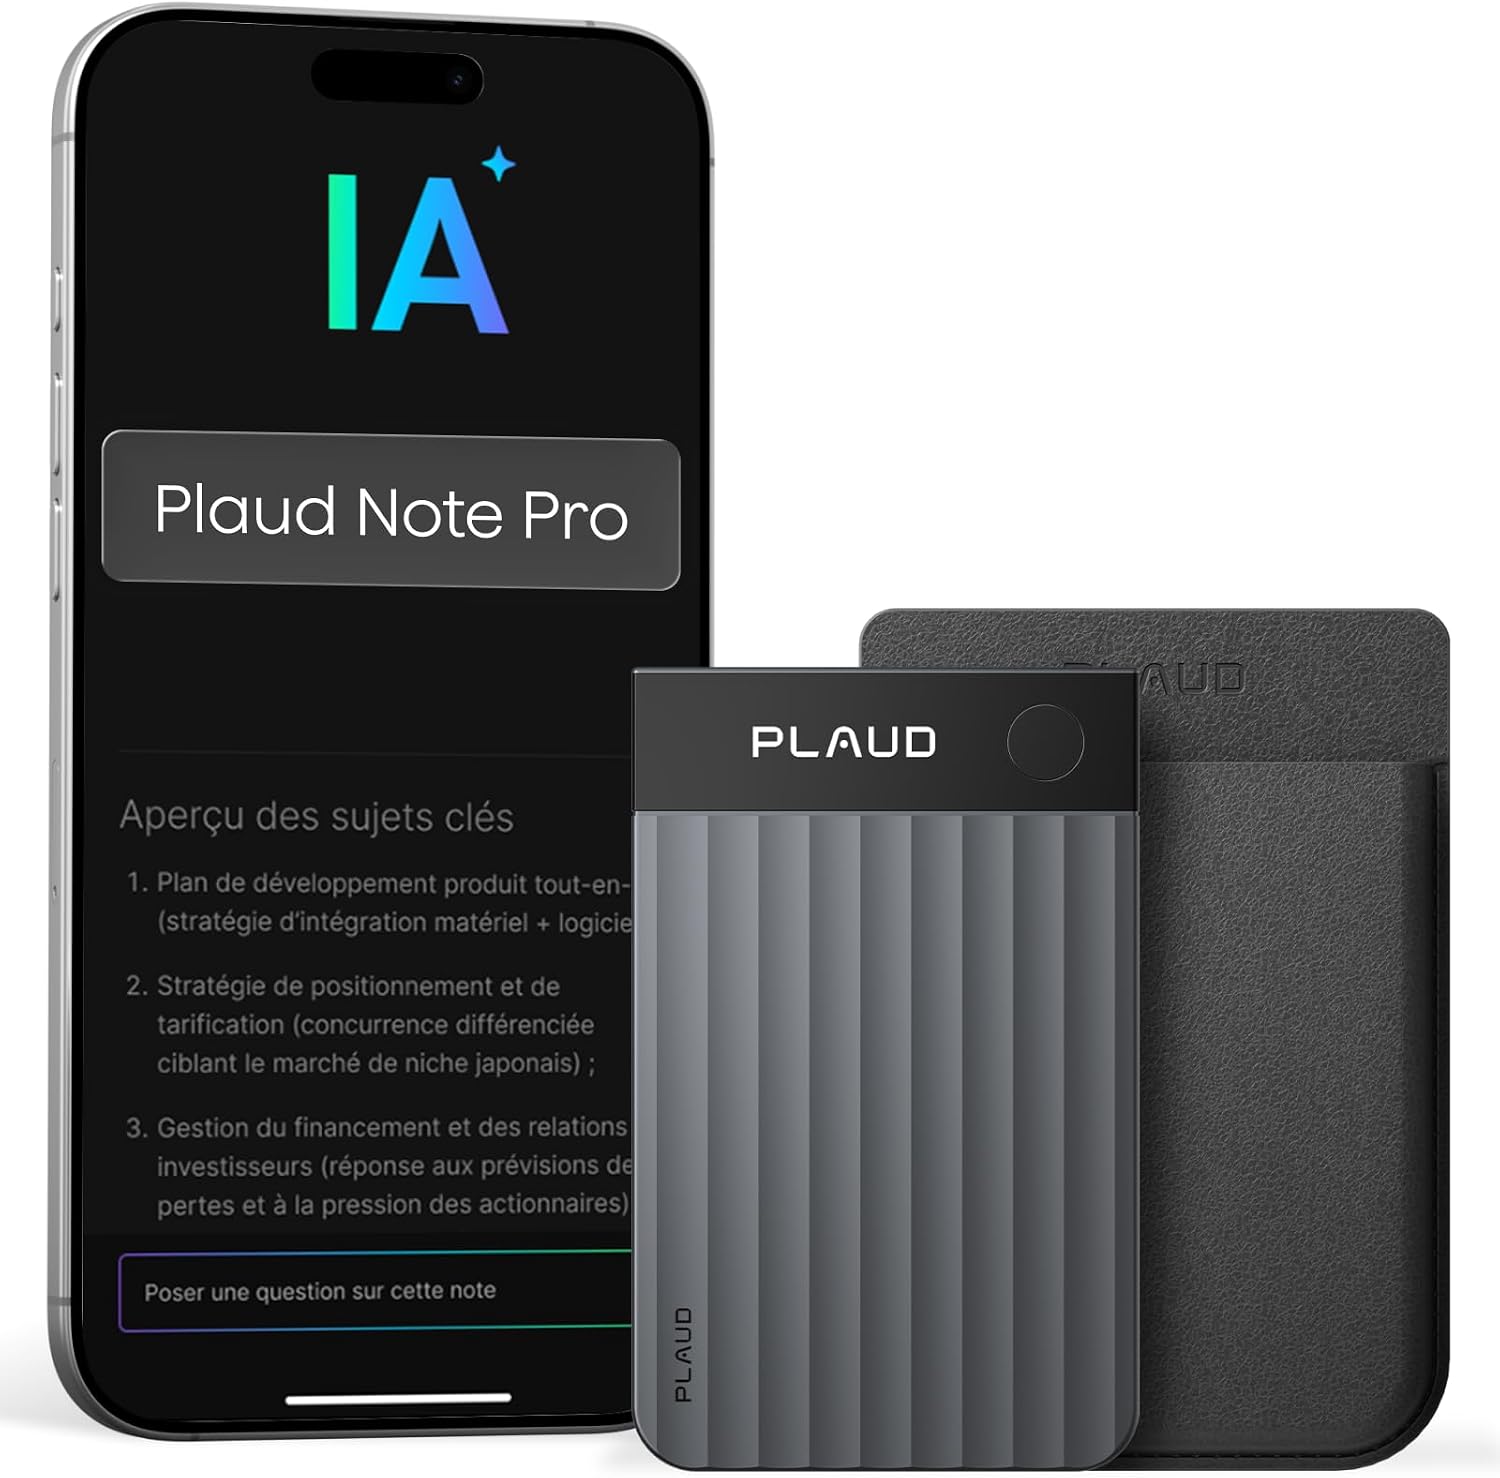
Mi Plaud Note Pro, que puedo usar para grabar conversaciones y entrevistas sobre el terreno.
Plaud Note Pro es una pequeña grabadora de voz que sirve para grabar reuniones, conversaciones o entrevistas.
La grabación queda después disponible en Plaud y puede transcribirse.
Ahora bien, para mi sistema lo que más me interesa no es el resumen automático que produce Plaud.
Quiero recuperar la transcripción completa.
Y hay otra pieza importante: ChatGPT puede acceder directamente a Plaud a través de su conector.
Así que puedo pedirle, desde ChatGPT, por ejemplo:
Enumérame mis tres últimas grabaciones de Plaud y dime en una línea de qué habla cada una.
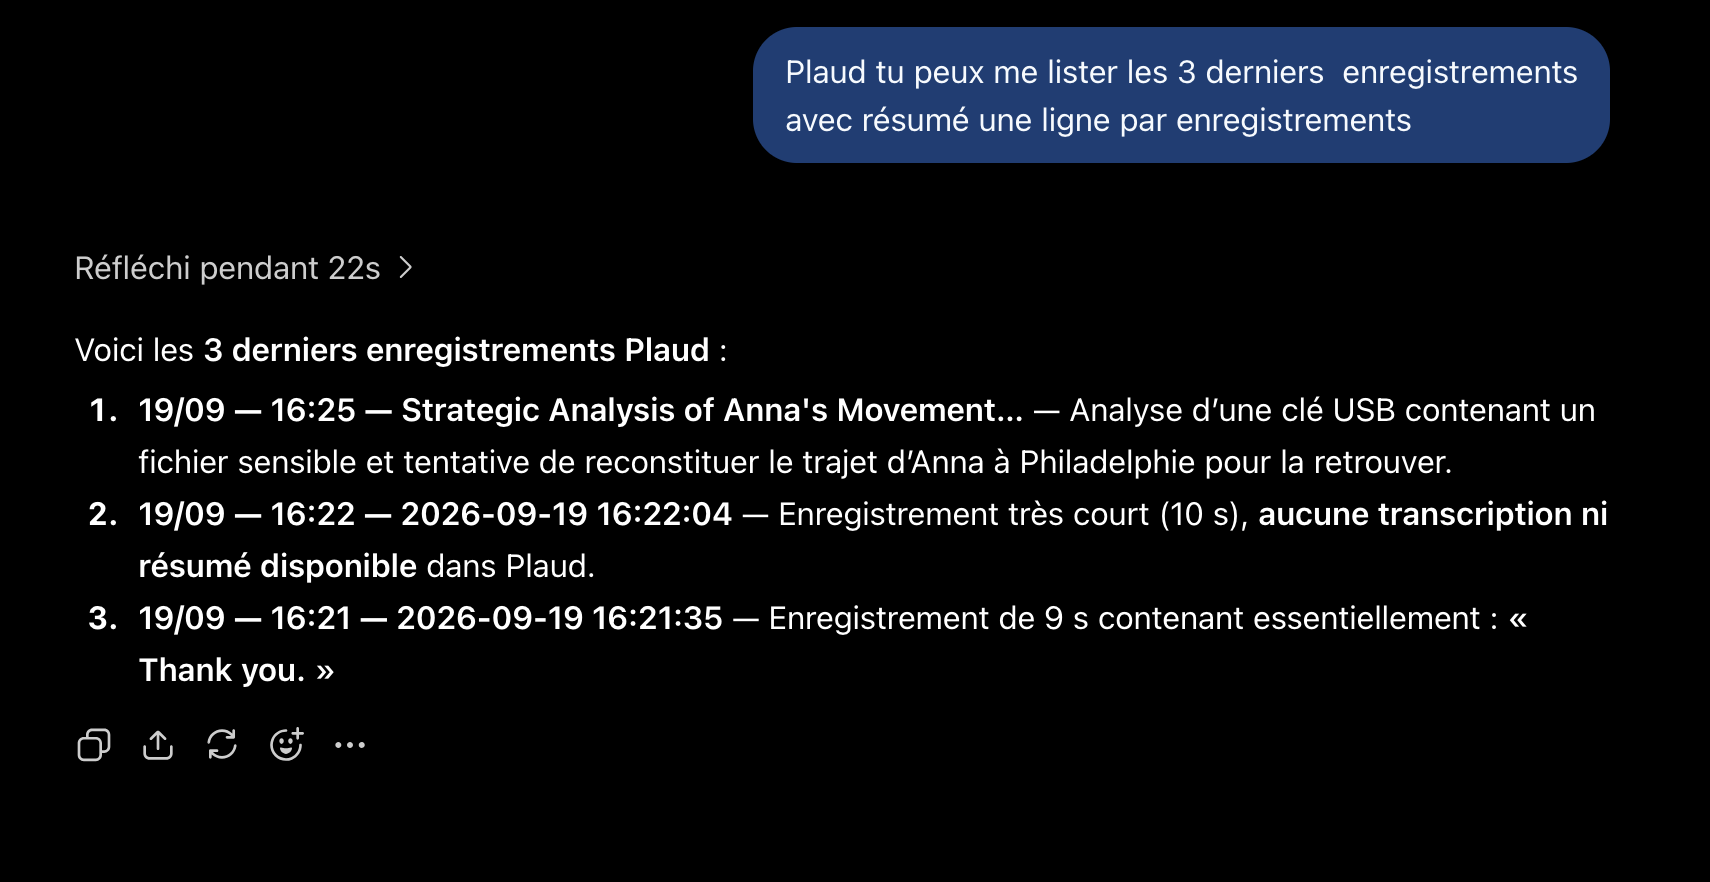
Ejemplo de consulta a Plaud desde ChatGPT para localizar las últimas grabaciones.
ChatGPT puede localizar esas grabaciones y luego recuperar directamente su transcripción.
Eso permite imaginar un flujo de trabajo mucho más directo:
conversación real
        ↓
Plaud
        ↓
transcripción
        ↓
ChatGPT recupera directamente la transcripción
        ↓
Persiste
        ↓
fuente en bruto del Contexto
        ↓
Ingiere
No necesito, por tanto:
- descargar manualmente un archivo;
- abrir la transcripción;
- copiarla;
- volver a ChatGPT;
- pegarla.
Puedo hacerlo todo automáticamente, por voz, desde el móvil.
Y prefiero meter en el Contexto la transcripción completa en bruto antes que un simple resumen.
El resumen ya es una interpretación.
La transcripción se mantiene mucho más cerca del material de origen.
Una vez la conversación está en el Contexto, puedo preguntar:
- ¿qué me acaba de enseñar realmente esta persona?
- ¿qué contradice las conversaciones anteriores?
- ¿qué afirmaciones merecen comprobarse?
- ¿qué preguntas debería hacerle a la próxima persona?
Los distintos bloques necesarios ya funcionan.
Lo que aún no he hecho es poner a prueba lo suficiente, de principio a fin, este flujo Plaud → ChatGPT → Contexto durante jornadas largas sobre el terreno, así que no puedo decir que sea perfectamente fluido.
Es, por tanto, un uso que todavía tengo que probar más.
Cómo reproducir el sistema
He preparado dos archivos que corresponden a los dos niveles de directrices del motor.
El CORE
El CORE está disponible aquí:
Esta es la parte que hay que copiar en las directrices del Proyecto ChatGPT.
La directriz ampliada
La directriz detallada está disponible aquí:
Hay que copiarla en un Google Doc al que ChatGPT pueda acceder.
Antes de empezar hay que conectar, evidentemente, Google Drive a ChatGPT y permitirle acceder a los documentos que usa el motor.
Configurar los ID
El CORE contiene, entre otras cosas, dos identificadores:
DOCUMENT_ID = xxxx
FOLDER_ID = xxxx
DOCUMENT_ID corresponde al Google Doc que contiene la directriz ampliada.
En una URL como esta:
https://docs.google.com/document/d/xxxx/edit
la parte xxxx es el identificador del documento.
FOLDER_ID corresponde a la carpeta de Google Drive donde se almacenarán los Contextos.
Para una URL como esta:
https://drive.google.com/drive/folders/xxxx
el identificador es de nuevo la parte xxxx.
Cada usuario tiene que sustituir, obviamente, esos valores por los de su propio entorno.
Un Spreadsheet por Contexto
Cuando se crea un Contexto nuevo, el motor crea un Spreadsheet que contiene:
00-FRAME
01-STATE
03-SESSIONS
04-ATOMIC
05-OUTPUTS
Después lo coloca en la carpeta definida por FOLDER_ID.
No hace falta copiar a mano el identificador de cada uno de esos Spreadsheets en las directrices.
Cuando pido:
Abre Mi Contexto
ChatGPT busca el Spreadsheet correspondiente en la carpeta de los Contextos, recupera su ID y lo conserva durante la conversación.
El sistema ya está operativo.
Lo que permite este apaño — y sus límites
Esta versión para ChatGPT no sustituye a mi motor usado con Codex o Claude Code.
No era el objetivo.
Tiene varios límites.
Es más lenta.
Está menos adaptada a Contextos que necesitan directamente scripts de Python, llamadas a API o un entorno de ejecución más rico.
Y, sobre todo, aún me falta perspectiva sobre su comportamiento cuando un Contexto crece de verdad a lo largo de varias semanas.
Así que la veo como un modo autónomo complementario.
En mi Mac, Codex o Claude Code siguen encajando mejor con ciertas misiones.
Pero desde el móvil ya puedo usar un Contexto sin depender de que mi Mac esté encendido y accesible.
Y ese era precisamente el problema que quería resolver.
Hay además una observación curiosa relacionada con la cuota de Codex.
Durante todo este experimento dentro de ChatGPT, la cuota de Codex que se muestra no bajó.
Consumo observado:
0
Obviamente no sostengo que eso constituya una regla general sobre cómo factura o contabiliza OpenAI este tipo de uso.
Simplemente constato que, durante este experimento, el apaño no consumió mi cuota de Codex.
El sistema ya ha servido para producir este artículo
Al principio, mi primer hack de Google Sheets respondía a una pregunta bastante limitada:
¿cómo sacar una información de ChatGPT y conservarla de forma duradera?
Unos días después, la pregunta era otra:
¿y si sacara toda la memoria estructurada del Contexto?
Eso es, al final, lo que hace este sistema.
ChatGPT ya no necesita «acordarse de todo».
Lo que tiene que saber, sobre todo, es:
- dónde buscar;
- qué cargar;
- qué persistir;
- cómo calificar la información;
- cómo localizar lo que ya se ha aprendido;
- en qué punto está el trabajo.
La fórmula sigue siendo bastante sencilla:
ChatGPT razona.
Las directrices definen el motor.
Google Sheets recuerda.
Y hay algo bastante satisfactorio en el hecho de que la preparación y la redacción de este artículo hayan servido a su vez para probar el sistema que el artículo describe.
Para preparar este texto he usado exclusivamente ese Contexto dentro de ChatGPT.
Ahí he persistido mis ideas.
Las he ingerido.
Hemos identificado puntos ciegos.
He corregido formulaciones.
Hemos creado y terminado tareas.
He añadido los elementos que faltaban.
Después produje una primera versión del artículo, la releí y usé el mismo Contexto para preparar esta V2.
Dicho de otro modo, el sistema no ha servido solo de demostrador técnico.
Ya se ha usado para hacer realmente el trabajo para el que lo construí.
Así que la pregunta ya no es exactamente:
¿funciona?
Funciona.
La pregunta que me interesa ahora es más bien:
¿seguirá siendo igual de práctica esta arquitectura cuando el mismo Contexto se ponga a prueba sobre el terreno durante una semana entera de ferias profesionales?
Es lo que el uso de los próximos días permitirá comprobar.