Ursprünglich auf Französisch verfasst. Von KI übersetzt — der Sinn wurde bewahrt, nicht der Stil.
Dieses Thema wird in meinem Buch Le Contexte vertieft. Um es zu lesen, laden Sie es herunter oder kaufen Sie es bei Amazon. Die Amazon-Ausgabe ist nur auf Französisch erhältlich; wenn Sie eine Version in einer anderen Sprache wünschen, kontaktieren Sie mich.
Dieser Artikel schließt an „Persistiere das: eine Information aus ChatGPT in einen permanenten Speicher holen“ an.
Bei dieser ersten Bastelei hatte ich etwas ziemlich Einfaches entdeckt, das aber vieles verändert: ChatGPT konnte eine Information in Google Sheets schreiben und sie damit aus dem eigenen Kontextfenster herausholen.
Anders gesagt: Ich konnte ihm ein dauerhaftes externes Gedächtnis geben.
Damals diente mir Google Sheets im Wesentlichen als Postausgang.
Dann stellte ich mir eine andere Frage:
Reicht derselbe Mechanismus, um mein System aus Kontexten direkt in ChatGPT laufen zu lassen?
Warum ich den Kontext vom Mac lösen wollte
Ich nutze seit einiger Zeit Kontexte mit Codex und Claude Code.
Und wenn ich von „Kontext“ spreche, meine ich nicht einfach einen Gesprächsverlauf oder einen Ort für ein paar Notizen.
Die Definition, mit der ich arbeite, ist sehr viel weiter:
Ein Kontext ist ein System, das durch eine menschliche Mission begrenzt wird und in dem eine KI ordnet und verfügbar hält, was man weiß, woher man es weiß, wie die Elemente zusammenhängen und wo die Arbeit gerade steht — damit der Mensch sein Ziel erreicht, ohne bei null anzufangen. Dabei baut das System ein dauerhaftes Informationskapital auf und mehrt es: Das erzeugte Wissen bleibt verfügbar, wächst mit der Zeit und lässt sich für andere Ziele wiederverwenden.
Eine Engine, die dieses Prinzip mit Codex oder Claude Code umsetzt, hatte ich bereits gebaut.
Auf meinem Mac funktioniert das gut.
Für das Telefon hatte ich ebenfalls eine Lösung gefunden: aus der Ferne auf Codex zugreifen, das auf dem Mac läuft.
Aber sie hat eine ziemlich offensichtliche Schwäche.
Nötig ist, dass:
- der Mac eingeschaltet ist;
- er mit dem Internet verbunden bleibt;
- der Fernzugriff funktioniert.
Zu Hause stört das kaum.
Vor Ort sehr viel mehr.
Der Fall, der mich besonders interessierte, waren zwei bevorstehende Fachmessen: eine Woche nur mit dem Telefon unterwegs, Gespräche mit Ausstellern, Informationen sammeln, Interviews vorbereiten und womöglich noch am selben Tag einen Artikel produzieren.
Ich hatte keine Lust, von einem Mac abzuhängen, der einige zehn oder hundert Kilometer entfernt eingeschaltet ist.
Also fragte ich mich, ob ich ihn ganz aus der Gleichung nehmen kann.
Der Auslöser: ChatGPT hatte schon fast alles
Als ich das Problem anders betrachtete, wurde mir klar, dass eine Kontext-Engine im Grunde drei große Bausteine braucht.
- Es braucht eine Engine, die über Informationen nachdenken kann.
- ChatGPT kann das bereits.
- Es braucht Regeln, die der Engine erklären, wie sie arbeiten soll.
- Die Direktiven eines ChatGPT-Projekts können diese Rolle übernehmen.
- Und es braucht schließlich ein Gedächtnis, das die Gespräche überlebt.
- Das war das fehlende Stück.
Meine Architektur konnte also so aussehen:
Engine       → ChatGPT
Direktiven   → ChatGPT-Projekt
Persistenz   → Google Sheets
Der Persistenz-Hack aus meinem vorigen Artikel lieferte genau diesen dritten Baustein.
Von da an wirkte die Portierung meiner Kontext-Engine nach ChatGPT viel weniger exotisch.
Ich musste kein vollständiges System rund um ChatGPT neu bauen.
Die KI-Engine war schon da.
Vor allem musste ich ihr ihre Regeln geben und ein externes Gedächtnis, das sie lesen und ändern kann.
Wie ich die Engine nach ChatGPT portiert habe
Zuerst habe ich versucht, alle Regeln der Engine direkt in die Direktiven des Projekts zu schreiben.
Das hielt nicht lange.
Projekt-Direktiven sind auf rund 8 000 Zeichen begrenzt, und meine Engine brauchte schon damals deutlich mehr.
Also habe ich die Regeln auf zwei Ebenen verteilt.
Die erste Ebene ist der CORE.
Das ist der Teil, der direkt in die Direktiven des ChatGPT-Projekts kommt.
Er enthält die für den Betrieb der Engine absolut notwendigen Elemente:
- was ein Kontext ist;
- wo er gespeichert liegt;
- welche Befehle es gibt;
- wie man einen Kontext öffnet;
- wie man eine Quelle persistiert;
- die Struktur der Dateien;
- die wichtigsten Invarianten;
- die Hierarchie der Direktiven.
Die zweite Ebene ist eine erweiterte Direktive.
Sie ist deutlich umfangreicher und liegt in einem Google Doc.
Sie enthält zum Beispiel:
- die ausführliche Methode des Einspeisens;
- die Kriterien für das Anlegen atomaren Wissens;
- die Verwaltung von state und synthesis;
- die Entscheidungen;
- die Widersprüche;
- die todo;
- die Lesestrategien;
- die Regeln für die Produktion;
- den Umgang mit Fehlern und Grenzfällen.
Die Hierarchie sieht dann so aus:
CORE
  ↓
Erweiterte Direktive
  ↓
Direktiven des jeweiligen Kontexts
Der CORE weiß, wo die erweiterte Direktive liegt, und weist ChatGPT an, sie zu Beginn eines neuen Gesprächs zu laden.
Die Trennung ist also nicht nur da, um das System eleganter zu machen.
Sie ist zuerst die Antwort auf einen sehr konkreten Zwang: die ganze Engine passt nicht in die Direktiven eines ChatGPT-Projekts.
Google Sheets wird zum Gedächtnis des Kontexts
Danach blieb noch, den Kontext selbst abzubilden.
Ich hätte mehrere Google Docs nehmen können.
- Ein Dokument für die Quellen.
- Ein weiteres für den Zustand.
- Ein weiteres für das Wissen.
- Ein weiteres für die Aufgaben.
- ...
Aber ich hätte schnell eine Menge Dateien gehabt, die ich alle wiederfinden müsste, und ebenso viele Kennungen, die ich verwalten müsste (auf diesen technischen Zwang komme ich später zurück).
Google Sheets erwies sich als deutlich praktischer.
Ein Kontext entspricht einem Spreadsheet.
Innerhalb des Spreadsheets hat jeder Informationstyp seinen eigenen Tab.
Derzeit nutze ich diese Struktur:
00-FRAME
01-STATE
03-SESSIONS
04-ATOMIC
05-OUTPUTS
00-FRAME enthält vor allem die Mission und die eventuellen Direktiven des jeweiligen Kontexts.
01-STATE enthält, was man braucht, um zu wissen, wo die Arbeit steht:
- state;
- synthesis;
- todo;
- Entscheidungen;
- Widersprüche;
- handoff.
03-SESSIONS enthält die persistierten rohen Quellen.
04-ATOMIC enthält das stabilisierte Wissen.
05-OUTPUTS enthält die aus dem Kontext erzeugten Outputs.
Google Sheets ist damit nicht mehr nur der Ort, an den ChatGPT eine Information zum Aufbewahren schreibt.
Das Spreadsheet wird zum vollständigen strukturierten Gedächtnis des Kontexts.
Bloß nicht alles neu laden
Das heißt allerdings nicht, dass ChatGPT bei jedem Gespräch das gesamte Spreadsheet lädt.
Das wäre vermutlich eine sehr schlechte Idee.
Wenn ich schreibe:
Öffne Mein Kontext
sucht ChatGPT zuerst das passende Spreadsheet.
Dann lädt es nur dessen Kern:
- Mission;
- Direktiven;
- state;
- synthesis;
- todo;
- Entscheidungen;
- Widersprüche;
- handoff.
Die Quellen, das atomare Wissen und die alten Outputs bleiben im Sheet.
ChatGPT holt sie erst, wenn sie nötig werden.
Das ist ein wichtiger Punkt in der Art, wie ich das System denke.
Das Gedächtnis funktioniert nicht so:
Ich lege bei jedem Gespräch alles, was ich weiß, wieder in den Prompt.
Es funktioniert eher so:
Ich habe ein externes Gedächtnis, in dem ich die passende Information genau dann holen kann, wenn sie nützlich wird.
Der Kontext wird zu einem adressierbaren externen Gedächtnis.
Das Detail, das enorm Zeit kostete
In einer ersten Fassung hatte ich das Auflösen der Google-Kennungen noch nicht optimiert.
Jedes Mal, wenn ChatGPT in einem Kontext lesen oder schreiben wollte, musste es das passende Spreadsheet suchen und dann dessen ID wiederfinden.
Und bei der nächsten Operation fing es von vorn an.
Das funktionierte, aber manche Operationen kamen an die fünfzig Sekunden heran.
Ein erheblicher Teil der Zeit ging schlicht dafür drauf, etwas wiederzufinden, was Sekunden zuvor schon gefunden worden war.
Also habe ich eine sehr einfache Regel ergänzt.
Ist der Kontext einmal geöffnet, behält ChatGPT für die Dauer des Gesprächs:
Name des Kontexts
→ Spreadsheet
→ Spreadsheet ID
Alle folgenden Operationen nutzen direkt diese ID.
Neu aufgelöst wird sie nur, wenn:
- man den Kontext wechselt;
- die ID nicht mehr verfügbar ist;
- der Zugriff scheitert.
Das wirkt ziemlich selbstverständlich.
Aber es ändert enorm viel an der Flüssigkeit des Systems.
Persistieren ist nicht Lernen
Die Engine selbst bietet am Ende sehr wenige Befehle.
Öffne <kontext>
Persistiere <inhalt>
Todo <aktion>
Speise ein
Speichere
Öffne lädt einen Kontext.
Persistiere bewahrt eine neue Quelle auf.
Todo fügt eine zu erledigende Aktion hinzu.
Speise ein analysiert die neuen Quellen und aktualisiert das strukturierte Wissen (Notizen anlegen oder anreichern).
Speichere aktualisiert die Elemente, mit denen sich die Mission im nächsten Gespräch sauber wieder aufnehmen lässt.
Aber die wichtigste Unterscheidung des Systems ist wohl diese:
Persistiere ist nicht Speise ein.
Wenn ich sage:
Persistiere ...
verlange ich von der Engine nicht, das gerade Gesagte für wahr zu halten.
Ich verlange nur:
Bewahre dieses Material auf.
Es wird zu einer Quelle.
Beim Einspeisen kann die Engine dann feststellen, dass ihr Inhalt einem der folgenden Fälle entspricht:
- eine tatsächlich getroffene Entscheidung;
- eine Aufgabe;
- ein Widerspruch;
- eine für den aktuellen Zustand nützliche Information;
- ein Wissen, das stabil genug ist, um eine atomare Notiz zu werden;
- oder schlicht etwas, das als Quelle aufbewahrt werden soll, ohne weiter zu gehen.
Das verhindert eine Abdrift, die mir bei Gedächtnissystemen für KI besonders gefährlich erscheint.
Wenn jede Produktion der KI automatisch zu Wissen des Systems wird, kann die KI am Ende ihre eigenen früheren Produktionen als Beweis heranziehen.
Ich versuche deshalb, eine strikte Trennung zu halten:
Quelle ≠ Wissen ≠ Zustand ≠ Zusammenfassung ≠ Output
Eine Quelle sagt:
Das wurde gesagt oder beobachtet.
Ein stabilisiertes Wissen sagt etwas anderes:
Das hält das System nun für hinreichend gesichert und wiederverwendbar.
Ein Kontext in der Hosentasche
Auf dem Telefon wird diese Portierung für mich wirklich interessant.
Ich arbeite ohnehin sehr viel mit Spracheingabe.
Und genau hier ändert sich das Verhältnis zum System vollständig.
Nehmen wir noch einmal das Beispiel einer Fachmesse.
Ich komme mit einem bereits vorbereiteten Kontext an.
Vom Telefon aus:
Öffne Messe-X
Ich spreche mit einem ersten Aussteller.
Beim Verlassen des Stands habe ich nicht unbedingt Lust, stehen zu bleiben, eine Notiz-App zu öffnen und fünf Minuten auf einer winzigen Tastatur zu tippen.
Ich gehe zum nächsten Stand und diktiere ChatGPT einfach, was ich gerade erfahren habe.
Dann:
Persistiere <was ich gerade diktiert habe>
Das kann einige zehn Sekunden dauern.
Ich mache mit meinem Tag weiter.
Nach mehreren Gesprächen:
Speise ein
Die Engine beginnt dann, das Gesammelte zu strukturieren.
Und hier wird die Nutzung interessanter als ein bloßes Notizsystem.
Ich kann ChatGPT fragen:
Was fehlt mir noch, um dieses Thema wirklich zu verstehen?
Oder:
Welche Widersprüche sollte ich beim nächsten Aussteller prüfen?
Oder auch:
Welche wichtigen Fragen habe ich noch niemandem gestellt?
Diese Antwort kann ich bekommen, während ich noch auf der Messe bin.
Und damit sofort losgehen und die fehlenden Fragen stellen.
Der Zyklus sieht dann so aus:
Gespräch
   ↓
Diktieren im Gehen
   ↓
Persistiere
   ↓
Speise ein
   ↓
blinde Flecken suchen
   ↓
zurückgehen und Fragen stellen
   ↓
den Kontext ergänzen
Das verändert meine Nutzung vermutlich am stärksten.
Die KI kommt nicht mehr nur nach der Erfassung ins Spiel, um mir beim Produzieren zu helfen.
Sie kann während der Erfassung eingreifen, solange sich die Qualität der Information noch verbessern lässt.
Plaud: Gespräche in den Kontext holen
Ich nutze außerdem ein Plaud Note Pro.
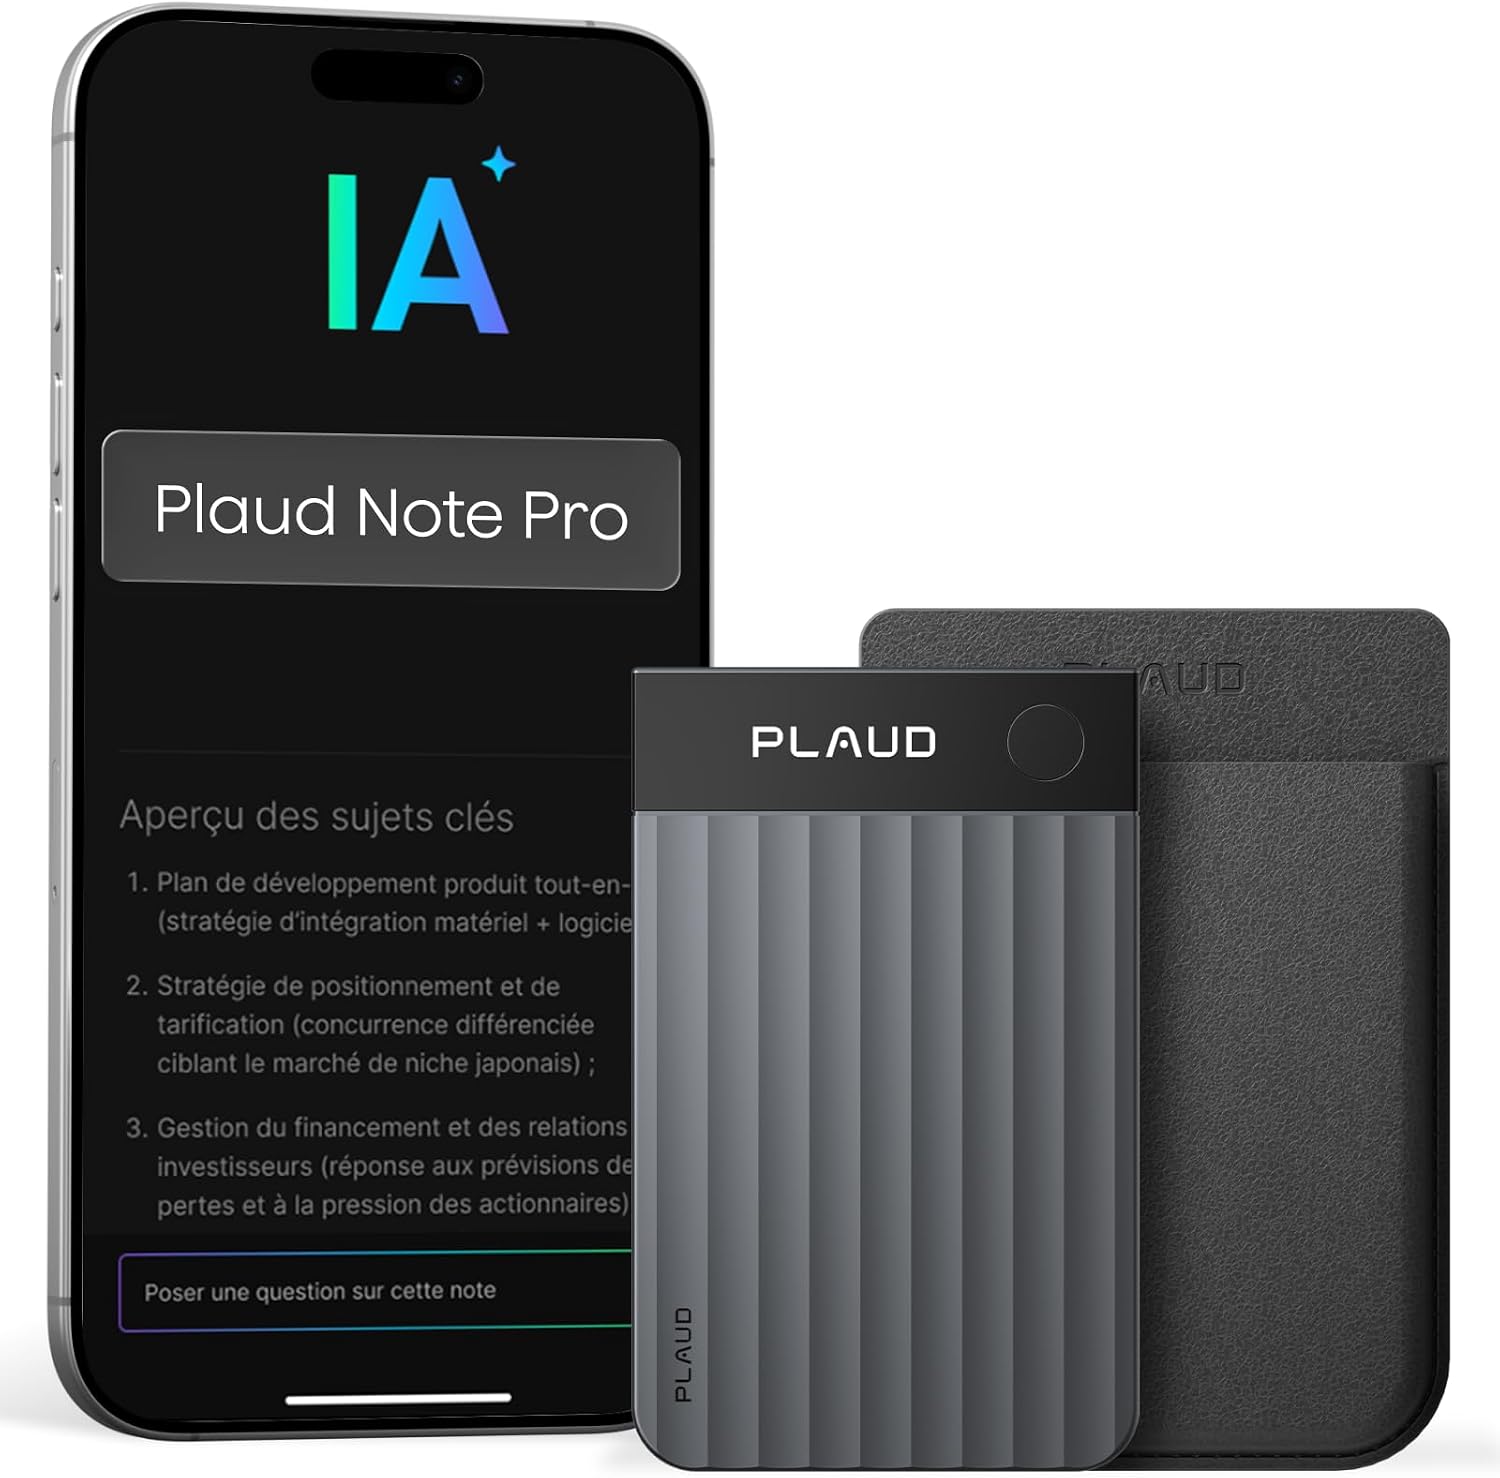
Mein Plaud Note Pro, mit dem ich Gespräche und Interviews vor Ort aufnehmen kann.
Das Plaud Note Pro ist ein kleiner Sprachrekorder, mit dem sich Meetings, Gespräche oder Interviews aufzeichnen lassen.
Die Aufnahme steht anschließend in Plaud bereit und kann transkribiert werden.
Für mein System interessiert mich allerdings nicht in erster Linie die automatische Zusammenfassung von Plaud.
Ich will die vollständige Transkription holen.
Und es gibt noch ein wichtiges Stück: ChatGPT kann über seinen Konnektor direkt auf Plaud zugreifen.
Ich kann also aus ChatGPT heraus zum Beispiel fragen:
Liste mir meine drei letzten Plaud-Aufnahmen auf und sag mir in einer Zeile, worum es jeweils geht.
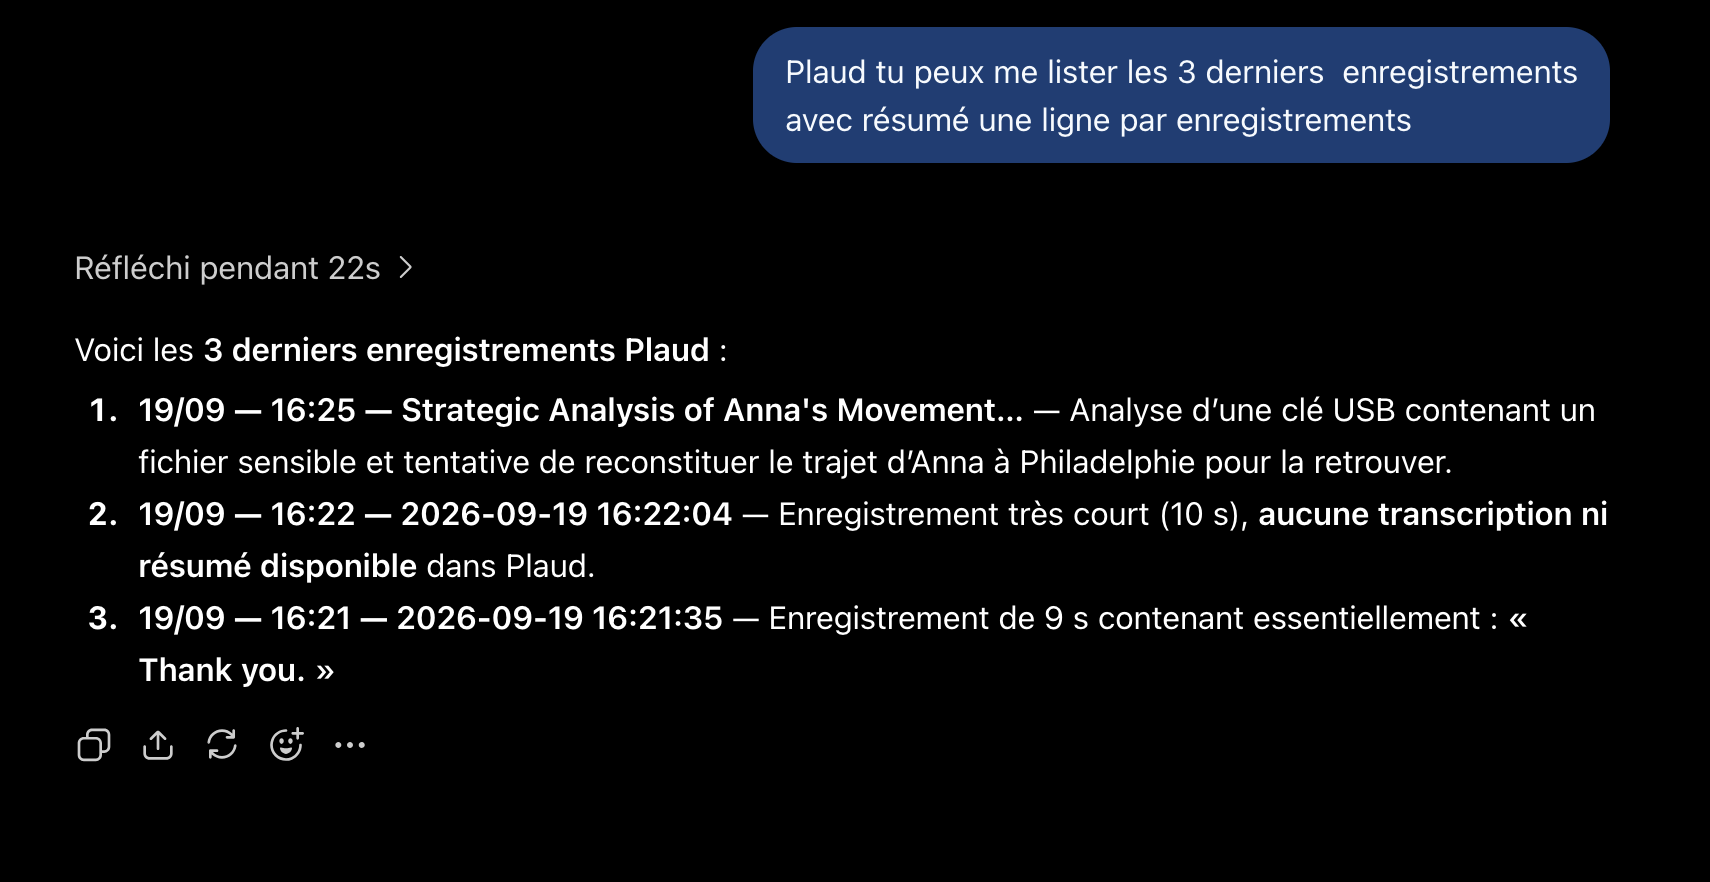
Beispiel für eine Abfrage von Plaud aus ChatGPT heraus, um die letzten Aufnahmen zu finden.
ChatGPT kann diese Aufnahmen finden und dann direkt ihre Transkription holen.
Damit lässt sich ein viel direkterer Workflow denken:
echtes Gespräch
        ↓
Plaud
        ↓
Transkription
        ↓
ChatGPT holt die Transkription direkt
        ↓
Persistiere
        ↓
rohe Quelle des Kontexts
        ↓
Speise ein
Ich muss also nicht:
- eine Datei von Hand herunterladen;
- die Transkription öffnen;
- sie kopieren;
- nach ChatGPT zurückkehren;
- sie einfügen.
Das alles geht automatisch, per Sprache, vom Telefon aus.
Und ich lasse lieber die vollständige rohe Transkription in den Kontext einfließen als eine bloße Zusammenfassung.
Die Zusammenfassung ist bereits eine Deutung.
Die Transkription bleibt viel näher am Quellmaterial.
Ist das Gespräch einmal im Kontext, kann ich fragen:
- Was hat mir diese Person wirklich gerade beigebracht?
- Was widerspricht den vorherigen Gesprächen?
- Welche Behauptungen verdienen eine Überprüfung?
- Welche Fragen sollte ich der nächsten Person stellen?
Die dafür nötigen Bausteine funktionieren bereits.
Diesen Workflow Plaud → ChatGPT → Kontext habe ich allerdings über lange Tage vor Ort noch nicht genug von Anfang bis Ende erprobt, um zu sagen, dass er völlig flüssig läuft.
Das bleibt also eine Nutzung, die noch mehr Tests braucht.
Wie man das System nachbaut
Ich habe zwei Dateien vorbereitet, die den beiden Direktiven-Ebenen der Engine entsprechen.
Der CORE
Der CORE steht hier bereit:
Diesen Teil muss man in die Direktiven des ChatGPT-Projekts kopieren.
Die erweiterte Direktive
Die ausführliche Direktive steht hier bereit:
Sie gehört in ein Google Doc, auf das ChatGPT zugreifen kann.
Vorher muss man natürlich Google Drive mit ChatGPT verbinden und ihm Zugriff auf die von der Engine genutzten Dokumente geben.
Die IDs konfigurieren
Der CORE enthält unter anderem zwei Kennungen:
DOCUMENT_ID = xxxx
FOLDER_ID = xxxx
DOCUMENT_ID bezeichnet das Google Doc mit der erweiterten Direktive.
In einer URL wie:
https://docs.google.com/document/d/xxxx/edit
ist der Teil xxxx die Kennung des Dokuments.
FOLDER_ID bezeichnet den Google-Drive-Ordner, in dem die Kontexte liegen werden.
Bei einer URL wie:
https://drive.google.com/drive/folders/xxxx
ist die Kennung wieder der Teil xxxx.
Diese Werte muss man natürlich durch die der eigenen Umgebung ersetzen.
Ein Spreadsheet pro Kontext
Wird ein neuer Kontext angelegt, erzeugt die Engine ein Spreadsheet mit:
00-FRAME
01-STATE
03-SESSIONS
04-ATOMIC
05-OUTPUTS
Es landet anschließend in dem Ordner, den FOLDER_ID festlegt.
Die Kennung jedes einzelnen Spreadsheets muss man nicht von Hand in die Direktiven übertragen.
Wenn ich verlange:
Öffne Mein Kontext
sucht ChatGPT das passende Spreadsheet im Ordner der Kontexte, holt dessen ID und behält sie für die Dauer des Gesprächs.
Damit ist das System einsatzbereit.
Was diese Bastelei ermöglicht — und ihre Grenzen
Diese ChatGPT-Fassung ersetzt nicht meine Engine, die ich mit Codex oder Claude Code nutze.
Das war nicht das Ziel.
Sie hat mehrere Grenzen.
Sie ist langsamer.
Sie taugt weniger für Kontexte, die direkt Python-Skripte, API-Aufrufe oder eine reichere Ausführungsumgebung brauchen.
Und vor allem fehlt mir noch der Abstand, um zu beurteilen, wie sie sich verhält, wenn ein Kontext über mehrere Wochen wirklich wächst.
Ich sehe sie deshalb als ergänzenden autonomen Modus.
Auf meinem Mac bleiben Codex oder Claude Code für bestimmte Missionen besser geeignet.
Aber vom Telefon aus kann ich jetzt einen Kontext nutzen, ohne davon abzuhängen, dass mein Mac eingeschaltet und erreichbar ist.
Und genau das war das Problem, das ich lösen wollte.
Es gibt noch eine amüsante Beobachtung rund um das Codex-Kontingent.
Während dieses ganzen Experiments in ChatGPT ist das angezeigte Codex-Kontingent nicht gesunken.
Beobachteter Verbrauch:
0
Ich behaupte damit natürlich nicht, dass das eine allgemeine Regel darüber wäre, wie OpenAI diese Art von Nutzung abrechnet oder verbucht.
Ich stelle nur fest: Während dieses Versuchs hat diese Bastelei mein Codex-Kontingent nicht angetastet.
Das System hat bereits diesen Artikel produziert
Am Anfang antwortete mein erster Google-Sheets-Hack auf eine recht begrenzte Frage:
Wie hole ich eine Information aus ChatGPT heraus und bewahre sie dauerhaft auf?
Ein paar Tage später lautete die Frage:
Und wenn ich das ganze strukturierte Gedächtnis des Kontexts herausholen würde?
Genau das leistet dieses System am Ende.
ChatGPT muss sich nicht mehr „an alles erinnern“.
Es muss vor allem wissen:
- wo es suchen soll;
- was es laden soll;
- was es persistieren soll;
- wie es die Information einordnet;
- wie es findet, was bereits gelernt wurde;
- wo die Arbeit steht.
Die Formel bleibt recht einfach:
ChatGPT denkt.
Die Direktiven definieren die Engine.
Google Sheets erinnert sich.
Und es liegt etwas ziemlich Befriedigendes darin, dass die Vorbereitung und das Schreiben dieses Artikels selbst dazu gedient haben, das System zu testen, das der Artikel beschreibt.
Für diesen Text habe ich ausschließlich diesen Kontext in ChatGPT genutzt.
Ich habe dort meine Ideen persistiert.
Ich habe sie eingespeist.
Wir haben blinde Flecken gefunden.
Ich habe Formulierungen korrigiert.
Wir haben Aufgaben angelegt und dann abgeschlossen.
Ich habe die fehlenden Elemente ergänzt.
Dann habe ich eine erste Fassung des Artikels produziert, sie noch einmal gelesen und denselben Kontext für die Vorbereitung dieser V2 genutzt.
Anders gesagt: Das System hat nicht nur als technischer Demonstrator gedient.
Es wurde bereits eingesetzt, um wirklich die Arbeit zu tun, für die ich es gebaut habe.
Die Frage lautet also nicht mehr wirklich:
Funktioniert das?
Es funktioniert.
Die Frage, die mich jetzt interessiert, lautet eher:
Bleibt diese Architektur genauso praktisch, wenn derselbe Kontext vor Ort eine ganze Woche Fachmessen aushalten muss?
Das wird die weitere Nutzung zeigen.