Scritto originalmente in francese. Tradotto dall'IA — il significato è stato preservato, non la prosa.
Questo tema è approfondito nel mio libro Le Contexte. Per leggerlo, scaricalo o acquistalo su Amazon. L’edizione Amazon è disponibile solo in francese; se desideri una versione in un’altra lingua, contattami.
Questo articolo fa seguito a «Persisti questo»: far uscire un'informazione da ChatGPT verso un archivio permanente.
In quel primo montaggio artigianale avevo scoperto una cosa piuttosto semplice, ma che cambiava parecchio: ChatGPT poteva scrivere un'informazione dentro Google Sheets e quindi farla uscire dalla propria finestra di contesto.
In altre parole, potevo dargli una memoria esterna persistente.
In quel momento Google Sheets mi serviva sostanzialmente come casella di uscita.
Poi mi sono posto un'altra domanda:
questo stesso meccanismo poteva bastare a far girare direttamente dentro ChatGPT il mio sistema di Contesti?
Perché volevo togliere il Contesto dal Mac
Da un po' di tempo uso dei Contesti con Codex e Claude Code.
E quando parlo di «Contesto» non parlo semplicemente di uno storico di conversazione o di un posto dove mettere qualche nota.
La definizione che uso è molto più ampia:
Un Contesto è un sistema delimitato da una missione umana, dentro il quale un'IA organizza e mobilita ciò che si sa, da dove lo si sa, come gli elementi si collegano e a che punto è il lavoro, per aiutare l'umano a raggiungere il suo obiettivo senza ripartire da zero. Così facendo, il sistema costituisce e fa fruttare un capitale informativo duraturo: la conoscenza prodotta resta disponibile, si arricchisce nel tempo e può essere riutilizzata per altri obiettivi.
Avevo già costruito un motore che faceva funzionare questo principio con Codex o Claude Code.
Sul mio Mac funziona bene.
Dal telefono avevo trovato anche una soluzione: accedere da remoto a Codex che gira sul Mac.
Ma ha una debolezza abbastanza evidente.
Serve che:
- il Mac sia acceso;
- resti connesso a Internet;
- l'accesso remoto funzioni.
A casa non è un gran problema.
Sul campo, molto di più.
Il caso che mi interessava in particolare erano due fiere di settore in arrivo: partire una settimana solo con il telefono, parlare con gli espositori, raccogliere informazioni, preparare interviste ed eventualmente produrre un articolo lo stesso giorno.
Non avevo voglia di dipendere da un Mac acceso da qualche parte a decine o centinaia di chilometri.
Mi sono quindi chiesto se potevo toglierlo del tutto dall'equazione.
La svolta: ChatGPT aveva già quasi tutto
Guardando il problema da un'altra angolazione, mi sono reso conto che un motore di Contesto aveva in fondo bisogno di tre grandi blocchi.
- Serve un motore capace di ragionare sull'informazione.
- ChatGPT lo sa già fare.
- Servono regole che spieghino al motore come lavorare.
- Le direttive di Progetto ChatGPT possono svolgere questo ruolo.
- E serve infine una memoria che sopravviva alle conversazioni.
- Era il pezzo che mancava.
La mia architettura poteva quindi diventare:
Motore       → ChatGPT
Direttive    → Progetto ChatGPT
Persistenza  → Google Sheets
L'hack di persistenza del mio articolo precedente offriva proprio questo terzo blocco.
Da lì, portare il mio motore di Contesto dentro ChatGPT è diventato molto meno esotico.
Non avevo bisogno di ricreare un sistema completo attorno a ChatGPT.
Il motore IA era già lì.
Bisognava soprattutto dargli le sue regole e una memoria esterna che lui sapesse leggere e modificare.
Come ho portato il motore dentro ChatGPT
All'inizio ho provato a mettere tutte le regole del motore direttamente nelle direttive del Progetto.
Non ha retto a lungo.
Le direttive di Progetto sono limitate a circa 8.000 caratteri e il mio motore aveva già bisogno di molto di più.
Ho quindi separato le regole in due livelli.
Il primo livello è il CORE.
È la parte messa direttamente nelle direttive del Progetto ChatGPT.
Contiene gli elementi assolutamente indispensabili al funzionamento del motore:
- che cos'è un Contesto;
- dove è archiviato;
- quali comandi esistono;
- come aprire un Contesto;
- come persistere una fonte;
- la struttura dei file;
- i principali invarianti;
- la gerarchia delle direttive.
Il secondo livello è una direttiva estesa.
È molto più voluminosa e vive in un Google Doc.
Contiene per esempio:
- il metodo dettagliato di ingestione;
- i criteri di creazione delle conoscenze atomiche;
- la gestione dello state e della synthesis;
- le decisioni;
- le contraddizioni;
- i todo;
- le strategie di lettura;
- le regole di produzione;
- la gestione degli errori e dei casi limite.
La gerarchia diventa:
CORE
  ↓
Direttiva estesa
  ↓
Direttive proprie del Contesto
Il CORE sa dove si trova la direttiva estesa e dice a ChatGPT di caricarla all'inizio di una nuova conversazione.
La separazione non è quindi lì solo per rendere il sistema più elegante.
Risponde prima di tutto a un vincolo molto concreto: l'intero motore non ci sta nelle direttive di un Progetto ChatGPT.
Google Sheets diventa la memoria del Contesto
Restava poi da rappresentare il Contesto stesso.
Avrei potuto usare più Google Docs.
- Un documento per le fonti.
- Un altro per lo stato.
- Un altro per le conoscenze.
- Un altro per le attività.
- ...
Ma mi sarei ritrovato in fretta con una moltitudine di file da ritrovare e altrettanti identificativi da gestire (torneremo più avanti su questo vincolo tecnologico).
Google Sheets si è rivelato molto più pratico.
Un Contesto corrisponde a uno Spreadsheet.
Dentro lo Spreadsheet, ogni tipo di informazione ha la sua scheda.
Attualmente uso questa struttura:
00-FRAME
01-STATE
03-SESSIONS
04-ATOMIC
05-OUTPUTS
00-FRAME contiene in particolare la missione e le eventuali direttive proprie del Contesto.
01-STATE contiene le informazioni necessarie a sapere a che punto è il lavoro:
- state;
- synthesis;
- todo;
- decisioni;
- contraddizioni;
- handoff.
03-SESSIONS contiene le fonti grezze persistite.
04-ATOMIC contiene le conoscenze stabilizzate.
05-OUTPUTS contiene i deliverable prodotti a partire dal Contesto.
Google Sheets non è quindi più soltanto il posto in cui ChatGPT scrive un'informazione per conservarla.
Lo Spreadsheet diventa l'intera memoria strutturata del Contesto.
Soprattutto non ricaricare tutto
Questo non vuol dire che ChatGPT carichi tutto lo Spreadsheet a ogni conversazione.
Sarebbe probabilmente una pessima idea.
Quando scrivo:
Apri Il Mio Contesto
ChatGPT comincia col ritrovare lo Spreadsheet corrispondente.
Poi carica solo il suo nucleo:
- missione;
- direttive;
- state;
- synthesis;
- todo;
- decisioni;
- contraddizioni;
- handoff.
Le fonti, le conoscenze atomiche e i vecchi output restano nello Sheet.
ChatGPT va a cercarli solo quando diventano necessari.
È un punto importante nel modo in cui penso il sistema.
La memoria non funziona così:
rimetto tutto quello che so nel prompt a ogni conversazione.
Funziona piuttosto così:
ho una memoria esterna in cui posso andare a ritrovare l'informazione pertinente nel momento in cui diventa utile.
Il Contesto diventa una memoria esterna indirizzabile.
Il dettaglio che faceva perdere moltissimo tempo
In una prima versione non avevo ancora ottimizzato la risoluzione degli identificativi Google.
Ogni volta che ChatGPT voleva leggere o scrivere in un Contesto, doveva cercare lo Spreadsheet corrispondente e poi ritrovarne l'ID.
E all'operazione successiva ricominciava.
Funzionava, ma certe operazioni potevano avvicinarsi ai cinquanta secondi.
Una parte importante del tempo serviva semplicemente a ritrovare qualcosa che era già stato trovato pochi secondi prima.
Ho quindi aggiunto una regola molto semplice.
Una volta aperto il Contesto, ChatGPT conserva per tutta la conversazione:
nome del Contesto
→ Spreadsheet
→ Spreadsheet ID
Tutte le operazioni successive usano direttamente questo ID.
Viene risolto di nuovo solo se:
- si cambia Contesto;
- l'ID non è più disponibile;
- l'accesso fallisce.
Sembra abbastanza ovvio.
Ma cambia moltissimo la fluidità del sistema.
Persistere non è imparare
Il motore in sé espone alla fine pochissimi comandi.
Apri <contesto>
Persisti <contenuto>
Todo <azione>
Ingerisci
Salva
Apri carica un Contesto.
Persisti conserva una nuova fonte.
Todo aggiunge un'azione da fare.
Ingerisci analizza le nuove fonti e aggiorna la conoscenza strutturata (creazione o arricchimento di note).
Salva aggiorna gli elementi che permettono di riprendere correttamente la missione in una prossima conversazione.
Ma la distinzione più importante del sistema è probabilmente questa:
Persisti non è Ingerisci.
Quando dico:
Persisti ...
non sto chiedendo al motore di considerare vero quello che ho appena detto.
Sto chiedendo soltanto:
conserva questa materia.
Diventa una fonte.
Durante l'ingestione, il motore può poi stabilire che ciò che contiene corrisponde a:
- una decisione realmente presa;
- un'attività;
- una contraddizione;
- un'informazione utile allo stato attuale;
- una conoscenza abbastanza stabilizzata da diventare una nota atomica;
- oppure semplicemente qualcosa da conservare come fonte senza andare oltre.
Questo evita una deriva che mi sembra particolarmente pericolosa nei sistemi di memoria per IA.
Se ogni produzione dell'IA diventa automaticamente una conoscenza del sistema, l'IA finisce per poter usare le proprie produzioni precedenti come prova.
Cerco quindi di mantenere una separazione netta:
fonte ≠ conoscenza ≠ stato ≠ sintesi ≠ deliverable
Una fonte dice:
ecco cosa è stato detto o osservato.
Una conoscenza stabilizzata dice un'altra cosa:
ecco cosa il sistema considera ormai abbastanza stabilito e riutilizzabile.
Un Contesto in tasca
È sul telefono che questo trasferimento diventa davvero interessante per me.
Lavoro già moltissimo in dettatura vocale.
E in questo caso preciso cambia completamente il rapporto con il sistema.
Riprendiamo l'esempio di una fiera di settore.
Arrivo con un Contesto già preparato.
Dal telefono:
Apri Fiera-X
Parlo con un primo espositore.
Uscendo dallo stand non ho per forza voglia di fermarmi, aprire un'app di note e scrivere cinque minuti su una tastierina.
Cammino verso lo stand successivo e detto semplicemente a ChatGPT quello che ho appena imparato.
Poi:
Persisti <quello che ho appena dettato>
Può prendere qualche decina di secondi.
Continuo la mia giornata.
Dopo diverse conversazioni:
Ingerisci
Il motore comincia allora a strutturare quello che ho raccolto.
Ed è lì che l'uso diventa più interessante di un semplice sistema per prendere appunti.
Posso chiedere a ChatGPT:
Cosa mi manca ancora per capire davvero questo argomento?
Oppure:
Quali contraddizioni dovrei verificare con il prossimo espositore?
O ancora:
Quali domande importanti non ho ancora fatto a nessuno?
Posso avere la risposta mentre sono ancora in fiera.
E quindi andare subito a fare le domande che mancano.
Il ciclo diventa:
conversazione
   ↓
dettatura vocale camminando
   ↓
Persisti
   ↓
Ingerisci
   ↓
cercare gli angoli ciechi
   ↓
tornare a fare domande
   ↓
completare il Contesto
È probabilmente quello che cambia di più il mio uso.
L'IA non interviene più solo dopo la raccolta per aiutarmi a produrre qualcosa.
Può intervenire durante la raccolta, quando è ancora possibile migliorare la qualità dell'informazione.
Plaud: far entrare le conversazioni nel Contesto
Uso anche un Plaud Note Pro.
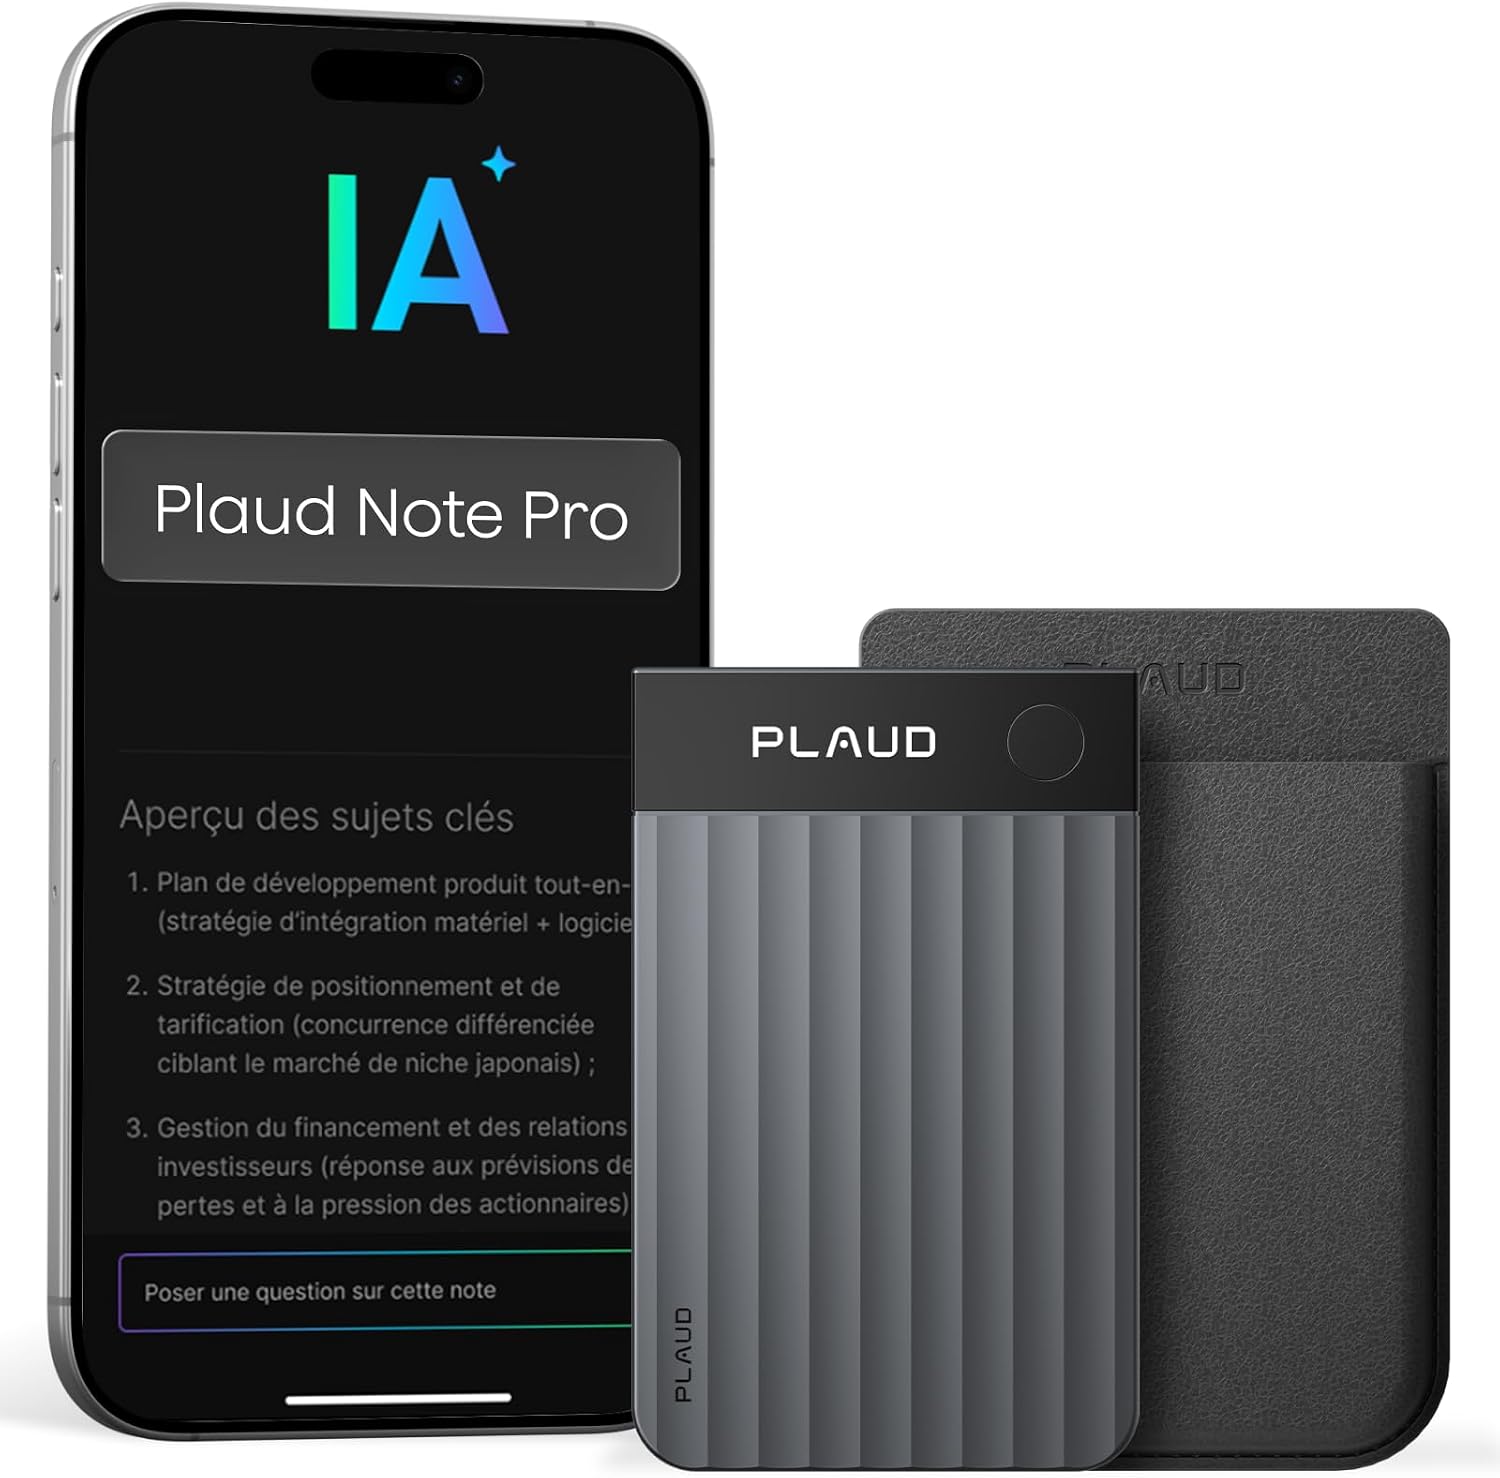
Il mio Plaud Note Pro, che posso usare per registrare conversazioni e interviste sul campo.
Plaud Note Pro è un piccolo registratore vocale che si può usare per registrare riunioni, conversazioni o interviste.
La registrazione è poi disponibile in Plaud e può essere trascritta.
Per il mio sistema, però, non è il riassunto automatico prodotto da Plaud che mi interessa di più.
Voglio recuperare la trascrizione completa.
E c'è un altro pezzo importante: ChatGPT può accedere direttamente a Plaud tramite il suo connettore.
Posso quindi chiedere, da ChatGPT, per esempio:
Elencami le mie tre ultime registrazioni Plaud e dimmi in una riga di cosa parla ciascuna.
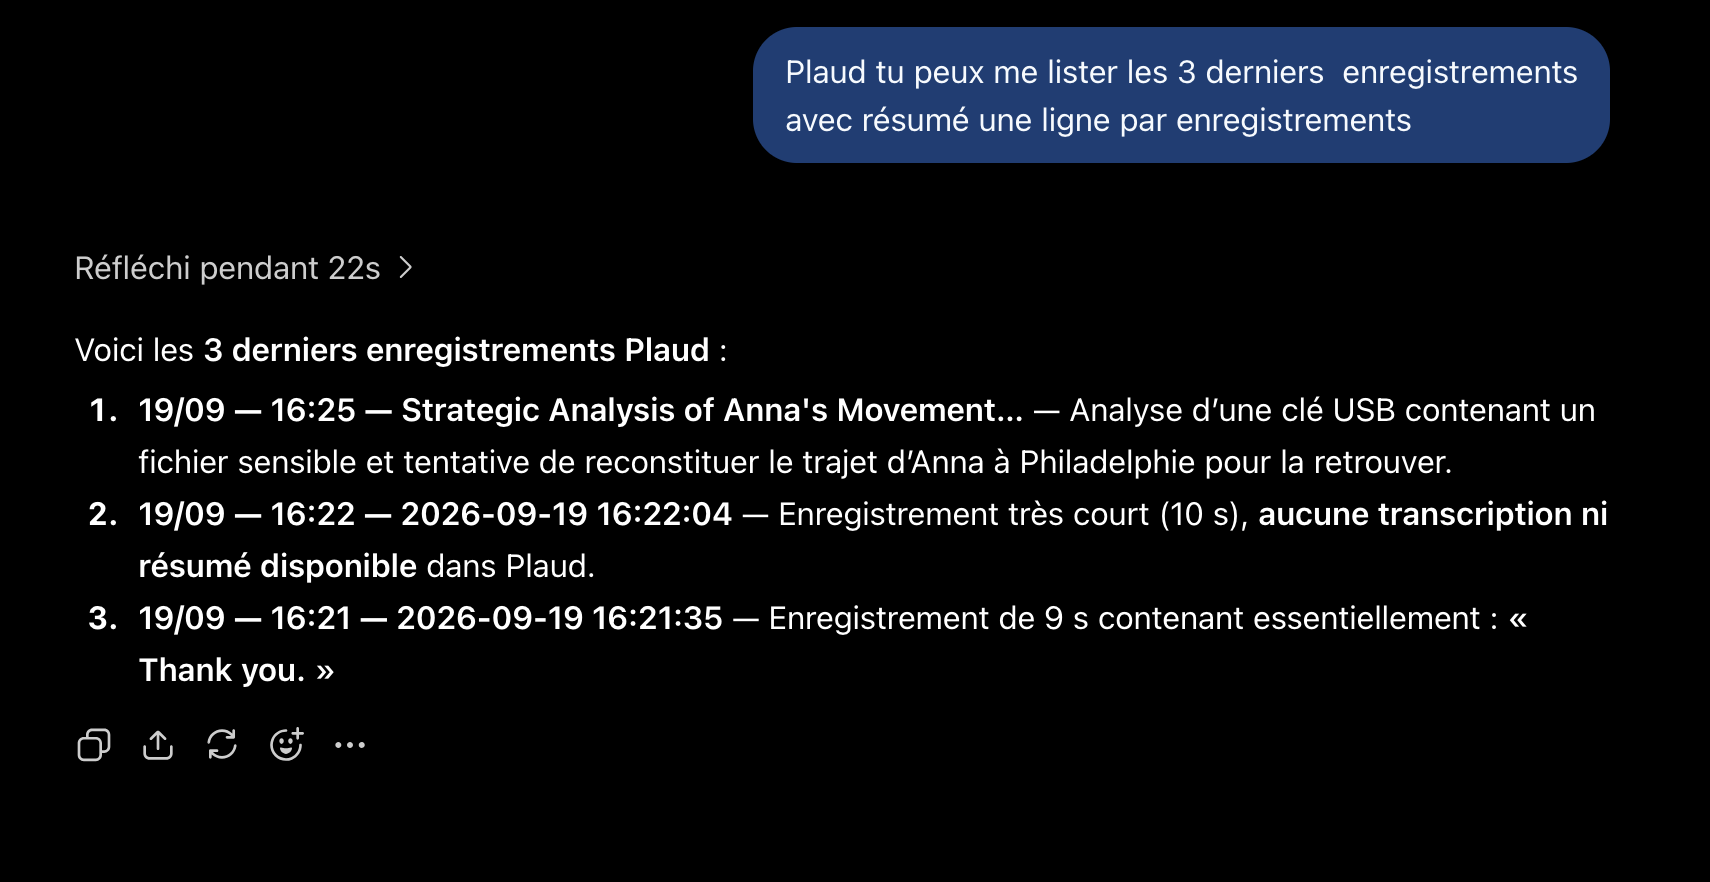
Esempio di interrogazione di Plaud da ChatGPT per ritrovare le ultime registrazioni.
ChatGPT può ritrovare queste registrazioni e poi recuperarne direttamente la trascrizione.
Questo permette di immaginare un workflow molto più diretto:
conversazione reale
        ↓
Plaud
        ↓
trascrizione
        ↓
ChatGPT recupera direttamente la trascrizione
        ↓
Persisti
        ↓
fonte grezza del Contesto
        ↓
Ingerisci
Non ho quindi bisogno di:
- scaricare manualmente un file;
- aprire la trascrizione;
- copiarla;
- tornare in ChatGPT;
- incollarla.
Posso fare tutto questo automaticamente, a voce, dal telefono.
E preferisco far entrare nel Contesto la trascrizione grezza completa invece di un semplice riassunto.
Il riassunto è già un'interpretazione.
La trascrizione resta molto più vicina alla materia di partenza.
Una volta che la conversazione è nel Contesto, posso chiedere:
- cosa mi ha davvero insegnato questa persona?
- cosa contraddice le conversazioni precedenti?
- quali affermazioni meritano una verifica?
- quali domande dovrei fare alla prossima persona?
I diversi blocchi necessari funzionano già.
Non ho però ancora messo alla prova a sufficienza, dall'inizio alla fine, questo workflow Plaud → ChatGPT → Contesto in lunghe giornate sul campo per dire che sia perfettamente fluido.
È quindi ancora un uso da testare di più.
Come riprodurre il sistema
Ho preparato due file che corrispondono ai due livelli di direttive del motore.
Il CORE
Il CORE è disponibile qui:
È questa la parte da copiare nelle direttive del Progetto ChatGPT.
La direttiva estesa
La direttiva dettagliata è disponibile qui:
Va copiata in un Google Doc a cui ChatGPT possa accedere.
Prima di cominciare bisogna ovviamente collegare Google Drive a ChatGPT e permettergli di accedere ai documenti usati dal motore.
Configurare gli ID
Il CORE contiene in particolare due identificativi:
DOCUMENT_ID = xxxx
FOLDER_ID = xxxx
DOCUMENT_ID corrisponde al Google Doc che contiene la direttiva estesa.
In un URL come:
https://docs.google.com/document/d/xxxx/edit
la parte xxxx è l'identificativo del documento.
FOLDER_ID corrisponde alla cartella Google Drive in cui verranno archiviati i Contesti.
Per un URL come:
https://drive.google.com/drive/folders/xxxx
l'identificativo è di nuovo la parte xxxx.
Ogni utente deve ovviamente sostituire questi valori con quelli del proprio ambiente.
Uno Spreadsheet per Contesto
Quando viene creato un nuovo Contesto, il motore crea uno Spreadsheet che contiene:
00-FRAME
01-STATE
03-SESSIONS
04-ATOMIC
05-OUTPUTS
Viene poi messo nella cartella definita da FOLDER_ID.
Non serve ricopiare a mano l'identificativo di ciascuno di questi Spreadsheet nelle direttive.
Quando chiedo:
Apri Il Mio Contesto
ChatGPT cerca lo Spreadsheet corrispondente nella cartella dei Contesti, ne recupera l'ID e poi lo conserva per tutta la conversazione.
Il sistema è allora operativo.
Cosa permette questo montaggio artigianale — e i suoi limiti
Questa versione ChatGPT non sostituisce il mio motore usato con Codex o Claude Code.
Non era l'obiettivo.
Ha diversi limiti.
È più lenta.
È meno adatta a Contesti che richiedono direttamente script Python, chiamate API o un ambiente di esecuzione più ricco.
E soprattutto, mi manca ancora prospettiva sul suo comportamento quando un Contesto cresce davvero nel giro di diverse settimane.
La vedo quindi come una modalità autonoma complementare.
Sul mio Mac, Codex o Claude Code restano più adatti a certe missioni.
Ma dal telefono posso ora usare un Contesto senza dipendere dal fatto che il mio Mac sia acceso e raggiungibile.
Ed era esattamente il problema che volevo risolvere.
C'è anche un'osservazione divertente legata alla quota Codex.
Per tutta questa sperimentazione dentro ChatGPT, la quota Codex mostrata non è diminuita.
Consumo osservato:
0
Non pretendo ovviamente che questo costituisca una regola generale sul modo in cui OpenAI fattura o conteggia questo tipo di uso.
Constato semplicemente che, durante questo esperimento, questo montaggio artigianale non ha consumato la mia quota Codex.
Il sistema è già servito a produrre questo articolo
All'inizio, il mio primo hack Google Sheets rispondeva a una domanda abbastanza limitata:
come far uscire un'informazione da ChatGPT e conservarla a lungo?
Qualche giorno dopo la domanda era diventata:
e se facessi uscire tutta la memoria strutturata del Contesto?
È alla fine quello che fa questo sistema.
ChatGPT non ha più bisogno di «ricordarsi tutto».
Deve soprattutto sapere:
- dove cercare;
- cosa caricare;
- cosa persistere;
- come qualificare l'informazione;
- come ritrovare ciò che è già stato imparato;
- a che punto è il lavoro.
La formula resta abbastanza semplice:
ChatGPT ragiona.
Le direttive definiscono il motore.
Google Sheets ricorda.
E c'è qualcosa di abbastanza soddisfacente nel fatto che la preparazione e la scrittura di questo articolo siano servite loro stesse a testare il sistema che l'articolo descrive.
Per preparare questo testo ho usato esclusivamente questo Contesto dentro ChatGPT.
Ci ho persistito le mie idee.
Le ho ingerite.
Abbiamo individuato degli angoli ciechi.
Ho corretto delle formulazioni.
Abbiamo creato e poi chiuso delle attività.
Ho aggiunto gli elementi mancanti.
Poi ho prodotto una prima versione dell'articolo, l'ho riletta e ho usato lo stesso Contesto per preparare questa V2.
In altre parole, il sistema non è servito soltanto come dimostratore tecnico.
È già stato usato per fare davvero il lavoro per cui l'ho costruito.
La domanda non è quindi più davvero:
funziona?
Funziona.
La domanda che mi interessa adesso è piuttosto:
questa architettura resterà altrettanto pratica quando lo stesso Contesto sarà messo alla prova sul campo durante una settimana intera di fiere di settore?
È quello che il seguito dell'uso permetterà di verificare.