Cet article fait suite à « Persiste ça : faire sortir une information de ChatGPT vers un stockage permanent ».
Dans ce premier bricolage, j'avais découvert quelque chose d'assez simple mais qui changeait beaucoup de choses : ChatGPT pouvait écrire une information dans Google Sheets et donc la faire sortir de sa propre fenêtre de contexte.
Autrement dit, je pouvais lui donner une mémoire externe persistante.
À ce moment-là, Google Sheets me servait essentiellement de boîte de sortie.
Puis je me suis posé une autre question :
est-ce que ce même mécanisme pouvait suffire à faire tourner directement dans ChatGPT mon système de Contextes ?
Pourquoi je voulais sortir le Contexte du Mac
J'utilise depuis quelque temps des Contextes avec Codex et Claude Code.
Et quand je parle de « Contexte », je ne parle pas simplement d'un historique de conversation ou d'un endroit où stocker quelques notes.
La définition que j'utilise est beaucoup plus large :
Un Contexte est un système borné par une mission humaine, dans lequel une IA organise et mobilise ce qu'on sait, d'où on le sait, comment les éléments se relient et où en est le travail, afin d'aider l'humain à atteindre son but sans repartir de zéro. Ce faisant, le système constitue et fait fructifier un capital informationnel durable : la connaissance produite reste disponible, s'enrichit dans le temps et peut être réutilisée pour d'autres objectifs.
J'avais déjà construit un moteur permettant de faire fonctionner ce principe avec Codex ou Claude Code.
Sur mon Mac, ça marche bien.
Depuis mon téléphone, j'avais également trouvé une solution : accéder à distance à Codex qui tourne sur le Mac.
Mais elle a une faiblesse assez évidente.
Il faut que :
- le Mac soit allumé ;
- il reste connecté à Internet ;
- l'accès distant fonctionne.
Chez moi, ce n'est pas très gênant.
Sur le terrain, beaucoup plus.
Le cas qui m'intéressait particulièrement était celui de deux salons professionnels à venir : partir une semaine uniquement avec mon téléphone, discuter avec des exposants, collecter de l'information, préparer des interviews et éventuellement produire un article le jour même.
Je n'avais pas envie de dépendre d'un Mac allumé quelque part à plusieurs dizaines ou centaines de kilomètres.
Je me suis donc demandé si je pouvais complètement l'enlever de l'équation.
Le déclic : ChatGPT avait déjà presque tout
En regardant le problème autrement, je me suis rendu compte qu'un moteur de Contexte avait finalement besoin de trois grandes briques.
- Il faut un moteur capable de raisonner sur l'information.
- ChatGPT sait déjà le faire.
- Il faut des règles qui expliquent au moteur comment travailler.
- Les directives de Projet ChatGPT peuvent jouer ce rôle.
- Et il faut enfin une mémoire qui survive aux conversations.
- C'était la pièce qui manquait.
Mon architecture pouvait donc devenir :
Moteur       → ChatGPT
Directives   → Projet ChatGPT
Persistance  → Google Sheets
Le hack de persistance de mon article précédent fournissait justement cette troisième brique.
À partir de là, le portage de mon moteur de Contexte dans ChatGPT est devenu beaucoup moins exotique.
Je n'avais pas besoin de recréer un système complet autour de ChatGPT.
Le moteur IA était déjà là.
Il fallait surtout lui donner ses règles et une mémoire externe qu'il savait lire et modifier.
Comment j'ai porté le moteur dans ChatGPT
Au départ, j'ai essayé de mettre toutes les règles du moteur directement dans les directives du Projet.
Ça n'a pas tenu très longtemps.
Les directives de Projet sont limitées à environ 8 000 caractères et mon moteur avait déjà besoin de beaucoup plus.
J'ai donc séparé les règles en deux niveaux.
Le premier niveau est le CORE.
C'est la partie placée directement dans les directives du Projet ChatGPT.
Elle contient les éléments absolument indispensables au fonctionnement du moteur :
- ce qu'est un Contexte ;
- où il est stocké ;
- quelles commandes existent ;
- comment ouvrir un Contexte ;
- comment persister une source ;
- la structure des fichiers ;
- les principaux invariants ;
- la hiérarchie des directives.
Le deuxième niveau est une directive étendue.
Elle est beaucoup plus volumineuse et vit dans un Google Doc.
Elle contient par exemple :
- la méthode détaillée d'ingestion ;
- les critères de création des connaissances atomiques ;
- la gestion du state et de la synthesis ;
- les décisions ;
- les contradictions ;
- les todo ;
- les stratégies de lecture ;
- les règles de production ;
- la gestion des erreurs et des cas limites.
La hiérarchie devient :
CORE
  ↓
Directive étendue
  ↓
Directives propres au Contexte
Le CORE sait où se trouve la directive étendue et indique à ChatGPT de la charger au début d'une nouvelle conversation.
La séparation n'est donc pas là uniquement pour rendre le système plus élégant.
Elle répond d'abord à une contrainte très concrète : tout le moteur ne tient pas dans les directives d'un Projet ChatGPT.
Google Sheets devient la mémoire du Contexte
Il restait ensuite à représenter le Contexte lui-même.
J'aurais pu utiliser plusieurs Google Docs.
- Un document pour les sources.
- Un autre pour l'état.
- Un autre pour les connaissances.
- Un autre pour les tâches.
- ...
Mais j'aurais rapidement obtenu une multitude de fichiers à retrouver et autant d'identifiants à gérer (on verra cette contrainte technologique plus tard).
Google Sheets s'est révélé beaucoup plus pratique.
Un Contexte correspond à un Spreadsheet.
À l'intérieur du Spreadsheet, chaque type d'information possède son onglet.
J'utilise actuellement cette structure :
00-FRAME
01-STATE
03-SESSIONS
04-ATOMIC
05-OUTPUTS
00-FRAME contient notamment la mission et les éventuelles directives propres au Contexte.
01-STATE contient les informations nécessaires pour savoir où en est le travail :
- state ;
- synthesis ;
- todo ;
- décisions ;
- contradictions ;
- handoff.
03-SESSIONS contient les sources brutes persistées.
04-ATOMIC contient les connaissances stabilisées.
05-OUTPUTS contient les livrables produits à partir du Contexte.
Google Sheets n'est donc plus seulement l'endroit dans lequel ChatGPT écrit une information pour la sauvegarder.
Le Spreadsheet devient la mémoire structurée complète du Contexte.
Ne surtout pas tout recharger
Cela ne signifie pas pour autant que ChatGPT charge l'intégralité du Spreadsheet à chaque conversation.
Ce serait probablement une très mauvaise idée.
Quand j'écris :
Ouvre Mon Contexte
ChatGPT commence par retrouver le Spreadsheet correspondant.
Puis il ne charge que son noyau :
- mission ;
- directives ;
- state ;
- synthesis ;
- todo ;
- décisions ;
- contradictions ;
- handoff.
Les sources, les connaissances atomiques et les anciens outputs restent dans le Sheet.
ChatGPT va les chercher seulement lorsqu'ils deviennent nécessaires.
C'est un point important dans la manière dont je conçois le système.
La mémoire ne fonctionne pas comme :
je remets tout ce que je sais dans le prompt à chaque conversation.
Elle fonctionne plutôt comme :
j'ai une mémoire externe dans laquelle je peux aller retrouver l'information pertinente au moment où elle devient utile.
Le Contexte devient une mémoire externe adressable.
Le détail qui faisait perdre énormément de temps
Dans une première version, je n'avais pas encore optimisé la résolution des identifiants Google.
À chaque fois que ChatGPT voulait lire ou écrire dans un Contexte, il devait rechercher le Spreadsheet correspondant puis retrouver son ID.
Et à l'opération suivante, il recommençait.
Cela fonctionnait, mais certaines opérations pouvaient approcher la cinquantaine de secondes.
Une partie importante du temps était simplement consacrée à retrouver quelque chose qui avait déjà été trouvé quelques secondes auparavant.
J'ai donc ajouté une règle très simple.
Une fois le Contexte ouvert, ChatGPT conserve pendant la conversation :
nom du Contexte
→ Spreadsheet
→ Spreadsheet ID
Toutes les opérations suivantes utilisent directement cet ID.
Il n'est résolu à nouveau que si :
- on change de Contexte ;
- l'ID n'est plus disponible ;
- l'accès échoue.
Ça paraît assez évident.
Mais ça change énormément la fluidité du système.
Persister n'est pas apprendre
Le moteur lui-même expose finalement très peu de commandes.
Ouvre <contexte>
Persiste <contenu>
Todo <action>
Ingère
Sauvegarde
Ouvre charge un Contexte.
Persiste conserve une nouvelle source.
Todo ajoute une action à réaliser.
Ingère analyse les nouvelles sources et met à jour la connaissance structurée (création ou enrichissement de notes).
Sauvegarde remet à jour les éléments permettant de reprendre correctement la mission lors d'une prochaine conversation.
Mais la distinction la plus importante du système est probablement celle-ci :
Persiste n'est pas Ingère.
Quand je dis :
Persiste ...
je ne demande pas au moteur de considérer ce que je viens de dire comme vrai.
Je demande uniquement :
conserve cette matière.
Elle devient une source.
Lors de l'ingestion, le moteur peut ensuite déterminer que ce qu'elle contient correspond à :
- une décision réellement actée ;
- une tâche ;
- une contradiction ;
- une information utile à l'état courant ;
- une connaissance suffisamment stabilisée pour devenir une note atomique ;
- ou simplement quelque chose qu'il faut conserver comme source sans aller plus loin.
Cela évite une dérive qui me semble particulièrement dangereuse dans les systèmes de mémoire pour IA.
Si toute production de l'IA devient automatiquement une connaissance du système, l'IA finit par pouvoir utiliser ses propres productions précédentes comme preuve.
J'essaie donc de conserver une séparation stricte :
source ≠ connaissance ≠ état ≠ synthèse ≠ livrable
Une source dit :
voilà ce qui a été dit ou observé.
Une connaissance stabilisée dit autre chose :
voilà ce que le système considère désormais comme suffisamment établi et réutilisable.
Un Contexte dans la poche
C'est sur téléphone que ce portage devient réellement intéressant pour moi.
Je travaille déjà énormément en dictée vocale.
Et dans ce cas précis, ça change complètement le rapport au système.
Prenons à nouveau l'exemple d'un salon professionnel.
J'arrive avec un Contexte déjà préparé.
Depuis mon téléphone :
Ouvre Salon-X
Je discute avec un premier exposant.
En sortant du stand, je n'ai pas forcément envie de m'arrêter, d'ouvrir une application de notes et de taper pendant cinq minutes sur un petit clavier.
Je marche vers le stand suivant et je dicte simplement à ChatGPT ce que je viens d'apprendre.
Puis :
Persiste <ce que je viens de dicter>
Cela peut prendre quelques dizaines de secondes.
Je continue ma journée.
Après plusieurs discussions :
Ingère
Le moteur commence alors à structurer ce que j'ai collecté.
Et c'est là que l'usage devient plus intéressant qu'un simple système de prise de notes.
Je peux demander à ChatGPT :
Qu'est-ce qui me manque encore pour réellement comprendre ce sujet ?
Ou :
Quelles contradictions devrais-je vérifier auprès du prochain exposant ?
Ou encore :
Quelles questions importantes n'ai-je encore posées à personne ?
Je peux obtenir cette réponse alors que je suis encore sur le salon.
Et donc aller poser immédiatement les questions manquantes.
Le cycle devient :
discussion
   ↓
dictée vocale en marchant
   ↓
Persiste
   ↓
Ingère
   ↓
chercher les angles morts
   ↓
retourner poser des questions
   ↓
compléter le Contexte
C'est probablement ce qui change le plus mon usage.
L'IA n'intervient plus seulement après la collecte pour m'aider à produire quelque chose.
Elle peut intervenir pendant la collecte, lorsqu'il est encore possible d'améliorer la qualité de l'information.
Plaud : faire entrer les conversations dans le Contexte
J'utilise également un Plaud Note Pro.
Mon Plaud Note Pro, que je peux utiliser pour enregistrer des conversations et des interviews sur le terrain.
Plaud Note Pro est un petit enregistreur vocal que l'on peut utiliser pour enregistrer des réunions, des conversations ou des interviews.
L'enregistrement est ensuite disponible dans Plaud et peut être transcrit.
Pour mon système, ce n'est cependant pas le résumé automatique produit par Plaud qui m'intéresse le plus.
Je veux récupérer la transcription complète.
Et il y a une autre pièce importante : ChatGPT peut accéder directement à Plaud via son connecteur.
Je peux donc, depuis ChatGPT, demander par exemple :
Liste-moi mes trois derniers enregistrements Plaud et donne-moi en une ligne pour chacun ce dont il parle.
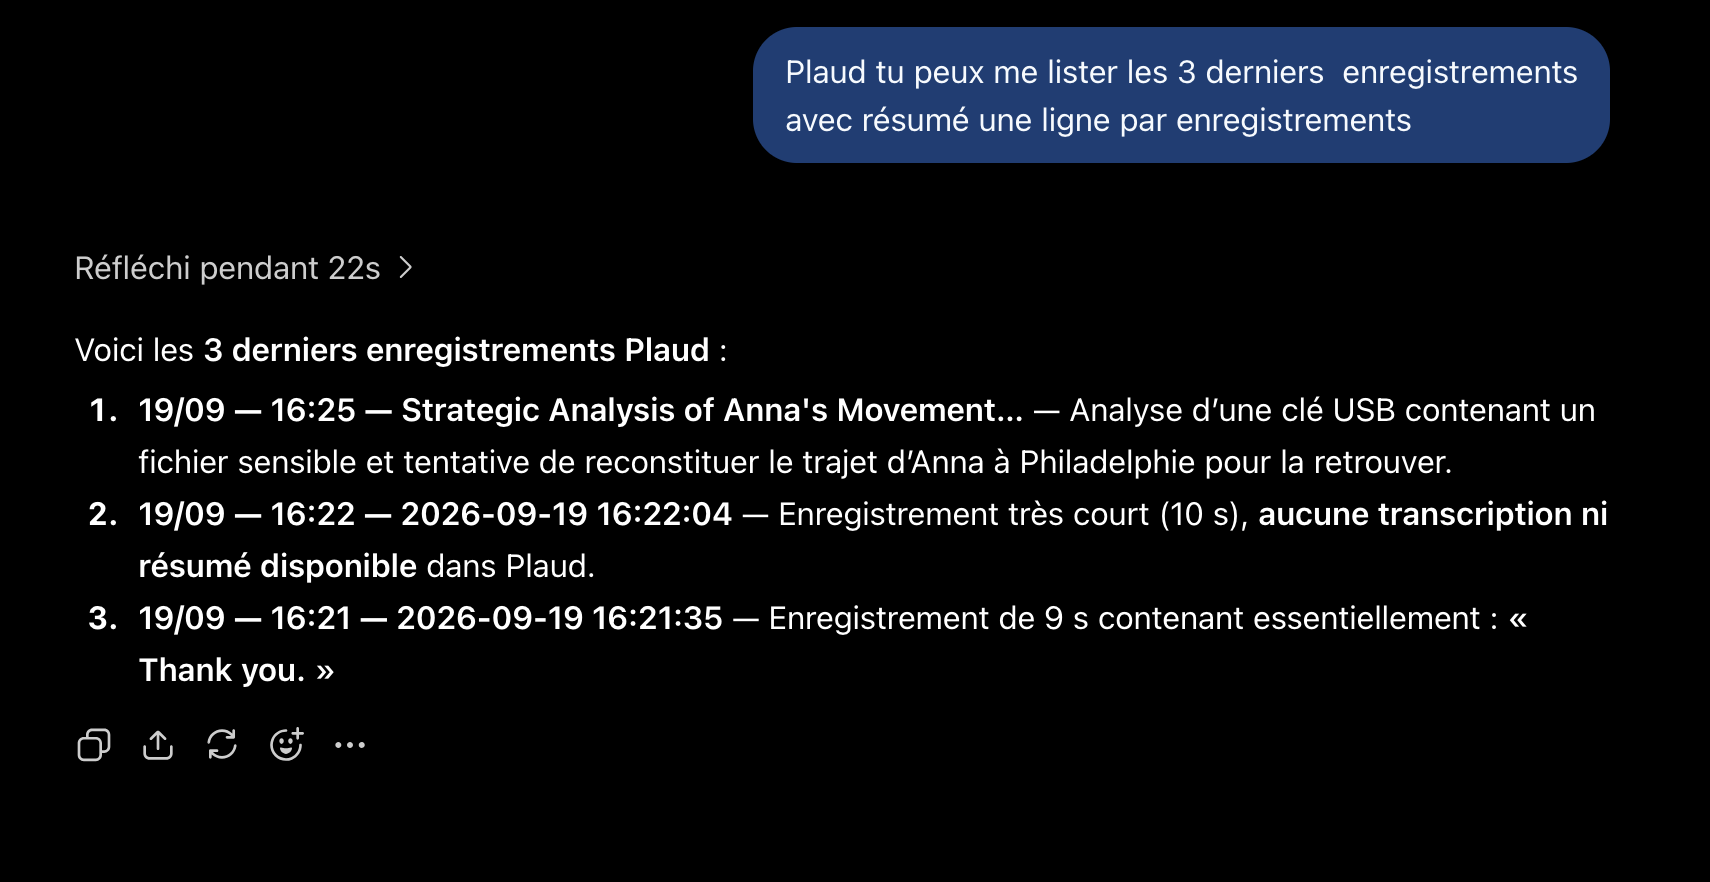
Exemple d'interrogation de Plaud depuis ChatGPT pour retrouver les derniers enregistrements.
ChatGPT peut retrouver ces enregistrements puis récupérer directement leur transcription.
Cela permet d'imaginer un workflow beaucoup plus direct :
conversation réelle
        ↓
Plaud
        ↓
transcription
        ↓
ChatGPT récupère directement la transcription
        ↓
Persiste
        ↓
source brute du Contexte
        ↓
Ingère
Je n'ai donc pas besoin de :
- télécharger manuellement un fichier ;
- ouvrir la transcription ;
- la copier ;
- revenir dans ChatGPT ;
- la coller.
Je peux faire tout cela automatiquement, en vocal, depuis mon téléphone.
Et je préfère faire entrer dans le Contexte la transcription brute complète plutôt qu'un simple résumé.
Le résumé est déjà une interprétation.
La transcription reste beaucoup plus proche de la matière source.
Une fois la conversation dans le Contexte, je peux demander :
- qu'est-ce que cette personne vient réellement de m'apprendre ?
- qu'est-ce qui contredit les conversations précédentes ?
- quelles affirmations méritent d'être vérifiées ?
- quelles questions devrais-je poser à la prochaine personne ?
Les différentes briques nécessaires fonctionnent déjà.
En revanche, je n'ai pas encore suffisamment éprouvé de bout en bout ce workflow Plaud → ChatGPT → Contexte lors de longues journées terrain pour dire qu'il est parfaitement fluide.
C'est donc encore un usage à tester davantage.
Comment reproduire le système
J'ai préparé deux fichiers qui correspondent aux deux niveaux de directives du moteur.
Le CORE
Le CORE est disponible ici :
C'est cette partie qu'il faut copier dans les directives du Projet ChatGPT.
La directive étendue
La directive détaillée est disponible ici :
Elle doit être copiée dans un Google Doc auquel ChatGPT pourra accéder.
Avant de commencer, il faut évidemment connecter Google Drive à ChatGPT et lui permettre d'accéder aux documents utilisés par le moteur.
Configurer les IDs
Le CORE contient notamment deux identifiants :
DOCUMENT_ID = xxxx
FOLDER_ID = xxxx
DOCUMENT_ID correspond au Google Doc contenant la directive étendue.
Dans une URL comme :
https://docs.google.com/document/d/xxxx/edit
la partie xxxx est l'identifiant du document.
FOLDER_ID correspond au dossier Google Drive dans lequel seront stockés les Contextes.
Pour une URL comme :
https://drive.google.com/drive/folders/xxxx
l'identifiant est à nouveau la partie xxxx.
Chaque utilisateur doit évidemment remplacer ces valeurs par celles de son propre environnement.
Un Spreadsheet par Contexte
Lorsqu'un nouveau Contexte est créé, le moteur crée un Spreadsheet contenant :
00-FRAME
01-STATE
03-SESSIONS
04-ATOMIC
05-OUTPUTS
Il est ensuite placé dans le dossier défini par FOLDER_ID.
Il n'est pas nécessaire de recopier manuellement l'identifiant de chacun de ces Spreadsheets dans les directives.
Lorsque je demande :
Ouvre Mon Contexte
ChatGPT recherche le Spreadsheet correspondant dans le dossier des Contextes, récupère son ID puis le conserve pendant la conversation.
Le système est alors opérationnel.
Ce que ce bricolage permet — et ses limites
Cette version ChatGPT ne remplace pas mon moteur utilisé avec Codex ou Claude Code.
Ce n'était pas l'objectif.
Elle a plusieurs limites.
Elle est plus lente.
Elle est moins adaptée à des Contextes qui nécessitent directement des scripts Python, des appels API ou un environnement d'exécution plus riche.
Et surtout, je manque encore de recul sur son comportement lorsqu'un Contexte grossit réellement pendant plusieurs semaines.
Je la vois donc comme un mode autonome complémentaire.
Sur mon Mac, Codex ou Claude Code restent plus adaptés à certaines missions.
Mais depuis mon téléphone, je peux maintenant utiliser un Contexte sans dépendre du fait que mon Mac soit allumé et joignable.
Et c'était précisément le problème que je voulais résoudre.
Il y a également une observation amusante liée au quota Codex.
Pendant toute cette expérimentation dans ChatGPT, le quota Codex affiché n'a pas diminué.
Consommation observée :
0
Je ne prétends évidemment pas que cela constitue une règle générale sur la manière dont OpenAI facture ou comptabilise ce genre d'usage.
Je constate simplement que, pendant cette expérience, ce bricolage n'a pas consommé mon quota Codex.
Le système a déjà servi à produire cet article
Au départ, mon premier hack Google Sheets répondait à une question assez limitée :
comment faire sortir une information de ChatGPT et la conserver durablement ?
Quelques jours plus tard, la question était devenue :
et si je faisais sortir toute la mémoire structurée du Contexte ?
C'est finalement ce que fait ce système.
ChatGPT n'a plus besoin de « se souvenir de tout ».
Il doit surtout savoir :
- où chercher ;
- quoi charger ;
- quoi persister ;
- comment qualifier l'information ;
- comment retrouver ce qui a déjà été appris ;
- où en est le travail.
La formule reste assez simple :
ChatGPT raisonne.
Les directives définissent le moteur.
Google Sheets se souvient.
Et il y a quelque chose d'assez satisfaisant dans le fait que la préparation et la rédaction de cet article ont elles-mêmes servi à tester le système que l'article décrit.
Pour préparer ce texte, j'ai utilisé exclusivement ce Contexte dans ChatGPT.
J'y ai persisté mes idées.
Je les ai ingérées.
Nous avons identifié des angles morts.
J'ai corrigé des formulations.
Nous avons créé puis terminé des tâches.
J'ai ajouté les éléments manquants.
Puis j'ai produit une première version de l'article, je l'ai relue et j'ai utilisé le même Contexte pour préparer cette V2.
Autrement dit, le système n'a pas uniquement servi de démonstrateur technique.
Il a déjà été utilisé pour faire réellement le travail pour lequel je l'ai construit.
La question n'est donc plus vraiment :
est-ce que ça fonctionne ?
Ça fonctionne.
La question qui m'intéresse maintenant est plutôt :
est-ce que cette architecture restera aussi pratique lorsque le même Contexte sera éprouvé sur le terrain lors d'une semaine complète de salons professionnels ?
C'est ce que la suite de l'usage va permettre de vérifier.