Escrito originalmente em francês. Traduzido por IA — o sentido foi preservado, não a prosa.
Este tema é aprofundado no meu livro Le Contexte. Para lê-lo, baixe-o ou compre-o na Amazon. A edição da Amazon está disponível apenas em francês; se você quiser uma versão em outro idioma, entre em contato comigo.
Este artigo dá sequência a "Persiste isso": tirar uma informação do ChatGPT e levá-la para um armazenamento permanente.
Naquela primeira gambiarra, eu tinha descoberto algo bem simples, mas que mudava muita coisa: o ChatGPT conseguia escrever uma informação no Google Sheets e, portanto, tirá-la da própria janela de contexto.
Em outras palavras, eu podia dar a ele uma memória externa persistente.
Naquele momento, o Google Sheets funcionava basicamente como caixa de saída.
Depois veio outra pergunta:
será que esse mesmo mecanismo bastaria para rodar direto no ChatGPT o meu sistema de Contextos?
Por que eu queria tirar o Contexto do Mac
Faz um tempo que uso Contextos com Codex e Claude Code.
E quando falo de "Contexto", não estou falando apenas de um histórico de conversa ou de um lugar onde guardar algumas notas.
A definição que uso é bem mais ampla:
Um Contexto é um sistema delimitado por uma missão humana, dentro do qual uma IA organiza e mobiliza o que se sabe, de onde se sabe, como os elementos se ligam entre si e em que pé está o trabalho, para ajudar o humano a chegar ao seu objetivo sem recomeçar do zero. Ao fazer isso, o sistema constitui e faz render um capital informacional duradouro: o conhecimento produzido continua disponível, se enriquece com o tempo e pode ser reaproveitado para outros objetivos.
Eu já tinha construído um motor capaz de fazer esse princípio funcionar com Codex ou Claude Code.
No meu Mac, funciona bem.
Pelo celular, eu também tinha achado uma saída: acessar à distância o Codex que roda no Mac.
Mas essa saída tem uma fraqueza bem evidente.
É preciso que:
- o Mac esteja ligado;
- ele continue conectado à internet;
- o acesso remoto funcione.
Em casa, isso não incomoda muito.
Em campo, incomoda bastante.
O caso que me interessava em especial era o de duas feiras profissionais que estavam por vir: passar uma semana levando só o celular, conversar com expositores, coletar informação, preparar entrevistas e, se desse, produzir um artigo no mesmo dia.
Eu não queria depender de um Mac ligado em algum lugar a dezenas ou centenas de quilômetros.
Então me perguntei se dava para tirar o Mac completamente da equação.
O estalo: o ChatGPT já tinha quase tudo
Olhando o problema de outro jeito, percebi que um motor de Contexto precisava, no fim das contas, de três grandes blocos.
- É preciso um motor capaz de raciocinar sobre a informação.
- O ChatGPT já sabe fazer isso.
- É preciso ter regras que expliquem ao motor como trabalhar.
- As diretrizes de Projeto do ChatGPT podem cumprir esse papel.
- E é preciso, por fim, uma memória que sobreviva às conversas.
- Essa era a peça que faltava.
Minha arquitetura podia, então, virar isto:
Motor         → ChatGPT
Diretrizes    → Projeto ChatGPT
Persistência  → Google Sheets
O hack de persistência do artigo anterior fornecia justamente esse terceiro bloco.
A partir daí, portar o meu motor de Contexto para dentro do ChatGPT ficou bem menos exótico.
Eu não precisava recriar um sistema inteiro em volta do ChatGPT.
O motor de IA já estava ali.
Faltava sobretudo dar a ele as suas regras e uma memória externa que ele soubesse ler e alterar.
Como portei o motor para o ChatGPT
No começo, tentei colocar todas as regras do motor direto nas diretrizes do Projeto.
Não durou muito tempo.
As diretrizes de Projeto são limitadas a cerca de 8.000 caracteres e o meu motor já precisava de bem mais que isso.
Então separei as regras em dois níveis.
O primeiro nível é o CORE.
É a parte que vai direto nas diretrizes do Projeto ChatGPT.
Ela contém os elementos absolutamente indispensáveis para o motor funcionar:
- o que é um Contexto;
- onde ele fica armazenado;
- quais comandos existem;
- como abrir um Contexto;
- como persistir uma fonte;
- a estrutura dos arquivos;
- os principais invariantes;
- a hierarquia das diretrizes.
O segundo nível é uma diretriz estendida.
Ela é bem mais volumosa e mora num Google Doc.
Ela contém, por exemplo:
- o método detalhado de ingestão;
- os critérios de criação dos conhecimentos atômicos;
- a gestão do state e da synthesis;
- as decisões;
- as contradições;
- os todo;
- as estratégias de leitura;
- as regras de produção;
- o tratamento de erros e de casos-limite.
A hierarquia fica assim:
CORE
  ↓
Diretriz estendida
  ↓
Diretrizes próprias do Contexto
O CORE sabe onde fica a diretriz estendida e diz ao ChatGPT para carregar essa diretriz no início de uma nova conversa.
A separação, portanto, não existe só para deixar o sistema mais elegante.
Ela responde antes de tudo a uma restrição bem concreta: o motor inteiro não cabe nas diretrizes de um Projeto ChatGPT.
O Google Sheets vira a memória do Contexto
Faltava ainda representar o próprio Contexto.
Eu poderia ter usado vários Google Docs.
- Um documento para as fontes.
- Outro para o estado.
- Outro para os conhecimentos.
- Outro para as tarefas.
- ...
Só que eu teria rapidamente um monte de arquivos para localizar e outros tantos identificadores para gerenciar (vamos ver essa restrição tecnológica mais adiante).
O Google Sheets se mostrou bem mais prático.
Um Contexto corresponde a um Spreadsheet.
Dentro do Spreadsheet, cada tipo de informação tem a sua aba.
Atualmente uso esta estrutura:
00-FRAME
01-STATE
03-SESSIONS
04-ATOMIC
05-OUTPUTS
00-FRAME contém, entre outras coisas, a missão e as eventuais diretrizes próprias do Contexto.
01-STATE contém as informações necessárias para saber em que pé está o trabalho:
- state;
- synthesis;
- todo;
- decisões;
- contradições;
- handoff.
03-SESSIONS contém as fontes brutas persistidas.
04-ATOMIC contém os conhecimentos estabilizados.
05-OUTPUTS contém os entregáveis produzidos a partir do Contexto.
O Google Sheets, portanto, não é mais apenas o lugar onde o ChatGPT escreve uma informação para guardá-la.
O Spreadsheet vira a memória estruturada completa do Contexto.
Nada de recarregar tudo
Isso não quer dizer que o ChatGPT carregue o Spreadsheet inteiro a cada conversa.
Provavelmente seria uma péssima ideia.
Quando escrevo:
Abra Meu Contexto
o ChatGPT começa localizando o Spreadsheet correspondente.
Depois, carrega só o núcleo:
- missão;
- diretrizes;
- state;
- synthesis;
- todo;
- decisões;
- contradições;
- handoff.
As fontes, os conhecimentos atômicos e os outputs antigos ficam no Sheet.
O ChatGPT vai buscar tudo isso só quando se torna necessário.
Esse é um ponto importante na forma como penso o sistema.
A memória não funciona assim:
coloco de novo tudo o que sei no prompt a cada conversa.
Ela funciona mais assim:
tenho uma memória externa onde posso ir buscar a informação pertinente no momento em que ela se torna útil.
O Contexto vira uma memória externa endereçável.
O detalhe que fazia perder um tempo enorme
Numa primeira versão, eu ainda não tinha otimizado a resolução dos identificadores do Google.
Toda vez que o ChatGPT queria ler ou escrever num Contexto, ele tinha que procurar o Spreadsheet correspondente e depois localizar o ID dele.
E na operação seguinte, recomeçava.
Funcionava, mas algumas operações podiam chegar perto de cinquenta segundos.
Boa parte desse tempo ia simplesmente para localizar algo que já tinha sido localizado alguns segundos antes.
Então acrescentei uma regra bem simples.
Uma vez aberto o Contexto, o ChatGPT guarda durante a conversa:
nome do Contexto
→ Spreadsheet
→ Spreadsheet ID
Todas as operações seguintes usam esse ID diretamente.
Ele só é resolvido de novo se:
- trocamos de Contexto;
- o ID não está mais disponível;
- o acesso falha.
Parece bastante óbvio.
Mas muda enormemente a fluidez do sistema.
Persistir não é aprender
O motor em si expõe, no fim das contas, pouquíssimos comandos.
Abra <contexto>
Persista <conteúdo>
Todo <ação>
Ingira
Salve
Abra carrega um Contexto.
Persista guarda uma nova fonte.
Todo acrescenta uma ação a realizar.
Ingira analisa as novas fontes e atualiza o conhecimento estruturado (criação ou enriquecimento de notas).
Salve atualiza os elementos que permitem retomar corretamente a missão numa próxima conversa.
Mas a distinção mais importante do sistema é provavelmente esta:
Persista não é Ingira.
Quando digo:
Persista ...
não estou pedindo ao motor que considere verdadeiro o que acabei de dizer.
Estou pedindo apenas:
guarde este material.
Ele vira uma fonte.
Na ingestão, o motor pode então determinar que o conteúdo dela corresponde a:
- uma decisão de fato tomada;
- uma tarefa;
- uma contradição;
- uma informação útil para o estado atual;
- um conhecimento suficientemente estabilizado para virar uma nota atômica;
- ou simplesmente algo que deve ser guardado como fonte, sem ir além.
Isso evita um desvio que me parece especialmente perigoso nos sistemas de memória para IA.
Se toda produção da IA vira automaticamente um conhecimento do sistema, a IA acaba podendo usar as próprias produções anteriores como prova.
Por isso tento manter uma separação estrita:
fonte ≠ conhecimento ≠ estado ≠ síntese ≠ entregável
Uma fonte diz:
foi isto o que foi dito ou observado.
Um conhecimento estabilizado diz outra coisa:
isto é o que o sistema considera, a partir de agora, suficientemente estabelecido e reaproveitável.
Um Contexto no bolso
É no celular que essa portabilidade fica realmente interessante para mim.
Já trabalho muito por ditado de voz.
E nesse caso específico, isso muda completamente a relação com o sistema.
Voltemos ao exemplo de uma feira profissional.
Chego com um Contexto já preparado.
Do meu celular:
Abra Feira-X
Converso com um primeiro expositor.
Ao sair do estande, não tenho lá muita vontade de parar, abrir um aplicativo de notas e digitar cinco minutos num teclado minúsculo.
Caminho até o estande seguinte e simplesmente dito ao ChatGPT o que acabei de aprender.
Em seguida:
Persista <o que acabei de ditar>
Isso pode levar algumas dezenas de segundos.
Sigo com o meu dia.
Depois de várias conversas:
Ingira
Aí o motor começa a estruturar o que coletei.
E é aqui que o uso fica mais interessante do que um simples sistema de anotações.
Posso perguntar ao ChatGPT:
O que ainda me falta para entender de verdade este assunto?
Ou:
Quais contradições eu deveria verificar com o próximo expositor?
Ou ainda:
Quais perguntas importantes eu ainda não fiz a ninguém?
Consigo essa resposta ainda na feira.
E então vou fazer na hora as perguntas que faltavam.
O ciclo vira isto:
conversa
   ↓
ditado de voz caminhando
   ↓
Persista
   ↓
Ingira
   ↓
procurar os pontos cegos
   ↓
voltar e fazer perguntas
   ↓
completar o Contexto
É provavelmente isso que mais muda o meu uso.
A IA não entra mais em cena só depois da coleta, para me ajudar a produzir alguma coisa.
Ela pode entrar em cena durante a coleta, quando ainda dá para melhorar a qualidade da informação.
Plaud: fazer as conversas entrarem no Contexto
Também uso um Plaud Note Pro.
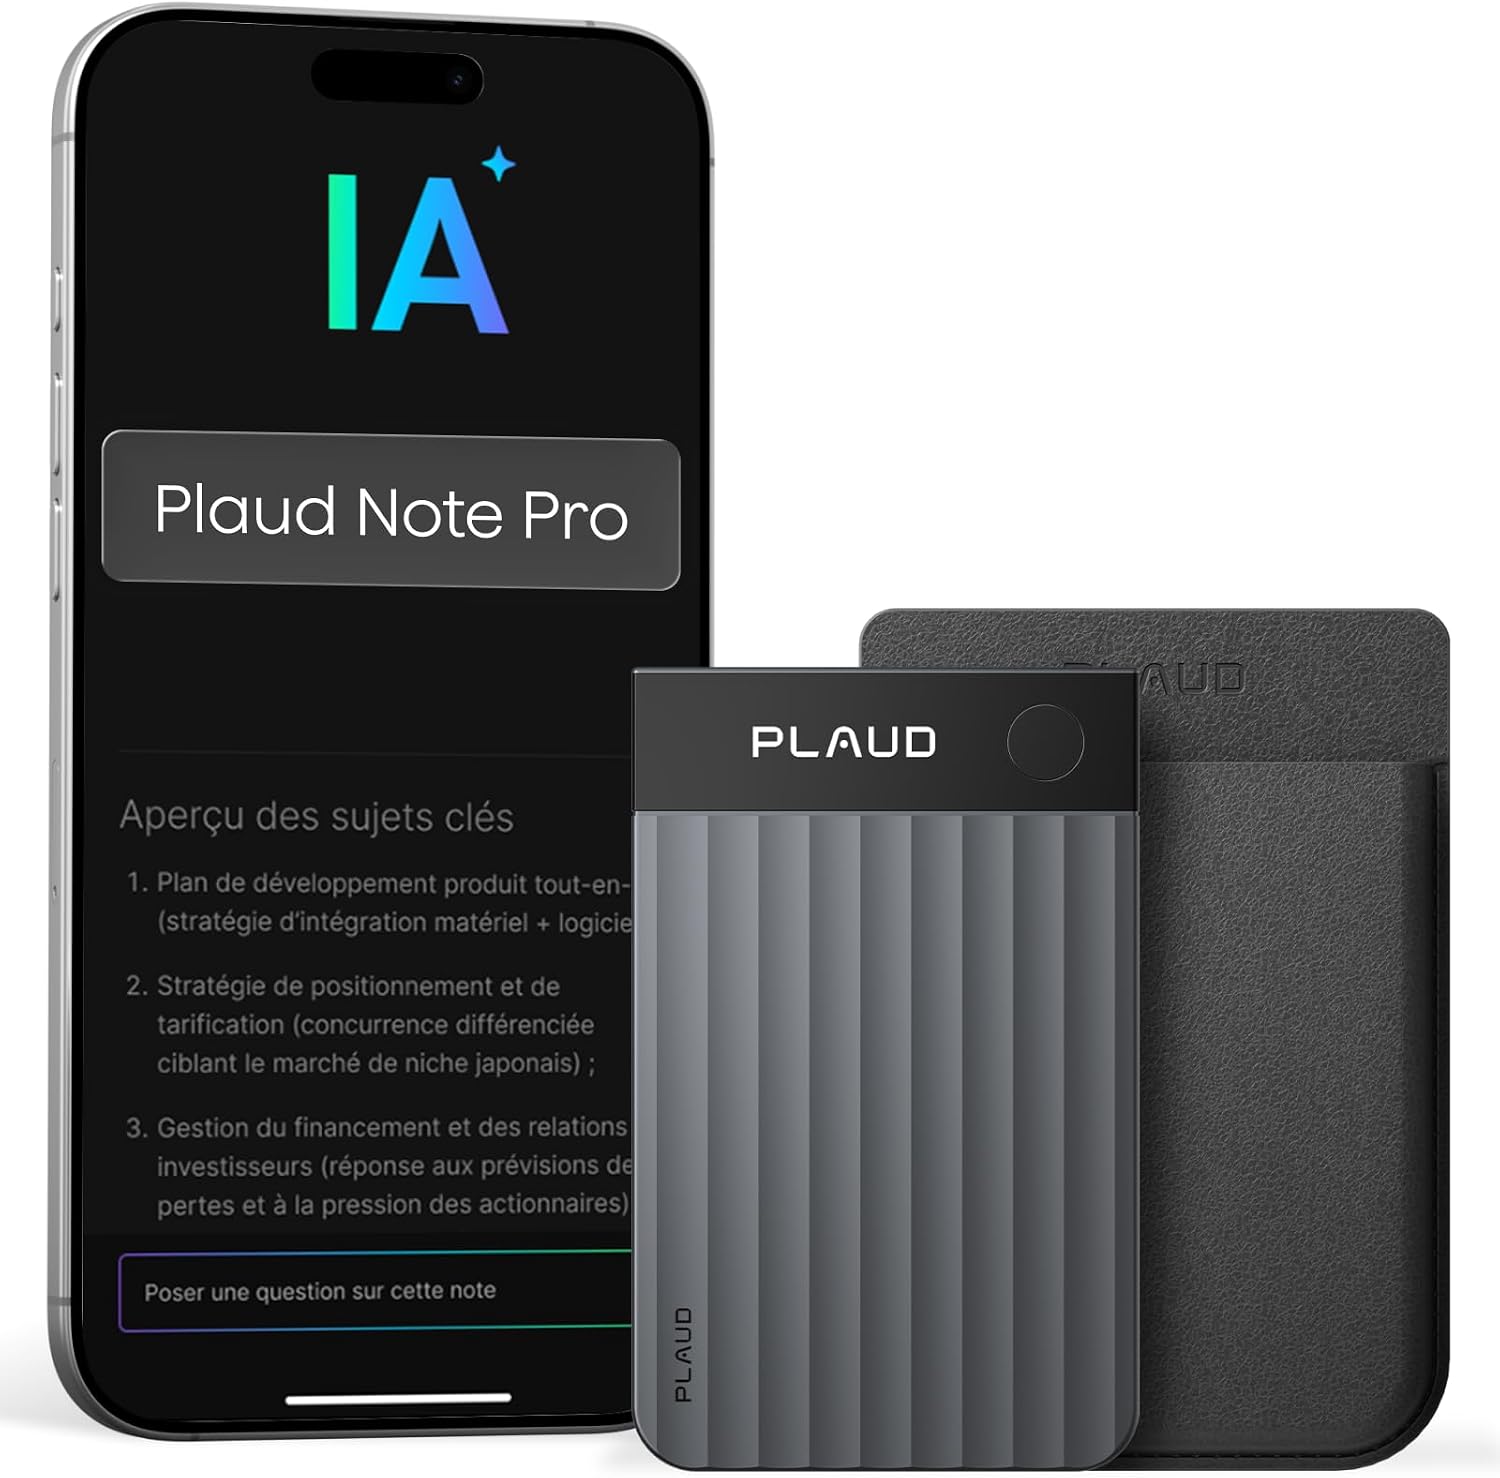
Meu Plaud Note Pro, que posso usar para gravar conversas e entrevistas em campo.
O Plaud Note Pro é um pequeno gravador de voz que dá para usar em reuniões, conversas ou entrevistas.
A gravação fica depois disponível no Plaud e pode ser transcrita.
Para o meu sistema, porém, o que mais me interessa não é o resumo automático produzido pelo Plaud.
Quero recuperar a transcrição completa.
E há outra peça importante: o ChatGPT pode acessar o Plaud diretamente pelo conector dele.
Posso então, de dentro do ChatGPT, pedir por exemplo:
Liste as minhas três últimas gravações do Plaud e me diga em uma linha do que cada uma fala.
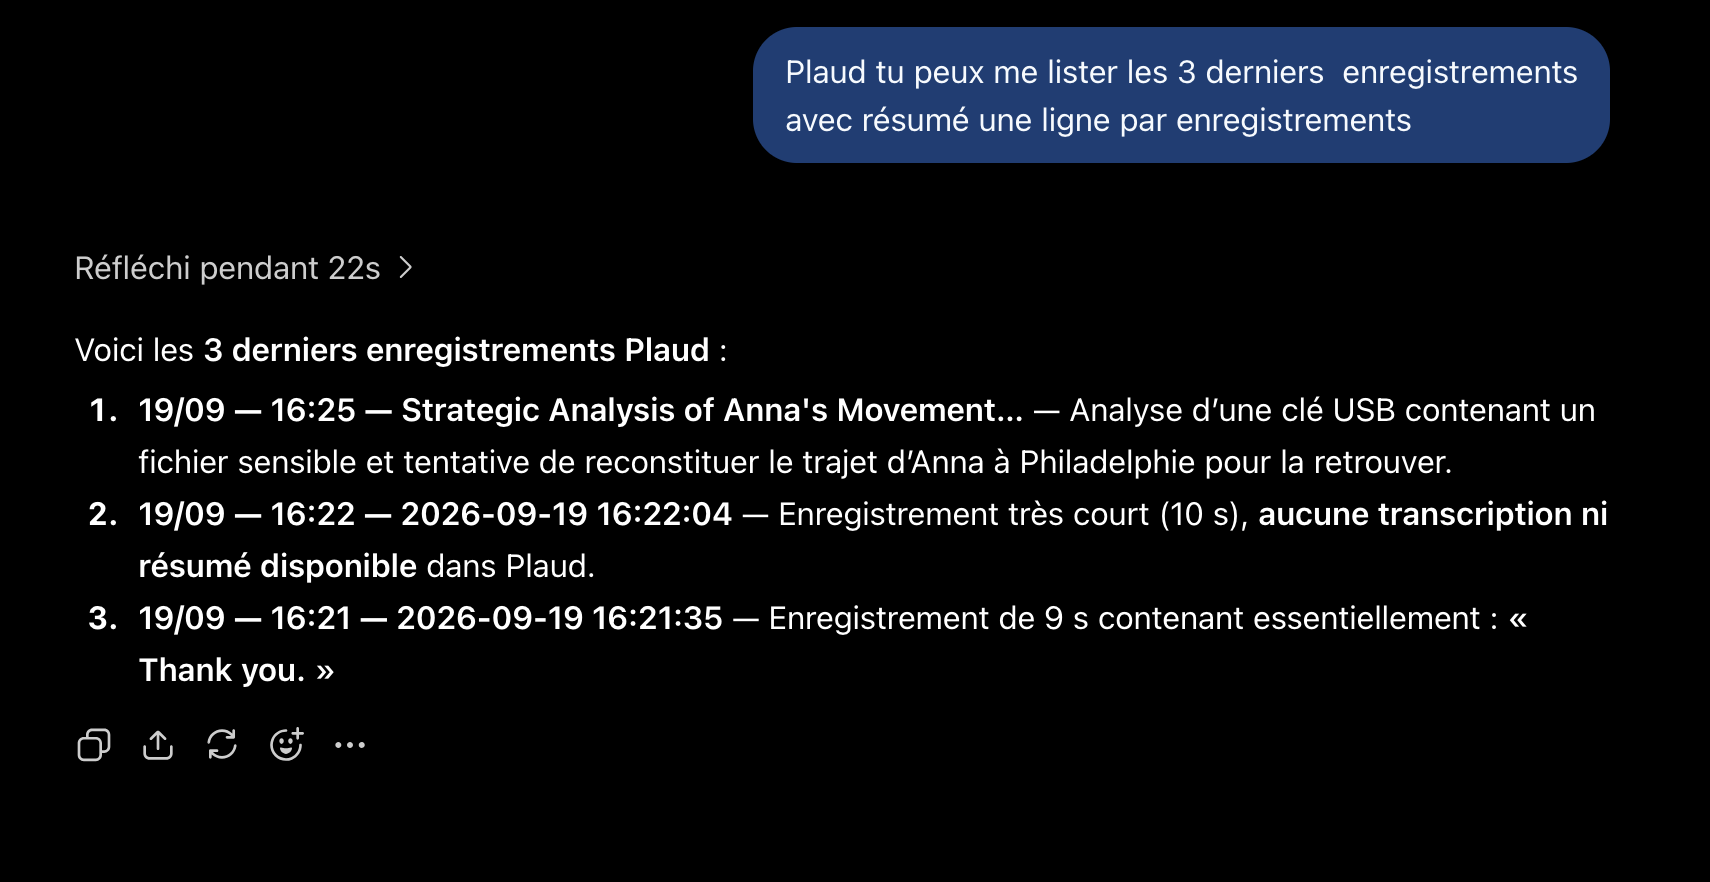
Exemplo de consulta ao Plaud a partir do ChatGPT para localizar as últimas gravações.
O ChatGPT consegue localizar essas gravações e depois recuperar diretamente a transcrição delas.
Isso permite imaginar um fluxo bem mais direto:
conversa real
        ↓
Plaud
        ↓
transcrição
        ↓
ChatGPT recupera a transcrição diretamente
        ↓
Persista
        ↓
fonte bruta do Contexto
        ↓
Ingira
Ou seja, não preciso:
- baixar um arquivo na mão;
- abrir a transcrição;
- copiar;
- voltar ao ChatGPT;
- colar.
Posso fazer tudo isso automaticamente, por voz, do meu celular.
E prefiro colocar no Contexto a transcrição bruta completa em vez de um simples resumo.
O resumo já é uma interpretação.
A transcrição fica bem mais próxima do material de origem.
Com a conversa dentro do Contexto, posso perguntar:
- o que essa pessoa acabou de me ensinar de verdade?
- o que contradiz as conversas anteriores?
- quais afirmações merecem ser verificadas?
- quais perguntas eu deveria fazer à próxima pessoa?
Os vários blocos necessários já funcionam.
Por outro lado, ainda não testei o suficiente, de ponta a ponta, esse fluxo Plaud → ChatGPT → Contexto em dias longos de campo para dizer que ele está perfeitamente fluido.
É, portanto, um uso que ainda precisa de mais teste.
Como reproduzir o sistema
Preparei dois arquivos que correspondem aos dois níveis de diretrizes do motor.
O CORE
O CORE está disponível aqui:
É essa parte que precisa ser copiada nas diretrizes do Projeto ChatGPT.
A diretriz estendida
A diretriz detalhada está disponível aqui:
Ela precisa ser copiada num Google Doc que o ChatGPT possa acessar.
Antes de começar, é claro que você precisa conectar o Google Drive ao ChatGPT e liberar o acesso aos documentos usados pelo motor.
Configurar os IDs
O CORE contém, entre outras coisas, dois identificadores:
DOCUMENT_ID = xxxx
FOLDER_ID = xxxx
DOCUMENT_ID corresponde ao Google Doc que contém a diretriz estendida.
Numa URL como esta:
https://docs.google.com/document/d/xxxx/edit
a parte xxxx é o identificador do documento.
FOLDER_ID corresponde à pasta do Google Drive onde os Contextos serão armazenados.
Para uma URL como esta:
https://drive.google.com/drive/folders/xxxx
o identificador é de novo a parte xxxx.
Cada usuário deve, evidentemente, substituir esses valores pelos do próprio ambiente.
Um Spreadsheet por Contexto
Quando um novo Contexto é criado, o motor cria um Spreadsheet contendo:
00-FRAME
01-STATE
03-SESSIONS
04-ATOMIC
05-OUTPUTS
Ele é colocado em seguida na pasta definida por FOLDER_ID.
Não é preciso copiar na mão o identificador de cada um desses Spreadsheets nas diretrizes.
Quando peço:
Abra Meu Contexto
o ChatGPT procura o Spreadsheet correspondente na pasta dos Contextos, recupera o ID dele e depois o mantém durante a conversa.
O sistema já está operacional.
O que essa gambiarra permite — e os limites dela
Esta versão ChatGPT não substitui o meu motor usado com Codex ou Claude Code.
Não era esse o objetivo.
Ela tem vários limites.
É mais lenta.
É menos adequada a Contextos que exigem diretamente scripts Python, chamadas de API ou um ambiente de execução mais rico.
E, sobretudo, ainda me falta perspectiva sobre o comportamento dela quando um Contexto cresce de verdade ao longo de várias semanas.
Por isso a vejo como um modo autônomo complementar.
No meu Mac, Codex ou Claude Code continuam mais adequados a certas missões.
Mas, pelo celular, agora consigo usar um Contexto sem depender de o meu Mac estar ligado e acessível.
E era exatamente esse o problema que eu queria resolver.
Há também uma observação engraçada ligada à cota do Codex.
Durante toda essa experimentação no ChatGPT, a cota do Codex exibida não diminuiu.
Consumo observado:
0
Obviamente não estou afirmando que isso constitua uma regra geral sobre a forma como a OpenAI cobra ou contabiliza esse tipo de uso.
Constato apenas que, durante essa experiência, essa gambiarra não consumiu a minha cota do Codex.
O sistema já serviu para produzir este artigo
No começo, o meu primeiro hack com o Google Sheets respondia a uma pergunta bem limitada:
como tirar uma informação do ChatGPT e guardá-la de forma duradoura?
Poucos dias depois, a pergunta tinha virado esta:
e se eu tirasse dali toda a memória estruturada do Contexto?
No fim das contas, é isso que este sistema faz.
O ChatGPT não precisa mais "lembrar de tudo".
Ele precisa sobretudo saber:
- onde procurar;
- o que carregar;
- o que persistir;
- como qualificar a informação;
- como reencontrar o que já foi aprendido;
- em que pé está o trabalho.
A fórmula continua bem simples:
O ChatGPT raciocina.
As diretrizes definem o motor.
O Google Sheets lembra.
E há algo bastante satisfatório no fato de que a preparação e a redação deste artigo serviram elas mesmas para testar o sistema que o artigo descreve.
Para preparar este texto, usei exclusivamente esse Contexto dentro do ChatGPT.
Persisti ali as minhas ideias.
Depois as ingeri.
Identificamos pontos cegos.
Corrigi formulações.
Criamos e concluímos tarefas.
Acrescentei os elementos que faltavam.
Depois produzi uma primeira versão do artigo, reli e usei o mesmo Contexto para preparar esta V2.
Ou seja, o sistema não serviu apenas de demonstração técnica.
Ele já foi usado para fazer de verdade o trabalho para o qual eu o construí.
A pergunta, portanto, já não é bem:
será que funciona?
Funciona.
A pergunta que me interessa agora é outra:
será que esta arquitetura continuará tão prática quando o mesmo Contexto for posto à prova em campo, numa semana inteira de feiras profissionais?
É isso que a continuidade do uso vai permitir verificar.