Graphify est un outil conçu pour cartographier du code en payant une IA pour lire chaque fichier. Je l'ai détourné pour cartographier mon wiki de connaissances, sans IA et sans clé API. Un seul fichier Python de 160 lignes, 0,2 seconde de calcul, et mille notes deviennent un graphe que l'on peut explorer, interroger et parcourir.
Mille notes sur le marketing. Des notes atomiques, des définitions de glossaire, des cartes de lecture par livre. Toutes reliées entre elles, et chaque lien explique pourquoi il existe.
Et pourtant, impossible de voir la forme d'ensemble. Impossible de répondre simplement à des questions comme : qu'est-ce qui relie la réciprocité de Cialdini au churn d'un SaaS ? Quelles notes sont au cœur du thème, et lesquelles sont isolées ?
La vue graphe d'Obsidian montre une pelote de laine. Belle, mais muette.
Cet article raconte comment j'ai obtenu un graphe exploitable de ce wiki en détournant Graphify, un outil pensé pour le code, et ce que ce graphe m'a appris sur ma propre base.
Le point de départ : un wiki où les liens ont du sens
J'ai déjà raconté pourquoi j'ai construit une base de connaissances maintenue par une IA. Le principe : je donne des livres et des documents à Claude, qui en extrait des notes atomiques, des entrées de glossaire et d'autres types de fiches, puis les relie entre elles.
Une règle compte plus que toutes les autres pour la suite : un lien ne doit jamais être décoratif. Chaque lien est suivi d'une courte phrase qui explique la relation.
- [[GLO00614-marche-minimal-viable]] — le MVMarket est la stratégie
  pour traverser le chasm, pas le chasm lui-même.
- [[GLO00619-technology-adoption-life-cycle]] — cadre dans lequel
  le chasm s'inscrit.
Autrement dit, les relations entre les idées sont déjà écrites, noir sur blanc, dans les notes. C'est ce détail qui rend tout le reste possible.
Qu'est-ce que Graphify ?
Graphify transforme un dossier de code ou de documents en graphe de connaissances, que l'on peut ensuite interroger depuis un assistant comme Claude Code.
Il fonctionne en deux temps.
- La construction. Graphify fait lire chaque fichier par une IA, qui en déduit les éléments importants et les relations entre eux. C'est l'étape coûteuse : elle consomme des jetons, et le résultat varie d'une exécution à l'autre.
- L'exploration. Une fois le graphe construit, Graphify le découpe en groupes de nœuds proches, génère une carte interactive et un rapport, et répond à des questions : quelles sont les connexions de tel élément, quel chemin relie A à B.
L'idée du détournement
Sur un dépôt de code, l'étape de construction a du sens : personne n'a écrit noir sur blanc que telle fonction appelle telle autre, il faut le déduire.
Sur mon wiki, c'est l'inverse. L'IA n'aurait rien à deviner. Les relations sont déjà là, écrites à la main ou validées au moment de l'ingestion. Payer une IA pour les redécouvrir serait coûteux, lent, et moins fidèle que ce qui est déjà écrit.
J'ai donc remplacé la construction par un petit script maison, et gardé tout le reste de Graphify.
Notes du wiki (.md)
      │
      │  script maison : lit les liens [[...]] et leur explication
      ▼
graph.json  (format standard NetworkX)
      │
      │  Graphify : groupes, carte, rapport, questions
      ▼
graph.html · GRAPH_REPORT.md · explain · path · query
Le point qui rend le détournement possible : Graphify accepte n'importe quel graphe au format standard de la bibliothèque NetworkX. Il ne vérifie pas d'où vient ce graphe. Il suffit de le lui donner.
Sous le capot : un seul fichier
Le script fait trois choses.
1. Recenser les notes. Chaque fichier Markdown devient un nœud. Son identifiant est le nom du fichier, et son type est déduit du préfixe : ATO pour une note atomique, GLO pour le glossaire, MOC pour une carte de lecture, etc.
2. Repérer les liens. Une expression régulière trouve chaque [[ID-slug]] dans le texte. Si la note cible existe, un lien est créé.
3. Nommer la relation. Le texte écrit après le tiret qui suit le lien devient le nom de la relation. C'est ce qui permet à Graphify d'afficher « le MVMarket est la stratégie pour traverser le chasm » plutôt qu'un simple « lien ».
for line in text.splitlines():
    matches = LINK_RE.findall(line)
    relation_match = re.search(r"\]\]\s*[—-]+\s*(.+)", line)
    relation = relation_match.group(1).strip()[:80] if relation_match else "links"
Aucune bibliothèque à installer : le script n'utilise que des modules livrés avec Python. Voici le fichier complet.
"""
Build graph.json from Obsidian [[links]] in wiki notes — no LLM needed.
Output format: NetworkX node_link_graph (compatible with graphify path/explain/query).

Usage:
    .venv/bin/python scripts/build_graph.py [--theme maintenance] [--output _GRAPHITY/]
"""

import argparse
import json
import re
import uuid
from pathlib import Path

WIKI_ROOT = Path(__file__).resolve().parent.parent.parent.parent / "wiki"
LINK_RE = re.compile(r"\[\[([A-Z]{2,3}\d{5}-[^\]\|]+?)(?:\|[^\]]*)?\]\]")
FRONTMATTER_RE = re.compile(r"^---\n(.*?)\n---", re.DOTALL)

TYPE_MAP = {
    "ATO": "atomic_note",
    "GLO": "glossary_term",
    "NOR": "norm_reference",
    "EXN": "normative_requirement",
    "PRO": "business_process",
    "OBJ": "domain_object",
    "BRL": "business_rule",
    "REG": "regulatory_text",
    "HAB": "habilitation",
    "IND": "indicator",
    "MOC": "moc",
    "SRC": "source_record",
}


def parse_frontmatter(text: str) -> dict:
    m = FRONTMATTER_RE.match(text)
    if not m:
        return {}
    result = {}
    for line in m.group(1).splitlines():
        if ":" in line:
            k, _, v = line.partition(":")
            result[k.strip()] = v.strip().strip('"')
    return result


def slug_to_id(slug: str) -> str:
    """Extract the ID prefix (e.g. 'ATO00001') from a slug like 'ATO00001-some-title'."""
    parts = slug.split("-", 1)
    return parts[0].upper()


def build_graph(theme: str, output_dir: Path) -> dict:
    notes_root = WIKI_ROOT / "themes" / theme / "notes"
    if not notes_root.exists():
        raise SystemExit(f"Notes directory not found: {notes_root}")

    nodes = {}   # node_id -> node dict
    edges = []   # list of {source, target, relation}

    md_files = list(notes_root.rglob("*.md"))
    md_files = [f for f in md_files if f.name != "README.md"]

    # Index: slug -> node_id (file stem without extension)
    slug_index = {}
    for f in md_files:
        stem = f.stem  # e.g. ATO00001-some-title
        slug_index[stem] = stem
        # Also index by bare ID (ATO00001) for robustness
        bare_id = stem.split("-")[0]
        slug_index.setdefault(bare_id, stem)

    print(f"[build_graph] {len(md_files)} notes found in {notes_root}")

    for f in md_files:
        text = f.read_text(encoding="utf-8")
        fm = parse_frontmatter(text)

        node_id = f.stem
        prefix = node_id[:3].upper()
        node_type = TYPE_MAP.get(prefix, "note")
        title = fm.get("title") or fm.get("term") or fm.get("name") or node_id
        subdir = f.parent.name  # e.g. "atomiques", "glossaire"

        nodes[node_id] = {
            "id": node_id,
            # label = slug so graphify path/explain resolve by ID (e.g. "ATO00001-...")
            "label": node_id,
            "title": title,
            # norm_label includes slug tokens for fuzzy matching
            "norm_label": node_id.lower().replace("-", " "),
            "type": node_type,
            "kind": node_type,
            "source_file": str(f.relative_to(WIKI_ROOT.parent)),
            "subdir": subdir,
            "status": fm.get("status", "draft"),
            "uid": fm.get("uid") or str(uuid.uuid4()),
            "wiki_id": fm.get("id", ""),
        }

    # Second pass: extract links
    seen_edges = set()
    for f in md_files:
        text = f.read_text(encoding="utf-8")
        source_id = f.stem

        # Extract label from link context line (text after — )
        for line in text.splitlines():
            matches = LINK_RE.findall(line)
            # Extract relation label from "— relation text" after the link
            relation_match = re.search(r"\]\]\s*[—-]+\s*(.+)", line)
            relation = relation_match.group(1).strip()[:80] if relation_match else "links"

            for slug in matches:
                # Resolve target
                target_id = slug_index.get(slug) or slug_index.get(slug.split("-")[0])
                if not target_id or target_id == source_id:
                    continue
                if target_id not in nodes:
                    continue
                key = (source_id, target_id)
                if key in seen_edges:
                    continue
                seen_edges.add(key)
                edges.append({
                    "source": source_id,
                    "target": target_id,
                    "relation": relation,
                    "key": 0,
                })

    node_list = list(nodes.values())

    graph_data = {
        "directed": True,
        "multigraph": False,
        "graph": {"theme": theme},
        "nodes": node_list,
        "links": edges,
    }

    output_dir.mkdir(parents=True, exist_ok=True)
    graph_path = output_dir / "graph.json"
    graph_path.write_text(json.dumps(graph_data, ensure_ascii=False, indent=2), encoding="utf-8")

    print(f"[build_graph] {len(node_list)} nodes, {len(edges)} edges")
    print(f"[build_graph] graph.json → {graph_path}")
    return graph_data


if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("--theme", default="maintenance")
    parser.add_argument("--output", default="_GRAPHITY/")
    args = parser.parse_args()

    build_graph(args.theme, Path(args.output) / args.theme)
Ce que ça donne sur le thème marketing
Le thème marketing de mon wiki est alimenté par une vingtaine de livres : Dunford, Seth Godin, Cialdini, Moore, Ries et Trout, Nagle, Byron Sharp, Rob Fitzpatrick…
| Mesure | Valeur |
|---|---|
| Notes | 1 013 |
| Liens | 6 442 |
| Groupes de notes détectés | 22 |
| Temps de construction du graphe | 0,2 seconde |
| Jetons d'IA consommés | 0 |
La carte et ses groupes de notes
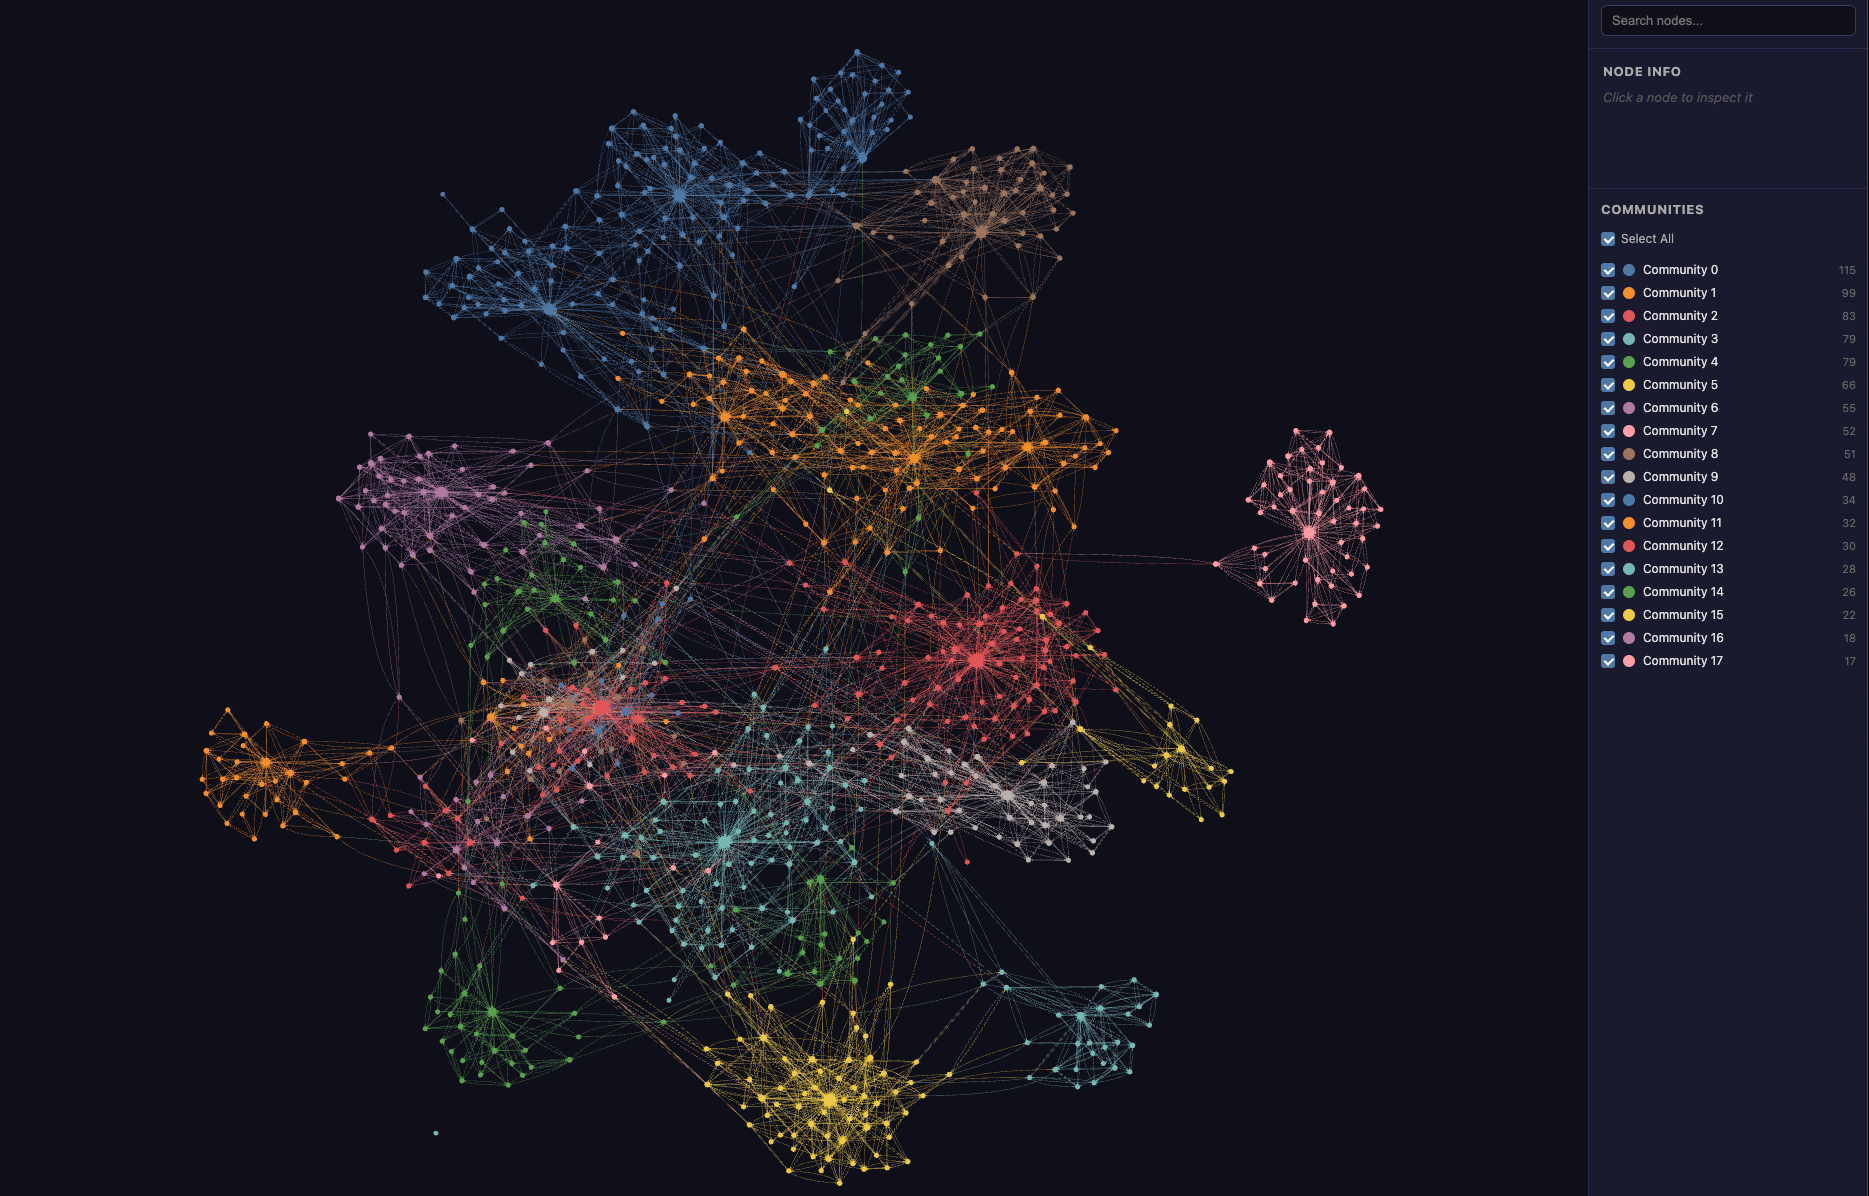
Graphify découpe le graphe en groupes de notes plus liées entre elles qu'avec le reste. Quelques groupes trouvés sur le thème marketing :
- Un groupe de 53 notes autour du Mom Test : les conversations client, les compliments qui ne valent rien, les faits passés plutôt que les promesses.
- Un groupe de 52 notes sur l'influence : les six principes de Cialdini, la réciprocité, le contraste perceptuel, le « parce que » qui déclenche l'obéissance.
- Un groupe de 46 notes sur le chasm : le fossé entre les early adopters et la majorité pragmatique, la stratégie de la quille de bowling.
- Un groupe de 26 notes sur le customer success : le churn comme spirale mortelle, la différence entre customer success et support.
Le rapport identifie aussi les notes les plus connectées. Les dix premières sont toutes des cartes de lecture : celle d'Obviously Awesome de Dunford arrive en tête avec 180 liens, devant This is Marketing de Seth Godin avec 156 liens.
Il signale enfin les notes isolées. Une seule sur 1 013 : une note sur le persona marketing, que rien ne relie au reste. C'est un trou dans le wiki, trouvé gratuitement.
Les connexions d'une note
On demande à Graphify d'expliquer la note de glossaire sur le chasm :
graphify explain "GLO00618-chasm"
Il répond avec ses 30 connexions, dans les deux sens, et la relation de chacune. Extrait :
| Sens | Note liée | Relation écrite dans la note |
|---|---|---|
| ← | Carte de lecture Crossing the Chasm | le fossé central du modèle |
| → | Cycle d'adoption technologique | cadre dans lequel le chasm s'inscrit |
| → | Les early adopters cherchent un avantage radical, la majorité une amélioration progressive | explique la cause psychographique du chasm |
| ← | Produit complet (whole product) | le chasm est en partie causé par l'absence de produit complet |
| ← | Bowling alley | commence après la traversée du chasm |
| → | Le gouffre de Moore sépare les early adopters du marché de masse | même idée, issue de Seth Godin citant Moore |
→ : le chasm cite cette note. ← : cette note cite le chasm.
La dernière ligne est la plus intéressante. Le chasm vient de Geoffrey Moore, mais Seth Godin en parle aussi dans un autre livre. Le graphe montre que les deux sources se rejoignent sur la même idée.
Le chemin entre deux idées éloignées
Quel rapport entre la règle de réciprocité de Cialdini, un principe de psychologie sociale, et le churn dans un business d'abonnement ?
graphify path \
  "ATO01269-la-regle-de-reciprocite..." \
  "ATO01404-dans-un-business-de-revenus-recurrents-le-churn..."
Graphify trouve un chemin en 8 étapes :
- La règle de réciprocité est universelle et fonde la coopération humaine
- → la carte de lecture d'Influence (Cialdini)
- → L'engagement initial modifie l'image de soi et produit une cohérence automatique
- → Le risque élevé fabrique la confiance ; baisser son prix la diminue
- → proche de : un prix élevé signale la qualité et soutient la confiance → L'effet prix-qualité fait percevoir un prix élevé comme un signal de qualité
- → la carte de lecture de The Strategy and Tactics of Pricing (Nagle)
- → Le coût de changement réduit la sensibilité au prix → converge : les switching costs sont un levier majeur de rétention → La rétention est le multiplicateur de croissance le plus puissant
- → convergence avec la thèse de Customer Success : le churn détruit la croissance → Dans un business récurrent, le churn est une spirale mortelle
Le chemin raconte une histoire : de la psychologie de l'engagement au prix comme signal de confiance, puis du coût de changement à la rétention. Personne n'a écrit ce raisonnement d'un bloc. Il émerge des liens posés note après note, livre après livre.
Ce que ça apporte de plus que la vue graphe d'Obsidian
La vue graphe d'Obsidian dessine les liens. Graphify, en plus :
- détecte les groupes de notes automatiquement ;
- nomme les relations, en reprenant l'explication écrite dans la note ;
- trouve le chemin le plus court entre deux notes ;
- produit un rapport : notes centrales, notes isolées, connexions inattendues ;
- s'utilise en ligne de commande, donc Claude peut l'interroger lui-même pendant qu'il travaille sur le wiki.
Les limites
La recherche par question ne lit que les titres. Graphify a aussi une commande de recherche libre. Elle cherche les mots de la question dans le nom des notes, pas dans leur contenu, puis élargit aux notes voisines. Si la question n'emploie pas les mots du titre, elle ne trouve rien.
Les groupes suivent les livres plus que les concepts. Le positionnement, par exemple, est éclaté en cinq groupes, essentiellement selon le livre d'origine : Dunford d'un côté, Ries et Trout de l'autre. Les cartes de lecture par livre concentrent tellement de liens qu'elles structurent tout le graphe. Même effet sur les chemins : celui entre le chasm et le consentement à payer passe par trois cartes de lecture, ce qui est vrai mais peu instructif.
Les groupes ne sont pas nommés. Graphify peut les nommer avec une IA, mais ce serait réintroduire le coût que je voulais éviter. Ils s'appellent donc « Community 0 », « Community 1 »… et c'est à moi de les interpréter.
Graphify reste un outil pour le code. À chaque construction, il signale 12 884 avertissements : les liens n'ont pas de « fichier source », une notion qui n'a de sens que pour du code. C'est sans conséquence, mais cela rappelle qu'on utilise l'outil en dehors de son usage prévu.
Le graphe ne vaut que ce que valent les liens. Un lien sans explication devient une relation « links » muette. Une note mal reliée reste isolée. Le graphe ne corrige rien, il montre.
Le reproduire chez soi
Il faut un ensemble de notes en Markdown reliées par des liens [[...]] :
- soit un coffre Obsidian que vous reliez vous-même ;
- soit un wiki maintenu par une IA, comme celui décrit dans cet article.
Le script ci-dessus suppose des identifiants du type ATO00001-slug et une arborescence par thème. Il faut adapter l'expression régulière des liens et le dossier des notes à votre propre organisation.
Ensuite, trois commandes :
pip install graphifyy

python build_graph.py --theme marketing --output _GRAPHITY/

graphify cluster-only _GRAPHITY/marketing/ --no-label \
  --graph _GRAPHITY/marketing/graph.json
La carte interactive est alors dans _GRAPHITY/marketing/graphify-out/graph.html, et le rapport dans GRAPH_REPORT.md à côté. Les commandes explain et path fonctionnent directement sur le fichier graph.json.
L'IA n'avait rien à deviner. Il suffisait de lire ce qu'on avait déjà écrit.