原文为法语。由 AI 翻译——保留的是含义,而非文风。
这个主题在我的书 Le contexte 中有详细展开。想读的话,可以下载,或者在 Amazon 上购买。
本文接续《“持久化这条”:把一条信息从 ChatGPT 导出到永久存储》。
在那个最初的土办法里,我发现了一点相当简单、却改变了很多东西的事实:ChatGPT 可以把一条信息写进 Google Sheets,从而把它带出自己的上下文窗口。
换句话说,我可以给它一份持久的外部记忆。
那时候,Google Sheets 对我来说基本上只是一个输出箱。
接着,我问了自己另一个问题:
同样的机制,是否足以让我的 Contexte 系统直接在 ChatGPT 里运行?
为什么我想让 Contexte 离开 Mac
一段时间以来,我一直配合 Codex 和 Claude Code 使用 Contexte。
我说的“Contexte”,并不只是一段对话历史,也不是一个存几条笔记的地方。
我采用的定义要宽得多:
Contexte 是一个以人的任务为边界的系统。在其中,AI 组织并调动我们所知道的东西、我们从何得知、各要素之间如何关联、工作进行到哪一步,以帮助人达成目标,而不必从零开始。在这个过程中,系统积累一份持久的信息资本,并让它不断增值:产出的知识始终可用,随时间不断丰富,并可被用于其他目标。
我已经搭好了一个引擎,让这套原则能配合 Codex 或 Claude Code 运转。
在我的 Mac 上,它运行得很好。
在手机上,我也找到了一个办法:远程访问 Mac 上运行的 Codex。
但这个办法有个相当明显的弱点。
它要求:
- Mac 开着;
- Mac 一直联网;
- 远程访问正常工作。
在家里,这不算什么麻烦。
到了现场,麻烦就大了。
我特别关心的场景,是即将参加的两场行业展会:只带一部手机待上一周,和参展商交流,采集信息,准备采访,甚至可能当天就写出一篇文章。
我不想依赖几十甚至几百公里外某处一台开着的 Mac。
于是我想,能不能干脆不再依赖它。
灵光一现:ChatGPT 几乎什么都有了
换个角度看这个问题,我意识到,一个 Contexte 引擎说到底只需要三大块。
- 需要一个能对信息进行推理的引擎。
- ChatGPT 已经能做到。
- 需要一套规则,告诉引擎如何工作。
- ChatGPT 的项目指令可以承担这个角色。
- 最后,需要一份能跨对话留存的记忆。
- 这正是缺的那一块。
于是我的架构可以变成:
引擎     → ChatGPT
指令     → ChatGPT 项目
持久化   → Google Sheets
上一篇文章里那个持久化的 hack,恰好提供了这第三块。
从这里开始,把我的 Contexte 引擎移植到 ChatGPT 就不再那么异想天开了。
我不需要围绕 ChatGPT 重新搭一整套系统。
AI 引擎本来就在那里。
主要是要给它规则,以及一份它能读写的外部记忆。
我如何把引擎移植到 ChatGPT
一开始,我试着把引擎的全部规则直接放进项目指令。
没撑多久。
项目指令的上限大约是 8000 个字符,而我的引擎早就需要多得多。
于是我把规则分成了两层。
第一层是 CORE。
这部分直接放在 ChatGPT 项目的指令里。
它包含引擎运转绝对不可缺少的内容:
- Contexte 是什么;
- 它存放在哪里;
- 有哪些命令;
- 如何打开一个 Contexte;
- 如何持久化一条来源;
- 文件结构;
- 主要的不变量;
- 指令的层级。
第二层是一份扩展指令。
它的篇幅大得多,放在一个 Google Doc 里。
它包含的内容例如:
- 详细的摄入方法;
- 创建原子知识的标准;
- state 和 synthesis 的管理;
- 决策;
- 矛盾;
- todo;
- 读取策略;
- 产出规则;
- 错误和边界情况的处理。
层级变成:
CORE
  ↓
扩展指令
  ↓
Contexte 自身的指令
CORE 知道扩展指令放在哪里,并要求 ChatGPT 在新对话开始时加载它。
所以,这种拆分并不只是为了让系统更优雅。
它首先回应的是一个非常具体的约束:整个引擎塞不进一个 ChatGPT 项目的指令里。
Google Sheets 成为 Contexte 的记忆
接下来,还要把 Contexte 本身表示出来。
我本可以用好几个 Google Docs。
- 一个文档放来源。
- 一个放状态。
- 一个放知识。
- 一个放任务。
- ……
但那样很快就会冒出一大堆要去找的文件,以及同样多需要管理的 ID(这个技术约束后面会讲到)。
结果证明,Google Sheets 方便得多。
一个 Contexte 对应一个 Spreadsheet。
在 Spreadsheet 里,每类信息都有自己的工作表。
我目前用的是这样的结构:
00-FRAME
01-STATE
03-SESSIONS
04-ATOMIC
05-OUTPUTS
00-FRAME 主要包含任务,以及 Contexte 自身可能有的指令。
01-STATE 包含了解工作进度所需的信息:
- state;
- synthesis;
- todo;
- 决策;
- 矛盾;
- handoff。
03-SESSIONS 存放已持久化的原始来源。
04-ATOMIC 存放已经稳定下来的知识。
05-OUTPUTS 存放基于 Contexte 产出的交付物。
所以,Google Sheets 不再只是 ChatGPT 写入一条信息以便保存的地方。
这个 Spreadsheet 成了 Contexte 完整的结构化记忆。
千万别全部重新加载
但这并不意味着 ChatGPT 每次对话都会加载整个 Spreadsheet。
那多半是个非常糟糕的主意。
当我写下:
打开 我的 Contexte
ChatGPT 先找到对应的 Spreadsheet。
然后只加载它的核心集:
- 任务;
- 指令;
- state;
- synthesis;
- todo;
- 决策;
- 矛盾;
- handoff。
来源、原子知识和旧的产出都留在表里。
只有在需要时,ChatGPT 才去取它们。
这是我设计这个系统时很看重的一点。
记忆的运作方式不是:
每次对话,我都把我知道的一切重新塞进 prompt。
而更像是:
我有一份外部记忆,在相关信息变得有用的那一刻,我可以去里面把它找回来。
Contexte 成为一份可寻址的外部记忆。
那个浪费了大量时间的细节
在最初的版本里,我还没有优化 Google ID 的解析。
每次 ChatGPT 想在某个 Contexte 里读写,都得先搜索对应的 Spreadsheet,再找出它的 ID。
到下一次操作,又从头来一遍。
这样能用,但有些操作可能要花将近五十秒。
相当一部分时间,纯粹花在重新找回几秒钟前就已经找到的东西上。
于是我加了一条很简单的规则。
Contexte 一旦打开,ChatGPT 就在整个对话期间记住:
Contexte 名称
→ Spreadsheet
→ Spreadsheet ID
之后的所有操作都直接使用这个 ID。
只有在以下情况下才重新解析:
- 切换了 Contexte;
- ID 不再可用;
- 访问失败。
这看起来相当明显。
但它让系统的流畅度大不一样。
持久化不等于学会
引擎本身对外提供的命令其实很少。
打开 <contexte>
持久化 <内容>
Todo <行动>
摄入
保存
打开 加载一个 Contexte。
持久化 留存一条新的来源。
Todo 添加一项待办行动。
摄入 分析新的来源,并更新结构化知识(新建或充实笔记)。
保存 更新那些让下一次对话能够正确接续任务的要素。
但这个系统里最重要的区分,大概是这一条:
持久化不等于摄入。
当我说:
持久化 ……
我并不是要求引擎把我刚说的话当作真的。
我只是要求:
把这份材料留存下来。
它成为一条来源。
在摄入时,引擎才可以判断其中的内容属于:
- 一项真正敲定的决策;
- 一项任务;
- 一处矛盾;
- 一条对当前状态有用的信息;
- 一条已足够稳定、可以成为原子笔记的知识;
- 或者只是需要作为来源留存、不必再往前推进的东西。
这样就避免了一种我认为在 AI 记忆系统里尤其危险的偏差。
如果 AI 的每一次产出都自动成为系统的知识,AI 最终就能把自己先前的产出当作证据来用。
所以我尽量保持严格的分隔:
来源 ≠ 知识 ≠ 状态 ≠ 综合 ≠ 交付物
来源说的是:
这是有人说过或观察到的东西。
而稳定下来的知识说的是另一回事:
这是系统从此认为已足够确立、可以复用的东西。
口袋里的 Contexte
正是在手机上,这次移植对我来说才真正有意思。
我本来就大量使用语音输入。
而在这种情况下,它彻底改变了我和系统的关系。
还是拿行业展会举例。
我带着一个事先准备好的 Contexte 到场。
在手机上:
打开 展会-X
我和第一位参展商聊了聊。
离开展位时,我未必想停下来,打开笔记应用,在小键盘上敲五分钟。
我一边走向下一个展位,一边直接把刚了解到的东西口述给 ChatGPT。
然后:
持久化 <我刚口述的内容>
这可能要花几十秒。
我继续我的一天。
几轮交流之后:
摄入
引擎于是开始把我采集到的东西结构化。
也正是在这里,它的用处开始超出一个单纯的记笔记系统。
我可以问 ChatGPT:
要真正理解这个主题,我还缺什么?
或者:
哪些矛盾应该找下一位参展商核实?
又或者:
有哪些重要的问题我还没问过任何人?
我可以在人还在展会上的时候就拿到答案。
于是能立刻去补问那些遗漏的问题。
循环变成:
交流
   ↓
边走边语音口述
   ↓
持久化
   ↓
摄入
   ↓
寻找盲点
   ↓
回去提问
   ↓
补全 Contexte
这大概是对我的用法改变最大的地方。
AI 不再只是在采集之后介入,帮我产出点什么。
它可以在采集过程中介入,趁信息质量还来得及提升的时候。
Plaud:把对话带进 Contexte
我还在用一台 Plaud Note Pro。
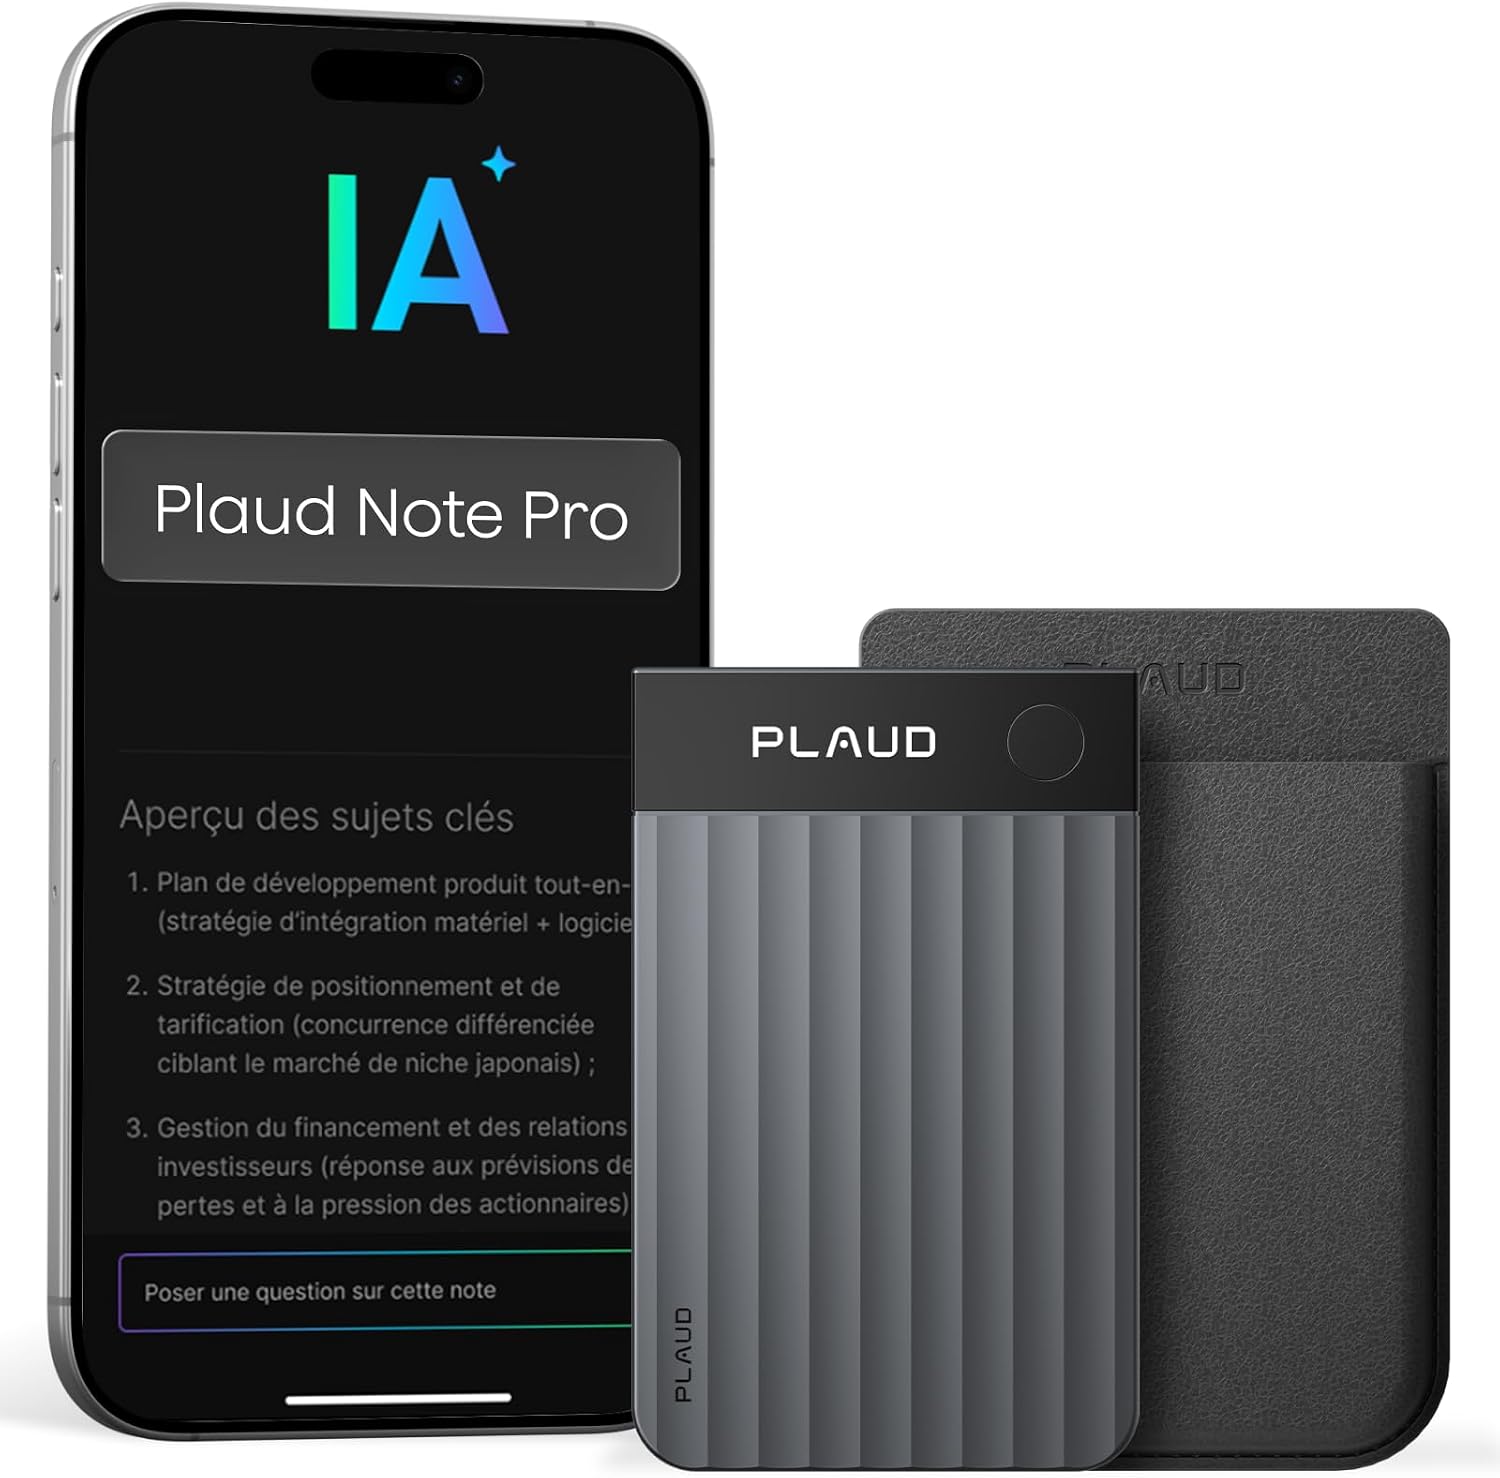
我的 Plaud Note Pro,可以用来在现场录下对话和采访。
Plaud Note Pro 是一款小巧的录音设备,可以用来录制会议、对话或采访。
录音随后会出现在 Plaud 里,并且可以转写。
不过对我的系统来说,我最感兴趣的并不是 Plaud 自动生成的摘要。
我要拿到的是完整的转写稿。
还有一块很重要的拼图:ChatGPT 可以通过连接器直接访问 Plaud。
所以我可以在 ChatGPT 里直接这样问:
列出我最近的三段 Plaud 录音,每段用一句话告诉我它讲了什么。
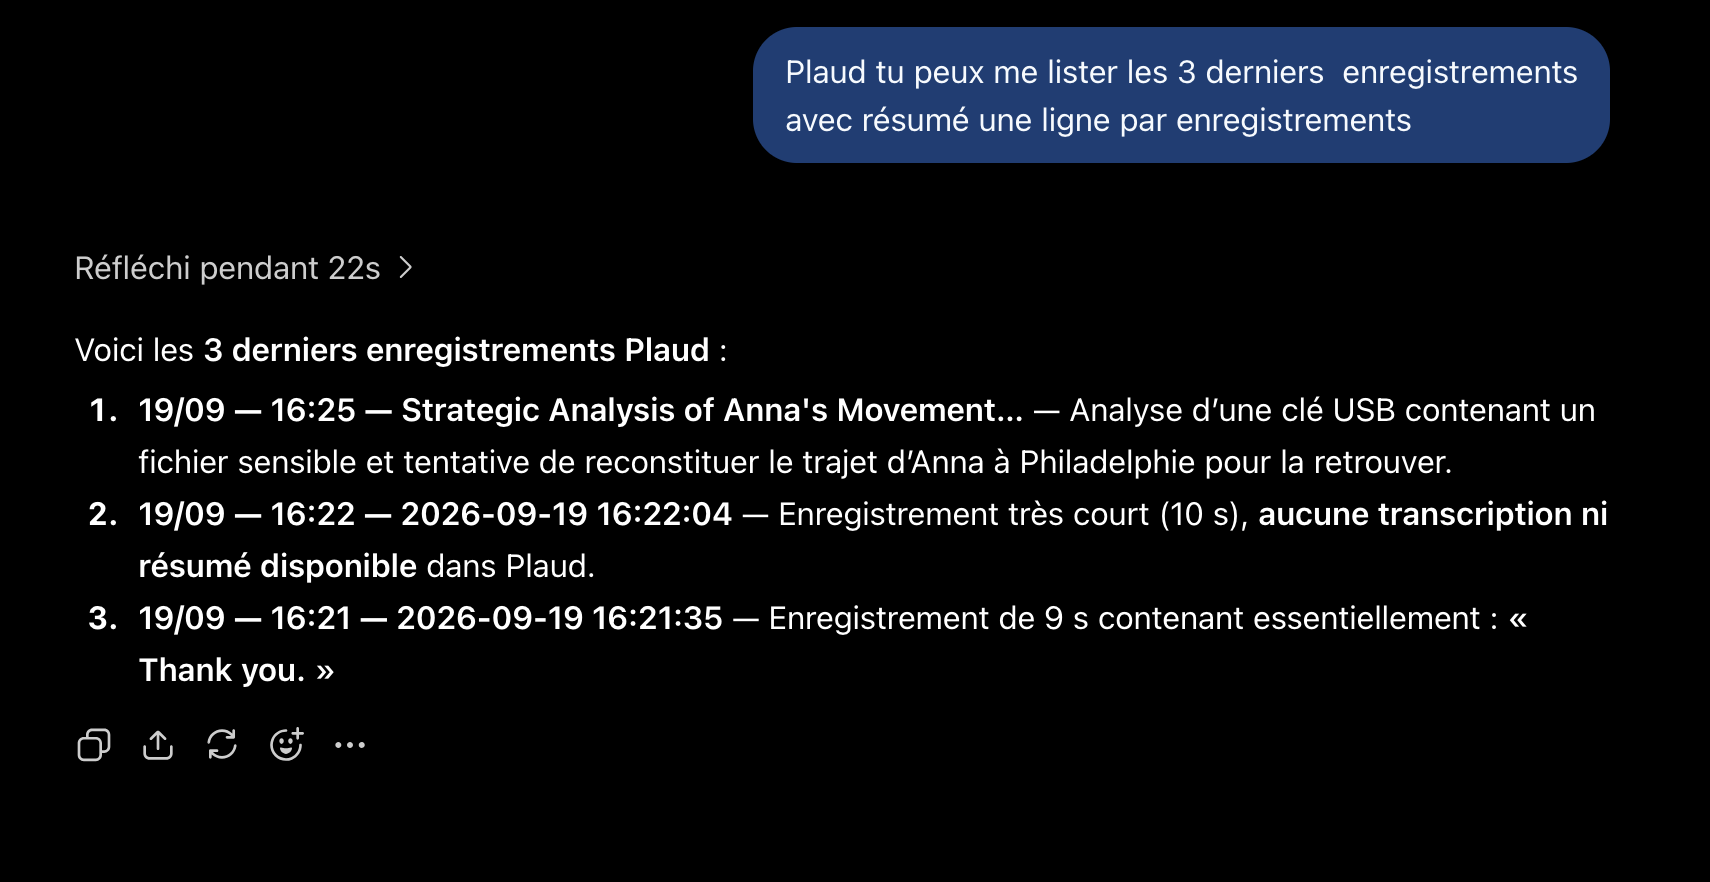
在 ChatGPT 里查询 Plaud、找出最近录音的示例。
ChatGPT 可以找到这些录音,再直接取回它们的转写稿。
这样就能设想一个直接得多的工作流:
真实对话
        ↓
Plaud
        ↓
转写
        ↓
ChatGPT 直接取回转写稿
        ↓
持久化
        ↓
Contexte 的原始来源
        ↓
摄入
所以我不需要:
- 手动下载文件;
- 打开转写稿;
- 复制它;
- 回到 ChatGPT;
- 粘贴进去。
这一切我都可以在手机上用语音自动完成。
而且,我更愿意把完整的原始转写稿放进 Contexte,而不是一份简单的摘要。
摘要本身已经是一种解读。
转写稿则离原始材料近得多。
对话一旦进入 Contexte,我就可以问:
- 这个人刚才真正告诉了我什么?
- 有什么和之前的对话相矛盾?
- 哪些说法值得核实?
- 我应该问下一个人哪些问题?
所需的各个组件已经都能运转。
不过,我还没有在漫长的现场工作日里,把 Plaud → ChatGPT → Contexte 这条工作流从头到尾充分检验过,还不能说它已经完全顺畅。
所以这仍是一种有待进一步测试的用法。
如何复现这个系统
我准备了两个文件,对应引擎的两层指令。
CORE
CORE 在这里:
这一部分需要复制到 ChatGPT 项目的指令里。
扩展指令
详细的指令在这里:
它需要复制到一个 ChatGPT 能访问的 Google Doc 里。
开始之前,当然要先把 Google Drive 连接到 ChatGPT,并允许它访问引擎用到的文档。
配置 ID
CORE 里包含两个关键的标识符:
DOCUMENT_ID = xxxx
FOLDER_ID = xxxx
DOCUMENT_ID 对应存放扩展指令的那个 Google Doc。
在这样一个 URL 里:
https://docs.google.com/document/d/xxxx/edit
xxxx 这部分就是文档的标识符。
FOLDER_ID 对应用来存放各个 Contexte 的 Google Drive 文件夹。
对于这样一个 URL:
https://drive.google.com/drive/folders/xxxx
标识符同样是 xxxx 这部分。
每个使用者当然都要把这些值换成自己环境里的值。
每个 Contexte 一个 Spreadsheet
新建一个 Contexte 时,引擎会创建一个包含以下内容的 Spreadsheet:
00-FRAME
01-STATE
03-SESSIONS
04-ATOMIC
05-OUTPUTS
随后它被放进 FOLDER_ID 指定的文件夹。
不需要把每个 Spreadsheet 的 ID 手动抄进指令里。
当我要求:
打开 我的 Contexte
ChatGPT 会在存放 Contexte 的文件夹里搜索对应的 Spreadsheet,取得它的 ID,然后在整个对话期间记住它。
系统就此可以投入使用。
这个土办法能做什么,以及它的局限
这个 ChatGPT 版本并不取代我配合 Codex 或 Claude Code 使用的引擎。
那本来也不是目标。
它有好几处局限。
它更慢。
对于直接需要 Python 脚本、API 调用或更丰富运行环境的 Contexte,它不太合适。
最重要的是,一个 Contexte 在几周时间里真正膨胀起来之后,它会表现如何,我还缺乏足够的观察。
所以我把它看作一种互补的独立模式。
在 Mac 上,Codex 或 Claude Code 对某些任务仍然更合适。
但在手机上,我现在可以使用 Contexte,而不用依赖我的 Mac 开着且可以访问。
而这正是我想解决的问题。
还有一个和 Codex 额度有关的有趣现象。
在 ChatGPT 里做这整个实验期间,显示的 Codex 额度一点没减。
观察到的消耗:
0
我当然不是说,这就构成了 OpenAI 如何计费或统计这类用量的一般规律。
我只是注意到,在这次实验中,这个土办法没有消耗我的 Codex 额度。
这个系统已经用来写出了这篇文章
起初,我的第一个 Google Sheets hack 回答的是一个相当有限的问题:
如何把一条信息从 ChatGPT 里带出来,并长期保存?
几天之后,问题变成了:
如果我把 Contexte 的全部结构化记忆都搬出去呢?
这正是这个系统最终做到的事。
ChatGPT 不再需要“记住一切”。
它主要需要知道:
- 去哪里找;
- 加载什么;
- 持久化什么;
- 如何给信息定性;
- 如何找回已经学到的东西;
- 工作进行到哪一步。
公式依然相当简单:
ChatGPT 负责推理。
指令定义引擎。
Google Sheets 负责记忆。
还有一点让人相当满足:这篇文章的准备和写作,本身就是在检验文章所描述的这个系统。
为了准备这篇文字,我只用了 ChatGPT 里的这个 Contexte。
我把自己的想法持久化进去。
我把它们摄入。
我们一起找出了盲点。
我修改了一些措辞。
我们创建了任务,又把它们完成。
我补上了缺失的内容。
然后我写出了文章的第一版,重读一遍,再用同一个 Contexte 准备了这个 V2。
换句话说,这个系统不只是充当了一个技术演示。
它已经真正完成了我当初搭建它所要承担的工作。
所以,问题已经不再是:
它能用吗?
它能用。
我现在关心的问题是:
当同一个 Contexte 在现场经受整整一周行业展会的考验时,这套架构是否依然这么好用?
接下来的使用会给出答案。