原文为法语。由 AI 翻译——保留的是含义,而非文风。
Graphify 原本是一个绘制代码图谱的工具,做法是付钱让 AI 逐个读取文件。我把它挪作他用,绘制我的知识 wiki,不用 AI,也不用 API 密钥。只需一个 160 行的 Python 文件,计算 0.2 秒,一千条笔记就变成了一张可以探索、查询和浏览的图谱。
一千条关于市场营销的笔记。有原子笔记,有术语表条目,有按书整理的阅读地图。它们彼此链接,而且每条链接都说明了自己为什么存在。
即便如此,我还是看不到整体的形状。一些问题也没法简单回答,比如:Cialdini 的互惠原则和一家 SaaS 公司的 churn 之间有什么关系?哪些笔记处在主题的核心,哪些是孤立的?
Obsidian 的图谱视图呈现的是一团毛线。好看,却什么也说不出。
本文讲的是我如何把 Graphify 这个为代码设计的工具挪作他用,用到这个 wiki 上,得到一张真正能用的图谱,以及这张图谱让我对自己的知识库有了哪些认识。
起点:一个链接有意义的 wiki
我已经写过我为什么搭建一个由 AI 维护的知识库。原理是:我把书和文档交给 Claude,由它从中提取原子笔记、术语表条目以及其他类型的卡片,再把它们彼此链接起来。
对后面的内容而言,有一条规则比其他所有规则都重要:链接绝不能只是装饰。每条链接后面都跟着一句简短的话,说明两者的关系。
- [[GLO00614-marche-minimal-viable]] — le MVMarket est la stratégie
  pour traverser le chasm, pas le chasm lui-même.
- [[GLO00619-technology-adoption-life-cycle]] — cadre dans lequel
  le chasm s'inscrit.
换句话说,想法之间的关系早已白纸黑字写在笔记里。正是这个细节,让后面的一切成为可能。
Graphify 是什么?
Graphify 能把一个代码或文档文件夹变成知识图谱,之后可以在 Claude Code 这样的助手里对它进行查询。
它分两步工作。
- 构建。Graphify 让 AI 逐个读取文件,由 AI 推断出其中的重要元素以及它们之间的关系。这是代价高昂的一步:它消耗 token,而且每次运行的结果都不一样。
- 探索。图谱构建好之后,Graphify 把它切分成由相近节点组成的群组,生成一张交互式地图和一份报告,并回答各种问题:某个元素有哪些连接,哪条路径把 A 和 B 连起来。
挪作他用的思路
在代码仓库里,构建这一步是有道理的:没人白纸黑字写下某个函数调用了另一个函数,必须靠推断。
在我的 wiki 里,情况正好相反。AI 没有什么需要推断的。关系已经在那里,要么是手写的,要么是在导入时确认过的。付钱让 AI 把它们重新发现一遍,既贵又慢,还不如早已写明的内容忠实。
于是我用一个自己写的小脚本替换了构建这一步,Graphify 的其余部分全部保留。
wiki 笔记(.md)
      │
      │  自写脚本:读取 [[...]] 链接及其说明
      ▼
graph.json  (NetworkX 标准格式)
      │
      │  Graphify:群组、地图、报告、问答
      ▼
graph.html · GRAPH_REPORT.md · explain · path · query
让这次挪作他用成为可能的关键在于:Graphify 接受任何符合 NetworkX 库标准格式的图谱。它不检查图谱从何而来。只要交给它就行。
内部机制:只有一个文件
这个脚本做三件事。
1. 清点笔记。每个 Markdown 文件成为一个节点。节点的标识符就是文件名,类型则由前缀推断:ATO 表示原子笔记,GLO 表示术语表,MOC 表示阅读地图,等等。
2. 找出链接。用一个正则表达式找出文本中的每个 [[ID-slug]]。如果目标笔记存在,就建立一条链接。
3. 为关系命名。链接后面破折号之后的文字,成为这条关系的名称。正因如此,Graphify 才能显示“MVMarket 是跨越 chasm 的策略”,而不只是一个简单的“链接”。
for line in text.splitlines():
    matches = LINK_RE.findall(line)
    relation_match = re.search(r"\]\]\s*[—-]+\s*(.+)", line)
    relation = relation_match.group(1).strip()[:80] if relation_match else "links"
无需安装任何库:脚本只用到 Python 自带的模块。下面是完整文件。
"""
Build graph.json from Obsidian [[links]] in wiki notes — no LLM needed.
Output format: NetworkX node_link_graph (compatible with graphify path/explain/query).

Usage:
    .venv/bin/python scripts/build_graph.py [--theme maintenance] [--output _GRAPHITY/]
"""

import argparse
import json
import re
import uuid
from pathlib import Path

WIKI_ROOT = Path(__file__).resolve().parent.parent.parent.parent / "wiki"
LINK_RE = re.compile(r"\[\[([A-Z]{2,3}\d{5}-[^\]\|]+?)(?:\|[^\]]*)?\]\]")
FRONTMATTER_RE = re.compile(r"^---\n(.*?)\n---", re.DOTALL)

TYPE_MAP = {
    "ATO": "atomic_note",
    "GLO": "glossary_term",
    "NOR": "norm_reference",
    "EXN": "normative_requirement",
    "PRO": "business_process",
    "OBJ": "domain_object",
    "BRL": "business_rule",
    "REG": "regulatory_text",
    "HAB": "habilitation",
    "IND": "indicator",
    "MOC": "moc",
    "SRC": "source_record",
}


def parse_frontmatter(text: str) -> dict:
    m = FRONTMATTER_RE.match(text)
    if not m:
        return {}
    result = {}
    for line in m.group(1).splitlines():
        if ":" in line:
            k, _, v = line.partition(":")
            result[k.strip()] = v.strip().strip('"')
    return result


def slug_to_id(slug: str) -> str:
    """Extract the ID prefix (e.g. 'ATO00001') from a slug like 'ATO00001-some-title'."""
    parts = slug.split("-", 1)
    return parts[0].upper()


def build_graph(theme: str, output_dir: Path) -> dict:
    notes_root = WIKI_ROOT / "themes" / theme / "notes"
    if not notes_root.exists():
        raise SystemExit(f"Notes directory not found: {notes_root}")

    nodes = {}   # node_id -> node dict
    edges = []   # list of {source, target, relation}

    md_files = list(notes_root.rglob("*.md"))
    md_files = [f for f in md_files if f.name != "README.md"]

    # Index: slug -> node_id (file stem without extension)
    slug_index = {}
    for f in md_files:
        stem = f.stem  # e.g. ATO00001-some-title
        slug_index[stem] = stem
        # Also index by bare ID (ATO00001) for robustness
        bare_id = stem.split("-")[0]
        slug_index.setdefault(bare_id, stem)

    print(f"[build_graph] {len(md_files)} notes found in {notes_root}")

    for f in md_files:
        text = f.read_text(encoding="utf-8")
        fm = parse_frontmatter(text)

        node_id = f.stem
        prefix = node_id[:3].upper()
        node_type = TYPE_MAP.get(prefix, "note")
        title = fm.get("title") or fm.get("term") or fm.get("name") or node_id
        subdir = f.parent.name  # e.g. "atomiques", "glossaire"

        nodes[node_id] = {
            "id": node_id,
            # label = slug so graphify path/explain resolve by ID (e.g. "ATO00001-...")
            "label": node_id,
            "title": title,
            # norm_label includes slug tokens for fuzzy matching
            "norm_label": node_id.lower().replace("-", " "),
            "type": node_type,
            "kind": node_type,
            "source_file": str(f.relative_to(WIKI_ROOT.parent)),
            "subdir": subdir,
            "status": fm.get("status", "draft"),
            "uid": fm.get("uid") or str(uuid.uuid4()),
            "wiki_id": fm.get("id", ""),
        }

    # Second pass: extract links
    seen_edges = set()
    for f in md_files:
        text = f.read_text(encoding="utf-8")
        source_id = f.stem

        # Extract label from link context line (text after — )
        for line in text.splitlines():
            matches = LINK_RE.findall(line)
            # Extract relation label from "— relation text" after the link
            relation_match = re.search(r"\]\]\s*[—-]+\s*(.+)", line)
            relation = relation_match.group(1).strip()[:80] if relation_match else "links"

            for slug in matches:
                # Resolve target
                target_id = slug_index.get(slug) or slug_index.get(slug.split("-")[0])
                if not target_id or target_id == source_id:
                    continue
                if target_id not in nodes:
                    continue
                key = (source_id, target_id)
                if key in seen_edges:
                    continue
                seen_edges.add(key)
                edges.append({
                    "source": source_id,
                    "target": target_id,
                    "relation": relation,
                    "key": 0,
                })

    node_list = list(nodes.values())

    graph_data = {
        "directed": True,
        "multigraph": False,
        "graph": {"theme": theme},
        "nodes": node_list,
        "links": edges,
    }

    output_dir.mkdir(parents=True, exist_ok=True)
    graph_path = output_dir / "graph.json"
    graph_path.write_text(json.dumps(graph_data, ensure_ascii=False, indent=2), encoding="utf-8")

    print(f"[build_graph] {len(node_list)} nodes, {len(edges)} edges")
    print(f"[build_graph] graph.json → {graph_path}")
    return graph_data


if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("--theme", default="maintenance")
    parser.add_argument("--output", default="_GRAPHITY/")
    args = parser.parse_args()

    build_graph(args.theme, Path(args.output) / args.theme)
在市场营销主题上的效果
我 wiki 里的市场营销主题来自二十来本书:Dunford、Seth Godin、Cialdini、Moore、Ries 和 Trout、Nagle、Byron Sharp、Rob Fitzpatrick……
| 指标 | 数值 |
|---|---|
| 笔记 | 1013 |
| 链接 | 6442 |
| 检测到的笔记群组 | 22 |
| 图谱构建时间 | 0.2 秒 |
| 消耗的 AI token | 0 |
地图及其笔记群组
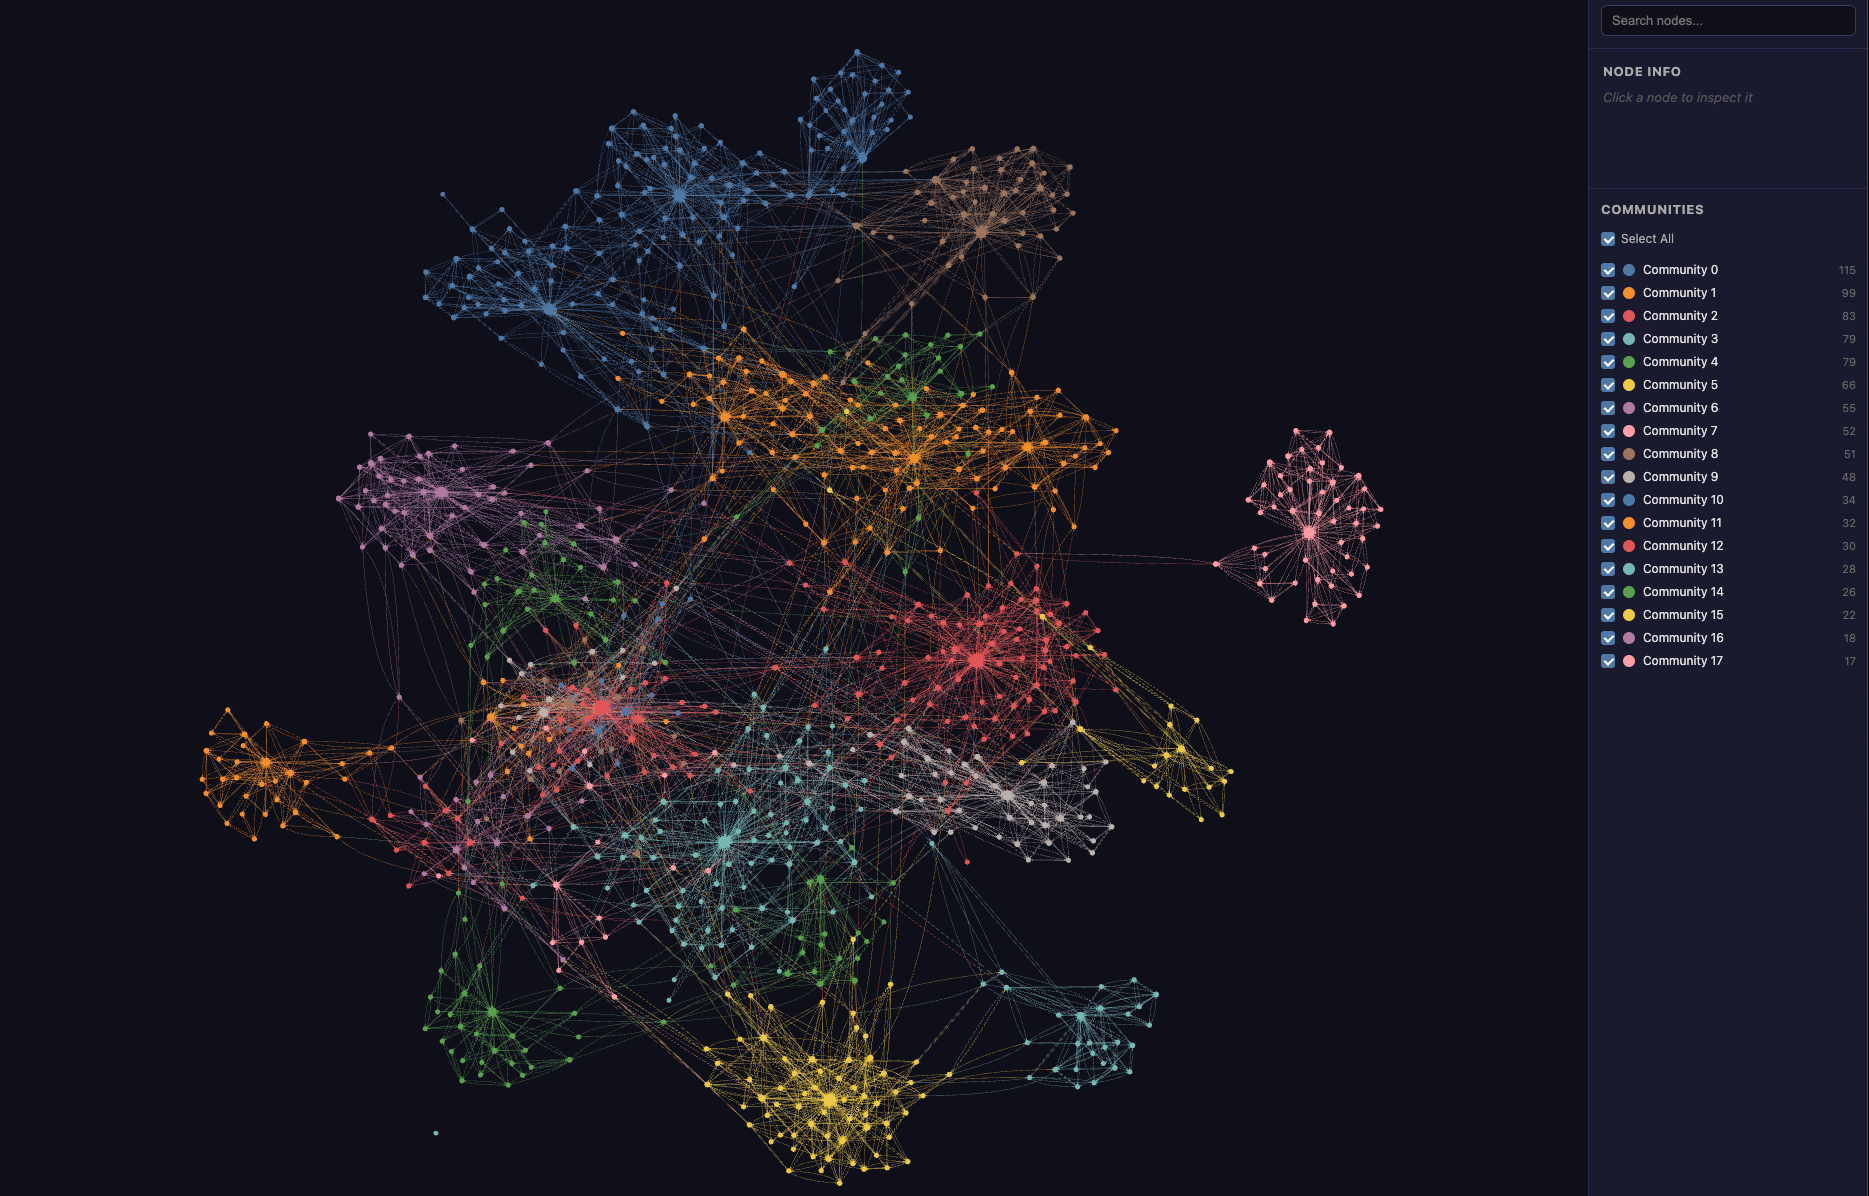
Graphify 把图谱切分成若干笔记群组,群组内部的笔记彼此之间的链接比与其余部分的链接更多。在市场营销主题上找到的几个群组:
- 围绕 Mom Test 的 53 条笔记:客户访谈,一文不值的恭维,重过去的事实而非未来的承诺。
- 关于影响力的 52 条笔记:Cialdini 的六大原则,互惠,知觉对比,让人顺从的那句“因为”。
- 关于 chasm 的 46 条笔记:early adopters 与务实大众之间的鸿沟,保龄球瓶策略。
- 关于 customer success 的 26 条笔记:churn 是一种死亡螺旋,customer success 与客服支持的区别。
报告还列出了连接最多的笔记。排名前十的全是阅读地图:Dunford 的 Obviously Awesome 以 180 条链接位居第一,领先于 Seth Godin 的 This is Marketing 的 156 条。
最后,报告还标出了孤立笔记。1013 条中只有一条:一条关于营销用户画像的笔记,没有任何东西把它和其余部分连起来。这是 wiki 里的一个缺口,没花一分钱就找到了。
一条笔记的连接
让 Graphify 说明关于 chasm 的那条术语表笔记:
graphify explain "GLO00618-chasm"
它给出这条笔记的 30 个连接,涵盖两个方向,并附上每个连接的关系。节选如下:
| 方向 | 关联笔记 | 笔记中写明的关系 |
|---|---|---|
| ← | Crossing the Chasm 的阅读地图 | 该模型的核心鸿沟 |
| → | 技术采用生命周期 | chasm 所处的框架 |
| → | early adopters 追求颠覆性的优势,大众追求渐进式的改进 | 解释了 chasm 的心理成因 |
| ← | 完整产品(whole product) | chasm 部分源于缺少完整产品 |
| ← | Bowling alley | 在跨越 chasm 之后开始 |
| → | Moore 的鸿沟把 early adopters 与大众市场隔开 | 同一个想法,来自 Seth Godin 对 Moore 的引用 |
→:chasm 引用了这条笔记。←:这条笔记引用了 chasm。
最后一行最有意思。chasm 出自 Geoffrey Moore,但 Seth Godin 在另一本书里也谈到了它。图谱显示,两个来源在同一个想法上交汇了。
两个遥远想法之间的路径
Cialdini 的互惠原则,一条社会心理学原理,和订阅制业务里的 churn 之间有什么关系?
graphify path \
  "ATO01269-la-regle-de-reciprocite..." \
  "ATO01404-dans-un-business-de-revenus-recurrents-le-churn..."
Graphify 找到了一条 8 步的路径:
- 互惠原则是普遍存在的,是人类合作的基础
- → Influence(Cialdini)的阅读地图
- → 最初的承诺会改变自我形象,并带来自动的一致性
- → 高风险造就信任;降价反而削弱信任
- → 相近:高价格传递质量信号并支撑信任 → 价格–质量效应让人把高价格视为质量的信号
- → The Strategy and Tactics of Pricing(Nagle)的阅读地图
- → 转换成本降低价格敏感度 → 汇合:switching costs 是留存的主要杠杆 → 留存是最强大的增长倍增器
- → 与 Customer Success 的论点汇合:churn 摧毁增长 → 在经常性收入业务中,churn 是一种死亡螺旋
这条路径讲了一个故事:从承诺的心理学,到价格作为信任的信号,再从转换成本走到留存。没有人一口气写下这段推理。它是从一条条笔记、一本本书里建立起来的链接中自然浮现的。
比 Obsidian 的图谱视图多了什么
Obsidian 的图谱视图只画出链接。Graphify 还能:
- 自动检测笔记群组;
- 为关系命名,沿用笔记中写下的说明;
- 找出两条笔记之间最短的路径;
- 生成报告:核心笔记、孤立笔记、意想不到的连接;
- 通过命令行使用,因此 Claude 在处理 wiki 时可以自己去查询它。
局限
按问题搜索只看标题。Graphify 还有一个自由搜索命令。它在笔记名称里而不是内容里查找问题中的词,然后扩展到相邻的笔记。如果问题里没有用到标题中的词,就什么也找不到。
群组跟着书走,而不是跟着概念走。以定位为例,它被拆散到五个群组里,基本是按出处划分:一边是 Dunford,一边是 Ries 和 Trout。按书整理的阅读地图集中了太多链接,以至于主导了整张图谱的结构。路径也受同样的影响:从 chasm 到支付意愿的那条路径要经过三张阅读地图,没错,但没什么启发。
群组没有名称。Graphify 可以用 AI 给群组命名,但那等于把我想避开的成本又请了回来。所以它们叫作“Community 0”“Community 1”……由我自己去解读。
Graphify 终究是为代码设计的工具。每次构建,它都会报出 12884 条警告:链接没有“源文件”,而这个概念只对代码有意义。这没有什么影响,但提醒我们,这个工具正被用在设计用途之外。
图谱的价值取决于链接的质量。没有说明的链接会变成一条什么也没说的“links”关系。链接得不好的笔记依然孤立。图谱什么也不纠正,它只负责呈现。
自己动手复现
你需要一组用 [[...]] 链接起来的 Markdown 笔记:
- 可以是你自己维护链接的 Obsidian 仓库;
- 也可以是由 AI 维护的 wiki,比如这篇文章里描述的那种。
上面的脚本假定标识符形如 ATO00001-slug,并按主题组织目录。你需要根据自己的组织方式,调整链接的正则表达式和笔记所在的文件夹。
然后,三条命令:
pip install graphifyy

python build_graph.py --theme marketing --output _GRAPHITY/

graphify cluster-only _GRAPHITY/marketing/ --no-label \
  --graph _GRAPHITY/marketing/graph.json
交互式地图会出现在 _GRAPHITY/marketing/graphify-out/graph.html,报告 GRAPH_REPORT.md 就在它旁边。explain 和 path 命令可以直接作用于 graph.json 文件。
AI 没有什么需要推断的。只要读一读早已写下的东西就够了。