원문은 프랑스어입니다. AI로 번역했습니다 — 문체가 아니라 의미를 보존했습니다.
Graphify는 AI에게 비용을 내고 파일을 하나씩 읽혀 코드를 지도로 만드는 도구입니다. 저는 이 도구를 다른 용도로 써서, AI도 API 키도 없이 제 지식 위키를 지도로 만들었습니다. 160줄짜리 Python 파일 하나, 계산 시간 0.2초면 노트 천 개가, 탐색하고 질문을 던지고 따라가 볼 수 있는 그래프로 바뀝니다.
마케팅 노트가 천 개 있습니다. 원자 노트, 용어집 정의, 책마다 하나씩 만든 독서 맵입니다. 모두 서로 링크되어 있고, 링크마다 그 링크가 왜 존재하는지 설명이 붙어 있습니다.
그런데도 전체 모양은 보이지 않습니다. 이런 질문에 간단히 답할 수가 없습니다. Cialdini의 상호성 원칙과 SaaS의 churn을 잇는 것은 무엇일까? 어떤 노트가 주제의 중심에 있고, 어떤 노트가 고립되어 있을까?
Obsidian의 그래프 뷰는 털실 뭉치를 보여 줍니다. 아름답지만, 아무 말도 하지 않습니다.
이 글은 코드용으로 설계된 도구인 Graphify를 다른 용도로 써서 이 위키의 쓸모 있는 그래프를 얻어 낸 과정, 그리고 그 그래프가 제 노트 베이스에 대해 알려 준 것을 다룹니다.
출발점: 링크에 의미가 있는 위키
AI가 관리하는 지식 베이스를 왜 만들었는지는 이미 쓴 적이 있습니다. 원리는 이렇습니다. 제가 Claude에게 책과 문서를 건네면, Claude가 거기서 원자 노트, 용어집 항목, 그 밖의 여러 유형의 카드를 뽑아내고 서로 링크합니다.
앞으로 이어질 이야기에서 무엇보다 중요한 규칙이 하나 있습니다. 링크는 결코 장식이어서는 안 됩니다. 모든 링크 뒤에는 관계를 설명하는 짧은 문장이 붙습니다.
- [[GLO00614-marche-minimal-viable]] — le MVMarket est la stratégie
  pour traverser le chasm, pas le chasm lui-même.
- [[GLO00619-technology-adoption-life-cycle]] — cadre dans lequel
  le chasm s'inscrit.
다시 말해, 아이디어 사이의 관계가 이미 노트 안에 분명하게 적혀 있습니다. 나머지 모든 것을 가능하게 하는 것이 바로 이 디테일입니다.
Graphify란 무엇인가
Graphify는 코드나 문서가 담긴 폴더를 지식 그래프로 바꾸고, Claude Code 같은 어시스턴트에서 그 그래프에 질문할 수 있게 해 줍니다.
작동은 두 단계로 이루어집니다.
- 구축. Graphify는 AI에게 파일을 하나씩 읽게 하고, AI는 중요한 요소와 그 사이의 관계를 추론합니다. 비용이 드는 단계입니다. 토큰을 소비하고, 실행할 때마다 결과가 달라집니다.
- 탐색. 그래프가 만들어지면 Graphify는 가까운 노드끼리 그룹으로 나누고, 인터랙티브 맵과 리포트를 생성하고, 질문에 답합니다. 어떤 요소의 연결은 무엇인지, A와 B를 잇는 경로는 무엇인지 같은 질문입니다.
용도 변경의 아이디어
코드 저장소에서는 구축 단계가 의미가 있습니다. 어떤 함수가 어떤 함수를 호출하는지 누군가 분명하게 적어 둔 적이 없으니, 추론해야 합니다.
제 위키는 정반대입니다. AI가 추론할 것이 없습니다. 관계는 이미 거기 있습니다. 손으로 썼거나, 노트를 수집하는 시점에 검증한 것입니다. 그것을 다시 찾아내라고 AI에 비용을 치르는 것은 비싸고, 느리고, 이미 적혀 있는 것보다 덜 정확합니다.
그래서 구축 단계를 작은 자작 스크립트로 바꾸고, Graphify의 나머지는 모두 그대로 두었습니다.
Notes du wiki (.md)
      │
      │  script maison : lit les liens [[...]] et leur explication
      ▼
graph.json  (format standard NetworkX)
      │
      │  Graphify : groupes, carte, rapport, questions
      ▼
graph.html · GRAPH_REPORT.md · explain · path · query
이 용도 변경을 가능하게 하는 지점은 이것입니다. Graphify는 NetworkX 라이브러리의 표준 형식으로 된 그래프라면 무엇이든 받아들입니다. 그 그래프가 어디서 왔는지는 확인하지 않습니다. 건네주기만 하면 됩니다.
내부 구조: 파일 하나
스크립트는 세 가지 일을 합니다.
1. 노트 목록 만들기. Markdown 파일 하나가 노드 하나가 됩니다. 식별자는 파일 이름이고, 유형은 접두어로 정해집니다. 원자 노트는 ATO, 용어집은 GLO, 독서 맵은 MOC 하는 식입니다.
2. 링크 찾기. 정규 표현식이 본문에서 [[ID-slug]]를 하나하나 찾아냅니다. 대상 노트가 존재하면 링크가 만들어집니다.
3. 관계에 이름 붙이기. 링크 뒤의 대시 다음에 적힌 문장이 관계의 이름이 됩니다. 덕분에 Graphify는 단순한 "링크" 대신 "MVMarket은 chasm을 건너기 위한 전략이다"라고 보여 줄 수 있습니다.
for line in text.splitlines():
    matches = LINK_RE.findall(line)
    relation_match = re.search(r"\]\]\s*[—-]+\s*(.+)", line)
    relation = relation_match.group(1).strip()[:80] if relation_match else "links"
설치할 라이브러리는 없습니다. 스크립트는 Python에 기본으로 들어 있는 모듈만 씁니다. 전체 파일은 다음과 같습니다.
"""
Build graph.json from Obsidian [[links]] in wiki notes — no LLM needed.
Output format: NetworkX node_link_graph (compatible with graphify path/explain/query).

Usage:
    .venv/bin/python scripts/build_graph.py [--theme maintenance] [--output _GRAPHITY/]
"""

import argparse
import json
import re
import uuid
from pathlib import Path

WIKI_ROOT = Path(__file__).resolve().parent.parent.parent.parent / "wiki"
LINK_RE = re.compile(r"\[\[([A-Z]{2,3}\d{5}-[^\]\|]+?)(?:\|[^\]]*)?\]\]")
FRONTMATTER_RE = re.compile(r"^---\n(.*?)\n---", re.DOTALL)

TYPE_MAP = {
    "ATO": "atomic_note",
    "GLO": "glossary_term",
    "NOR": "norm_reference",
    "EXN": "normative_requirement",
    "PRO": "business_process",
    "OBJ": "domain_object",
    "BRL": "business_rule",
    "REG": "regulatory_text",
    "HAB": "habilitation",
    "IND": "indicator",
    "MOC": "moc",
    "SRC": "source_record",
}


def parse_frontmatter(text: str) -> dict:
    m = FRONTMATTER_RE.match(text)
    if not m:
        return {}
    result = {}
    for line in m.group(1).splitlines():
        if ":" in line:
            k, _, v = line.partition(":")
            result[k.strip()] = v.strip().strip('"')
    return result


def slug_to_id(slug: str) -> str:
    """Extract the ID prefix (e.g. 'ATO00001') from a slug like 'ATO00001-some-title'."""
    parts = slug.split("-", 1)
    return parts[0].upper()


def build_graph(theme: str, output_dir: Path) -> dict:
    notes_root = WIKI_ROOT / "themes" / theme / "notes"
    if not notes_root.exists():
        raise SystemExit(f"Notes directory not found: {notes_root}")

    nodes = {}   # node_id -> node dict
    edges = []   # list of {source, target, relation}

    md_files = list(notes_root.rglob("*.md"))
    md_files = [f for f in md_files if f.name != "README.md"]

    # Index: slug -> node_id (file stem without extension)
    slug_index = {}
    for f in md_files:
        stem = f.stem  # e.g. ATO00001-some-title
        slug_index[stem] = stem
        # Also index by bare ID (ATO00001) for robustness
        bare_id = stem.split("-")[0]
        slug_index.setdefault(bare_id, stem)

    print(f"[build_graph] {len(md_files)} notes found in {notes_root}")

    for f in md_files:
        text = f.read_text(encoding="utf-8")
        fm = parse_frontmatter(text)

        node_id = f.stem
        prefix = node_id[:3].upper()
        node_type = TYPE_MAP.get(prefix, "note")
        title = fm.get("title") or fm.get("term") or fm.get("name") or node_id
        subdir = f.parent.name  # e.g. "atomiques", "glossaire"

        nodes[node_id] = {
            "id": node_id,
            # label = slug so graphify path/explain resolve by ID (e.g. "ATO00001-...")
            "label": node_id,
            "title": title,
            # norm_label includes slug tokens for fuzzy matching
            "norm_label": node_id.lower().replace("-", " "),
            "type": node_type,
            "kind": node_type,
            "source_file": str(f.relative_to(WIKI_ROOT.parent)),
            "subdir": subdir,
            "status": fm.get("status", "draft"),
            "uid": fm.get("uid") or str(uuid.uuid4()),
            "wiki_id": fm.get("id", ""),
        }

    # Second pass: extract links
    seen_edges = set()
    for f in md_files:
        text = f.read_text(encoding="utf-8")
        source_id = f.stem

        # Extract label from link context line (text after — )
        for line in text.splitlines():
            matches = LINK_RE.findall(line)
            # Extract relation label from "— relation text" after the link
            relation_match = re.search(r"\]\]\s*[—-]+\s*(.+)", line)
            relation = relation_match.group(1).strip()[:80] if relation_match else "links"

            for slug in matches:
                # Resolve target
                target_id = slug_index.get(slug) or slug_index.get(slug.split("-")[0])
                if not target_id or target_id == source_id:
                    continue
                if target_id not in nodes:
                    continue
                key = (source_id, target_id)
                if key in seen_edges:
                    continue
                seen_edges.add(key)
                edges.append({
                    "source": source_id,
                    "target": target_id,
                    "relation": relation,
                    "key": 0,
                })

    node_list = list(nodes.values())

    graph_data = {
        "directed": True,
        "multigraph": False,
        "graph": {"theme": theme},
        "nodes": node_list,
        "links": edges,
    }

    output_dir.mkdir(parents=True, exist_ok=True)
    graph_path = output_dir / "graph.json"
    graph_path.write_text(json.dumps(graph_data, ensure_ascii=False, indent=2), encoding="utf-8")

    print(f"[build_graph] {len(node_list)} nodes, {len(edges)} edges")
    print(f"[build_graph] graph.json → {graph_path}")
    return graph_data


if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("--theme", default="maintenance")
    parser.add_argument("--output", default="_GRAPHITY/")
    args = parser.parse_args()

    build_graph(args.theme, Path(args.output) / args.theme)
마케팅 주제에 적용한 결과
제 위키의 마케팅 주제는 책 스무 권 남짓으로 채워져 있습니다. Dunford, Seth Godin, Cialdini, Moore, Ries와 Trout, Nagle, Byron Sharp, Rob Fitzpatrick 등입니다.
| 항목 | 값 |
|---|---|
| 노트 | 1,013 |
| 링크 | 6,442 |
| 감지된 노트 그룹 | 22 |
| 그래프 구축 시간 | 0.2초 |
| 소비한 AI 토큰 | 0 |
맵과 노트 그룹
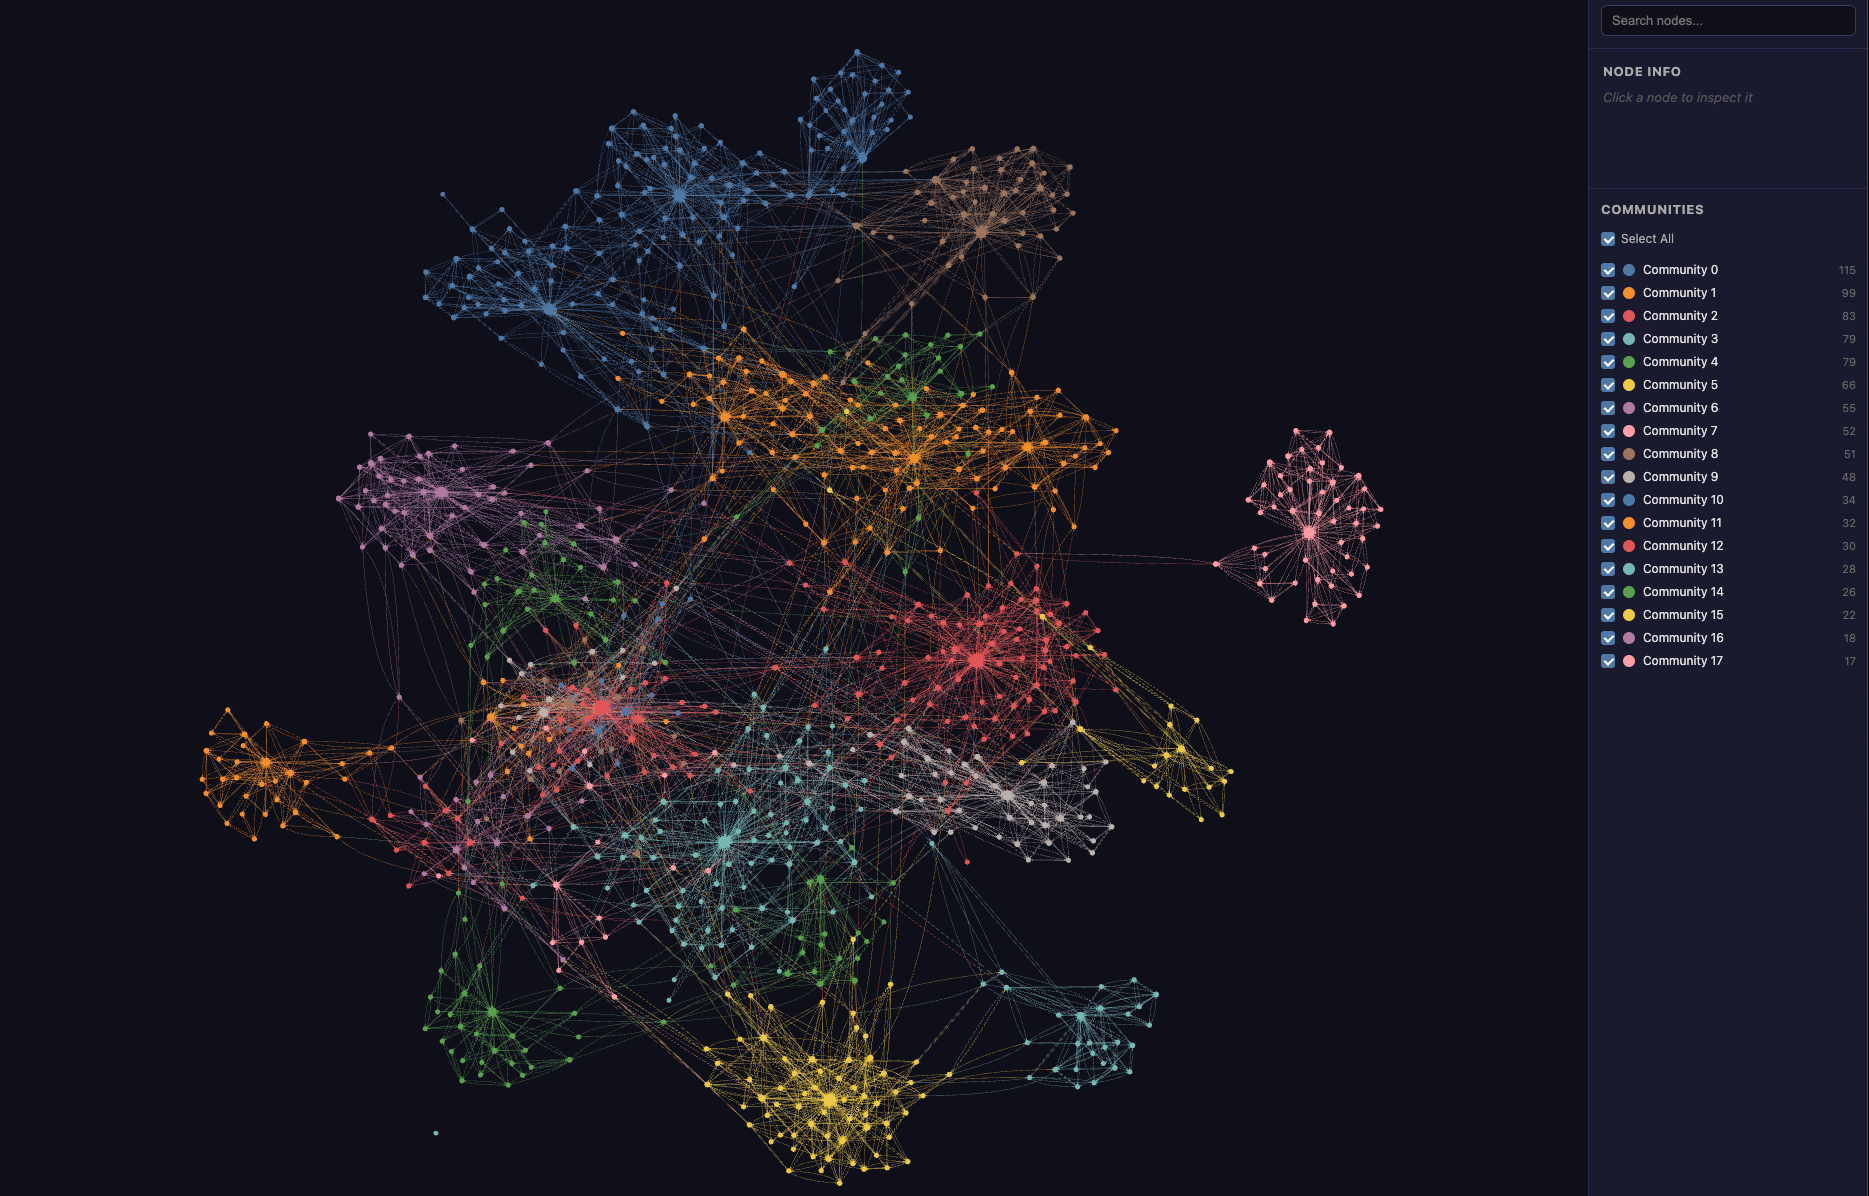
Graphify는 나머지 노트보다 자기들끼리 더 촘촘하게 링크된 노트들을 묶어 그래프를 여러 그룹으로 나눕니다. 마케팅 주제에서 찾아낸 그룹 몇 가지입니다.
- Mom Test를 중심으로 한 53개 노트 그룹: 고객과의 대화, 아무 가치 없는 칭찬, 약속보다 과거의 사실.
- 영향력에 관한 52개 노트 그룹: Cialdini의 여섯 가지 원칙, 상호성, 지각 대비, 복종을 끌어내는 "왜냐하면".
- chasm에 관한 46개 노트 그룹: 얼리어답터와 실용주의 다수 사이의 간극, 볼링 핀 전략.
- customer success에 관한 26개 노트 그룹: 죽음의 소용돌이로서의 churn, customer success와 고객 지원의 차이.
리포트는 가장 많이 연결된 노트도 짚어 줍니다. 상위 열 개는 모두 독서 맵입니다. Dunford의 Obviously Awesome 독서 맵이 링크 180개로 1위이고, Seth Godin의 This is Marketing이 링크 156개로 그 뒤를 잇습니다.
마지막으로 고립된 노트도 알려 줍니다. 1,013개 가운데 단 하나, 마케팅 페르소나에 관한 노트로, 나머지 어떤 노트와도 링크되어 있지 않습니다. 위키에 난 구멍을 공짜로 찾아낸 셈입니다.
노트 하나의 연결
Graphify에게 chasm에 관한 용어집 노트를 설명해 달라고 요청합니다.
graphify explain "GLO00618-chasm"
Graphify는 양방향으로 30개의 연결과 각 연결의 관계를 보여 줍니다. 일부를 옮기면 다음과 같습니다.
| 방향 | 링크된 노트 | 노트에 적힌 관계 |
|---|---|---|
| ← | Crossing the Chasm 독서 맵 | 모델의 핵심 간극 |
| → | 기술 수용 주기 | chasm이 놓인 틀 |
| → | 얼리어답터는 급진적인 우위를, 다수는 점진적인 개선을 찾는다 | chasm의 사이코그래픽(심리특성적) 원인을 설명한다 |
| ← | 완전 제품(whole product) | chasm은 부분적으로 완전 제품의 부재에서 비롯된다 |
| ← | Bowling alley | chasm을 건넌 뒤에 시작된다 |
| → | Moore의 간극은 얼리어답터와 대중 시장을 갈라놓는다 | 같은 아이디어, Moore를 인용한 Seth Godin에게서 나왔다 |
→: chasm 노트가 이 노트를 인용합니다. ←: 이 노트가 chasm 노트를 인용합니다.
가장 흥미로운 것은 마지막 줄입니다. chasm은 Geoffrey Moore에게서 나온 개념이지만, Seth Godin도 다른 책에서 이를 다룹니다. 그래프는 두 출처가 같은 아이디어에서 만난다는 것을 보여 줍니다.
멀리 떨어진 두 아이디어 사이의 경로
사회심리학 원칙인 Cialdini의 상호성 원칙과 구독 비즈니스의 churn을 잇는 것은 무엇일까요?
graphify path \
  "ATO01269-la-regle-de-reciprocite..." \
  "ATO01404-dans-un-business-de-revenus-recurrents-le-churn..."
Graphify는 8단계 경로를 찾아냅니다.
- 상호성 원칙은 보편적이며 인간 협력의 토대다
- → Influence(Cialdini) 독서 맵
- → 처음의 약속은 자기 이미지를 바꾸고 자동적인 일관성을 낳는다
- → 높은 위험이 신뢰를 만든다. 가격을 낮추면 신뢰가 줄어든다
- → 가까움: 높은 가격은 품질을 알리고 신뢰를 떠받친다 → 가격-품질 효과는 높은 가격을 품질의 신호로 받아들이게 한다
- → The Strategy and Tactics of Pricing(Nagle) 독서 맵
- → 전환 비용은 가격 민감도를 낮춘다 → 수렴: switching cost는 리텐션의 주요 지렛대다 → 리텐션은 가장 강력한 성장 승수다
- → Customer Success의 주장과 수렴: churn은 성장을 무너뜨린다 → 반복 매출 비즈니스에서 churn은 죽음의 소용돌이다
이 경로는 하나의 이야기를 들려줍니다. 약속의 심리학에서 신뢰의 신호로서의 가격으로, 다시 전환 비용에서 리텐션으로 이어집니다. 아무도 이 추론을 한 번에 써 내려가지 않았습니다. 노트 하나하나, 책 한 권 한 권 쌓아 온 링크에서 저절로 떠오른 것입니다.
Obsidian의 그래프 뷰보다 나은 점
Obsidian의 그래프 뷰는 링크를 그립니다. Graphify는 거기에 더해 다음을 합니다.
- 노트 그룹을 자동으로 감지합니다.
- 노트에 적힌 설명을 가져와 관계에 이름을 붙입니다.
- 두 노트 사이의 가장 짧은 경로를 찾습니다.
- 중심 노트, 고립된 노트, 예상하지 못한 연결을 담은 리포트를 만듭니다.
- 명령줄에서 쓸 수 있어서, Claude가 위키 작업을 하는 도중에 직접 질문할 수 있습니다.
한계
질문 검색은 제목만 읽습니다. Graphify에는 자유 검색 명령도 있습니다. 이 명령은 질문의 단어를 노트 내용이 아니라 노트 이름에서 찾고, 그다음 이웃 노트로 범위를 넓힙니다. 질문에 제목의 단어가 들어 있지 않으면 아무것도 찾지 못합니다.
그룹은 개념보다 책을 따라갑니다. 예를 들어 포지셔닝은 다섯 그룹으로 흩어지는데, 대체로 출처가 된 책에 따라 나뉩니다. 한쪽에는 Dunford, 다른 쪽에는 Ries와 Trout가 있는 식입니다. 책마다 만든 독서 맵에 링크가 너무 많이 몰려서 그래프 전체의 구조를 좌우합니다. 경로도 마찬가지입니다. chasm과 지불 의사 사이의 경로는 독서 맵 세 개를 거칩니다. 틀린 것은 아니지만 별로 배울 것이 없습니다.
그룹에는 이름이 없습니다. Graphify는 AI로 그룹에 이름을 붙일 수 있지만, 그러면 피하고 싶었던 비용을 다시 들여오게 됩니다. 그래서 그룹 이름은 "Community 0", "Community 1"… 이고, 해석은 제 몫입니다.
Graphify는 여전히 코드용 도구입니다. 구축할 때마다 경고를 12,884개 띄웁니다. 링크에 "소스 파일"이 없다는 경고인데, 이는 코드에서나 의미가 있는 개념입니다. 결과에는 아무 영향이 없지만, 도구를 원래 용도 밖에서 쓰고 있다는 사실을 상기시켜 줍니다.
그래프는 링크만큼만 가치가 있습니다. 설명 없는 링크는 아무 말 없는 "links" 관계가 됩니다. 제대로 링크되지 않은 노트는 고립된 채로 남습니다. 그래프는 아무것도 고쳐 주지 않습니다. 보여 줄 뿐입니다.
직접 재현하기
[[...]] 링크로 서로 이어진 Markdown 노트 모음이 필요합니다.
- 직접 링크를 거는 Obsidian 보관소일 수도 있고,
- 이 글에서 소개한 것처럼 AI가 관리하는 위키일 수도 있습니다.
위 스크립트는 ATO00001-slug 형태의 식별자와 주제별 폴더 구조를 전제로 합니다. 링크를 찾는 정규 표현식과 노트 폴더는 각자의 구성에 맞게 고쳐야 합니다.
그다음은 명령 세 개입니다.
pip install graphifyy

python build_graph.py --theme marketing --output _GRAPHITY/

graphify cluster-only _GRAPHITY/marketing/ --no-label \
  --graph _GRAPHITY/marketing/graph.json
인터랙티브 맵은 _GRAPHITY/marketing/graphify-out/graph.html에, 리포트는 그 옆의 GRAPH_REPORT.md에 생깁니다. explain과 path 명령은 graph.json 파일에서 바로 작동합니다.
AI가 추론할 것은 없었습니다. 이미 적어 둔 것을 읽기만 하면 됐습니다.