원문은 프랑스어입니다. AI로 번역했습니다 — 문체가 아니라 의미를 보존했습니다.
이 주제는 제 책 Le contexte에서 더 깊이 다룹니다. 읽으시려면 책을 내려받거나 Amazon에서 구매하실 수 있습니다.
이 글은 "보존해 줘: ChatGPT에서 정보를 꺼내 영구 저장소로 옮기기"에 이어지는 글입니다.
그 첫 번째 직접 만든 해법에서 저는 꽤 단순하지만 많은 것을 바꾸는 사실을 발견했습니다. ChatGPT가 Google Sheets에 정보를 쓸 수 있고, 따라서 그 정보를 자기 컨텍스트 창 밖으로 내보낼 수 있다는 것입니다.
다시 말해, ChatGPT에 지속되는 외부 메모리를 줄 수 있었습니다.
그때만 해도 Google Sheets는 사실상 정보를 내보내는 곳 역할을 했을 뿐입니다.
그러다 다른 질문이 떠올랐습니다.
이 같은 메커니즘만으로 제 Contexte 시스템을 ChatGPT 안에서 직접 돌릴 수 있지 않을까?
왜 Contexte를 Mac에서 꺼내고 싶었는가
저는 얼마 전부터 Codex와 Claude Code로 Contexte를 사용하고 있습니다.
제가 말하는 "Contexte"는 단순한 대화 기록이나 메모 몇 개를 넣어 두는 곳이 아닙니다.
제가 쓰는 정의는 훨씬 넓습니다.
Contexte는 사람의 미션으로 경계가 정해진 시스템입니다. 그 안에서 AI는 우리가 무엇을 알고 있는지, 그것을 어디서 알게 되었는지, 요소들이 서로 어떻게 연결되는지, 작업이 어디까지 진행되었는지를 정리하고 활용하여, 사람이 처음부터 다시 시작하지 않고 목표에 도달하도록 돕습니다. 그 과정에서 시스템은 지속적인 정보 자산을 쌓고 불려 나갑니다. 만들어진 지식은 계속 사용할 수 있고, 시간이 지날수록 풍부해지며, 다른 목적에도 다시 쓰일 수 있습니다.
저는 이미 Codex나 Claude Code로 이 원리를 작동시키는 엔진을 만들어 두었습니다.
Mac에서는 잘 돌아갑니다.
휴대폰에서도 방법을 하나 찾아 두었습니다. Mac에서 돌아가는 Codex에 원격으로 접속하는 것입니다.
하지만 이 방법에는 꽤 분명한 약점이 있습니다.
다음 조건이 모두 필요합니다.
- Mac이 켜져 있어야 합니다.
- 인터넷에 계속 연결되어 있어야 합니다.
- 원격 접속이 제대로 작동해야 합니다.
집에서는 별로 문제가 되지 않습니다.
현장에서는 훨씬 큰 문제가 됩니다.
제가 특히 신경 쓰던 것은 앞으로 있을 두 번의 업계 전시회였습니다. 휴대폰 하나만 들고 일주일 동안 다니면서 출품 업체들과 이야기를 나누고, 정보를 수집하고, 인터뷰를 준비하고, 경우에 따라서는 당일에 글까지 써야 했습니다.
수십, 수백 킬로미터 떨어진 어딘가에 켜 둔 Mac에 의존하고 싶지는 않았습니다.
그래서 Mac을 아예 방정식에서 빼 버릴 수 있을지 고민했습니다.
깨달음: ChatGPT에는 이미 거의 모든 것이 있었다
문제를 다른 각도에서 보니, Contexte 엔진에 필요한 것은 결국 세 가지 큰 요소라는 것을 알게 되었습니다.
- 정보를 두고 추론할 수 있는 엔진이 필요합니다.
- ChatGPT는 이미 그 일을 할 줄 압니다.
- 엔진에게 어떻게 일해야 하는지 알려 주는 규칙이 필요합니다.
- ChatGPT 프로젝트 지침이 그 역할을 할 수 있습니다.
- 마지막으로 대화가 끝나도 살아남는 메모리가 필요합니다.
- 바로 이것이 빠진 조각이었습니다.
그러니 제 아키텍처는 이렇게 바뀔 수 있었습니다.
엔진     → ChatGPT
지침     → ChatGPT 프로젝트
보존     → Google Sheets
이전 글의 보존 해법이 바로 그 세 번째 요소를 제공했습니다.
그때부터 Contexte 엔진을 ChatGPT로 이식하는 일이 훨씬 현실적으로 느껴졌습니다.
ChatGPT 주변에 완전한 시스템을 새로 만들 필요는 없었습니다.
AI 엔진은 이미 거기 있었습니다.
필요한 것은 무엇보다 규칙, 그리고 엔진이 읽고 고칠 수 있는 외부 메모리였습니다.
엔진을 ChatGPT로 이식한 방법
처음에는 엔진의 모든 규칙을 프로젝트 지침에 바로 넣으려고 했습니다.
오래가지 못했습니다.
프로젝트 지침은 약 8,000자로 제한되는데, 제 엔진에는 이미 그보다 훨씬 많은 분량이 필요했습니다.
그래서 규칙을 두 단계로 나누었습니다.
첫 번째 단계는 CORE입니다.
ChatGPT 프로젝트 지침에 직접 넣는 부분입니다.
엔진이 작동하는 데 꼭 필요한 요소만 담습니다.
- Contexte란 무엇인가
- 어디에 저장되는가
- 어떤 명령이 있는가
- Contexte를 어떻게 여는가
- 소스를 어떻게 보존하는가
- 파일 구조
- 주요 불변 조건
- 지침 간의 위계
두 번째 단계는 확장 지침입니다.
분량이 훨씬 많고, Google Doc에 들어 있습니다.
예를 들어 다음 내용을 담습니다.
- 인제스트의 상세한 방법
- 원자적 지식을 만드는 기준
- state와 synthesis 관리
- 결정 사항
- 모순
- todo
- 읽기 전략
- 산출물 작성 규칙
- 오류와 예외 상황 처리
위계는 이렇게 됩니다.
CORE
  ↓
확장 지침
  ↓
Contexte별 지침
CORE는 확장 지침이 어디 있는지 알고 있으며, 새 대화가 시작될 때 ChatGPT에게 그것을 불러오라고 지시합니다.
그러니 이 분리는 시스템을 더 우아하게 만들기 위한 것만은 아닙니다.
무엇보다 아주 구체적인 제약에 대한 답입니다. 엔진 전체가 ChatGPT 프로젝트 지침 안에 들어가지 않는다는 제약입니다.
Google Sheets가 Contexte의 메모리가 되다
그다음에는 Contexte 자체를 어떻게 표현할지가 남아 있었습니다.
Google Docs 여러 개를 쓸 수도 있었습니다.
- 소스용 문서 하나.
- 상태용 문서 하나.
- 지식용 문서 하나.
- 작업용 문서 하나.
- ...
하지만 금세 찾아야 할 파일이 잔뜩 생기고, 관리해야 할 ID도 그만큼 늘어났을 것입니다(이 기술적 제약은 뒤에서 다시 다룹니다).
Google Sheets가 훨씬 실용적이었습니다.
Contexte 하나가 Spreadsheet 하나에 대응합니다.
Spreadsheet 안에서는 정보 유형마다 탭이 하나씩 있습니다.
현재 쓰는 구조는 다음과 같습니다.
00-FRAME
01-STATE
03-SESSIONS
04-ATOMIC
05-OUTPUTS
00-FRAME에는 특히 미션과, 있다면 Contexte별 지침이 들어 있습니다.
01-STATE에는 작업이 어디까지 왔는지 파악하는 데 필요한 정보가 들어 있습니다.
- state
- synthesis
- todo
- 결정 사항
- 모순
- handoff
03-SESSIONS에는 보존된 원본 소스가 들어 있습니다.
04-ATOMIC에는 안정화된 지식이 들어 있습니다.
05-OUTPUTS에는 Contexte를 바탕으로 만든 산출물이 들어 있습니다.
이제 Google Sheets는 ChatGPT가 정보를 저장해 두려고 쓰는 곳에 그치지 않습니다.
Spreadsheet가 Contexte의 완전한 구조화된 메모리가 됩니다.
절대 전부 다시 불러오지 않기
그렇다고 ChatGPT가 대화마다 Spreadsheet 전체를 불러온다는 뜻은 아닙니다.
그건 아마 매우 나쁜 생각일 것입니다.
제가 이렇게 쓰면,
열기 내 Contexte
ChatGPT는 먼저 해당 Spreadsheet를 찾습니다.
그런 다음 핵심 세트만 불러옵니다.
- 미션
- 지침
- state
- synthesis
- todo
- 결정 사항
- 모순
- handoff
소스, 원자적 지식, 이전 출력물은 Sheet 안에 그대로 남습니다.
ChatGPT는 필요해질 때에만 그것들을 가지러 갑니다.
이것은 제가 시스템을 설계하는 방식에서 중요한 부분입니다.
메모리는 이런 식으로 작동하지 않습니다.
대화할 때마다 내가 아는 모든 것을 프롬프트에 다시 넣는다.
오히려 이렇게 작동합니다.
나에게는 외부 메모리가 있고, 필요한 정보가 쓸모 있어지는 순간 그곳에서 찾아올 수 있다.
Contexte는 주소로 찾아갈 수 있는 외부 메모리가 됩니다.
엄청난 시간을 잡아먹던 세부 사항
첫 버전에서는 Google ID를 찾아내는 과정을 아직 최적화하지 않았습니다.
ChatGPT가 Contexte를 읽거나 쓰려고 할 때마다 해당 Spreadsheet를 검색한 뒤 그 ID를 다시 찾아야 했습니다.
그리고 다음 작업에서 또 처음부터 반복했습니다.
작동은 했지만, 어떤 작업은 50초 가까이 걸리기도 했습니다.
시간의 상당 부분이 불과 몇 초 전에 이미 찾은 것을 다시 찾는 데 쓰이고 있었습니다.
그래서 아주 간단한 규칙을 하나 추가했습니다.
Contexte를 연 다음에는 ChatGPT가 대화 내내 다음을 유지합니다.
Contexte 이름
→ Spreadsheet
→ Spreadsheet ID
이후의 모든 작업은 이 ID를 바로 사용합니다.
ID를 다시 찾는 것은 다음 경우뿐입니다.
- Contexte를 바꿀 때
- ID를 더 이상 쓸 수 없을 때
- 접근에 실패할 때
꽤 당연해 보입니다.
하지만 시스템의 매끄러움이 완전히 달라집니다.
보존은 학습이 아니다
엔진 자체가 제공하는 명령은 결국 아주 적습니다.
열기 <contexte>
보존 <내용>
Todo <할 일>
인제스트
저장
열기는 Contexte를 불러옵니다.
보존은 새 소스를 보관합니다.
Todo는 해야 할 일을 추가합니다.
인제스트는 새 소스를 분석하고 구조화된 지식을 갱신합니다(노트를 새로 만들거나 보강합니다).
저장은 다음 대화에서 미션을 제대로 이어 갈 수 있도록 필요한 요소를 갱신합니다.
하지만 이 시스템에서 가장 중요한 구분은 아마 이것일 겁니다.
보존은 인제스트가 아닙니다.
제가 이렇게 말할 때,
보존 ...
방금 한 말을 사실로 받아들이라고 엔진에게 요구하는 것이 아닙니다.
제가 요구하는 것은 오직 이것뿐입니다.
이 자료를 보관해 둬.
그 자료는 소스가 됩니다.
인제스트할 때 엔진은 그 안의 내용이 다음 중 무엇에 해당하는지 판단할 수 있습니다.
- 실제로 확정된 결정
- 작업
- 모순
- 현재 상태에 유용한 정보
- 원자적 노트가 될 만큼 충분히 안정된 지식
- 혹은 더 나아가지 않고 소스로만 보관해 두면 되는 것
이렇게 하면 AI 메모리 시스템에서 특히 위험하다고 생각하는 한 가지 일탈을 막을 수 있습니다.
AI가 만든 모든 산출물이 자동으로 시스템의 지식이 되어 버리면, AI는 결국 자기가 이전에 만든 산출물을 증거로 쓸 수 있게 됩니다.
그래서 저는 엄격한 분리를 유지하려고 합니다.
소스 ≠ 지식 ≠ 상태 ≠ 종합 ≠ 산출물
소스는 이렇게 말합니다.
이런 말이 있었다, 혹은 이런 것이 관찰되었다.
안정된 지식은 다른 말을 합니다.
이것은 이제 시스템이 충분히 확립되었고 다시 쓸 수 있다고 보는 내용이다.
주머니 속의 Contexte
이 이식이 제게 정말 흥미로워지는 것은 휴대폰에서입니다.
저는 이미 음성 받아쓰기로 아주 많은 일을 합니다.
그리고 이 경우에는 시스템을 대하는 방식이 완전히 달라집니다.
다시 업계 전시회를 예로 들어 보겠습니다.
저는 미리 준비해 둔 Contexte를 가지고 도착합니다.
휴대폰에서,
열기 Salon-X
첫 번째 출품 업체와 이야기를 나눕니다.
부스를 나서면서 굳이 멈춰 서서 메모 앱을 열고 작은 키보드로 5분 동안 타이핑하고 싶지는 않습니다.
다음 부스로 걸어가면서 방금 알게 된 내용을 ChatGPT에 그냥 받아쓰게 합니다.
그리고,
보존 <방금 받아쓴 내용>
수십 초 정도 걸릴 수 있습니다.
저는 하루를 계속 이어 갑니다.
몇 번의 대화를 마친 뒤,
인제스트
그러면 엔진이 제가 수집한 내용을 구조화하기 시작합니다.
여기서부터 사용 방식이 단순한 메모 시스템보다 더 흥미로워집니다.
ChatGPT에 이렇게 물어볼 수 있습니다.
이 주제를 제대로 이해하려면 아직 무엇이 부족한가?
또는,
다음 출품 업체에게 어떤 모순을 확인해야 할까?
또는,
아직 아무에게도 하지 않은 중요한 질문은 무엇인가?
이 답을 아직 전시회장에 있는 동안 얻을 수 있습니다.
그러니 빠진 질문을 바로 하러 갈 수 있습니다.
순환은 이렇게 됩니다.
대화
   ↓
걸으면서 음성 받아쓰기
   ↓
보존
   ↓
인제스트
   ↓
사각지대 찾기
   ↓
다시 가서 질문하기
   ↓
Contexte 보완
아마 이것이 제 사용 방식을 가장 크게 바꾸는 부분일 것입니다.
AI는 더 이상 수집이 끝난 뒤에 무언가를 만들어 내도록 돕는 데에만 개입하지 않습니다.
수집하는 동안, 아직 정보의 질을 높일 수 있을 때 개입할 수 있습니다.
Plaud: 대화를 Contexte 안으로 들여오기
저는 Plaud Note Pro도 사용합니다.
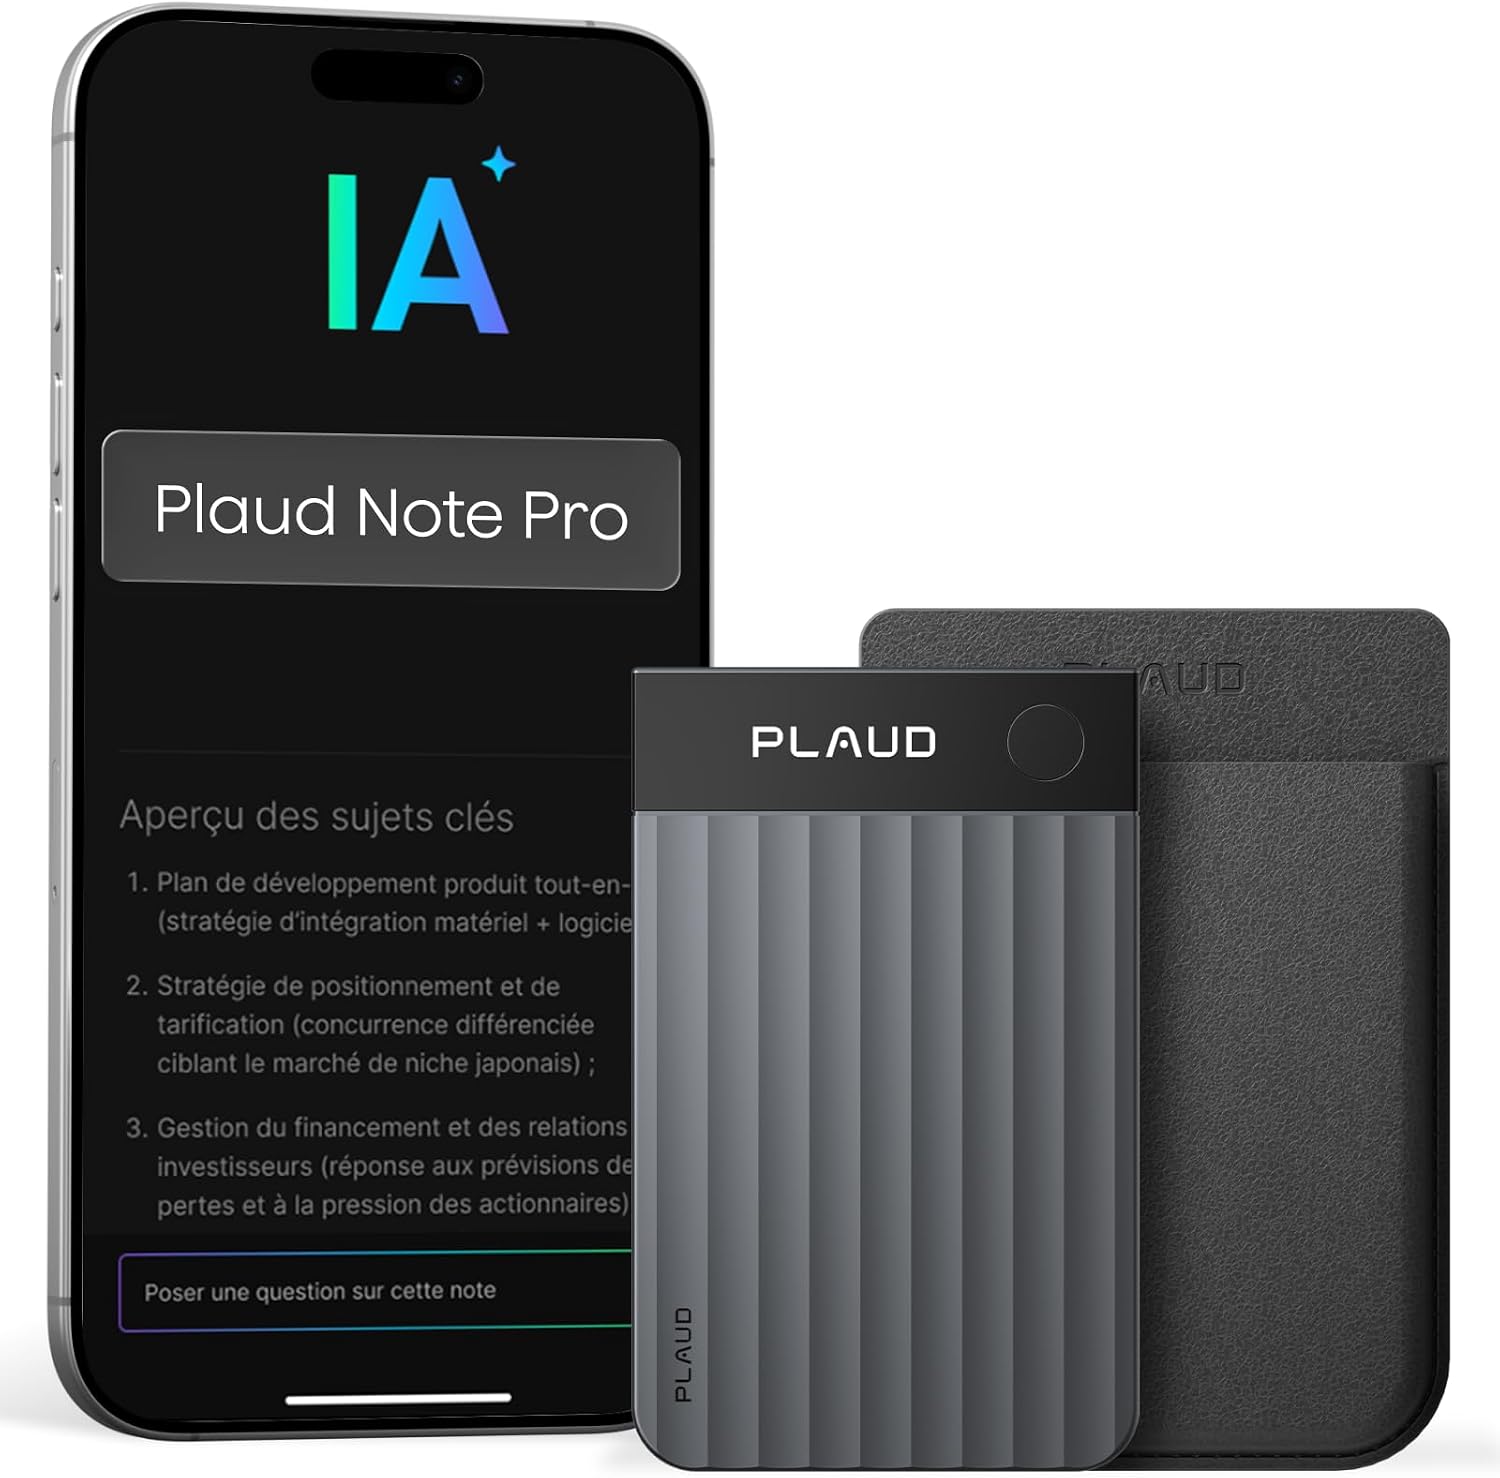
현장에서 대화와 인터뷰를 녹음할 때 쓸 수 있는 제 Plaud Note Pro입니다.
Plaud Note Pro는 회의, 대화, 인터뷰를 녹음할 수 있는 작은 음성 녹음기입니다.
녹음은 이후 Plaud에서 확인할 수 있고, 전사할 수 있습니다.
하지만 제 시스템에서 가장 관심 있는 것은 Plaud가 자동으로 만들어 주는 요약이 아닙니다.
제가 가져오고 싶은 것은 전체 전사본입니다.
그리고 중요한 조각이 하나 더 있습니다. ChatGPT는 커넥터를 통해 Plaud에 직접 접근할 수 있습니다.
그래서 ChatGPT에서 예를 들어 이렇게 요청할 수 있습니다.
내 최근 Plaud 녹음 세 개를 나열하고, 각각 무엇에 관한 것인지 한 줄로 알려 줘.
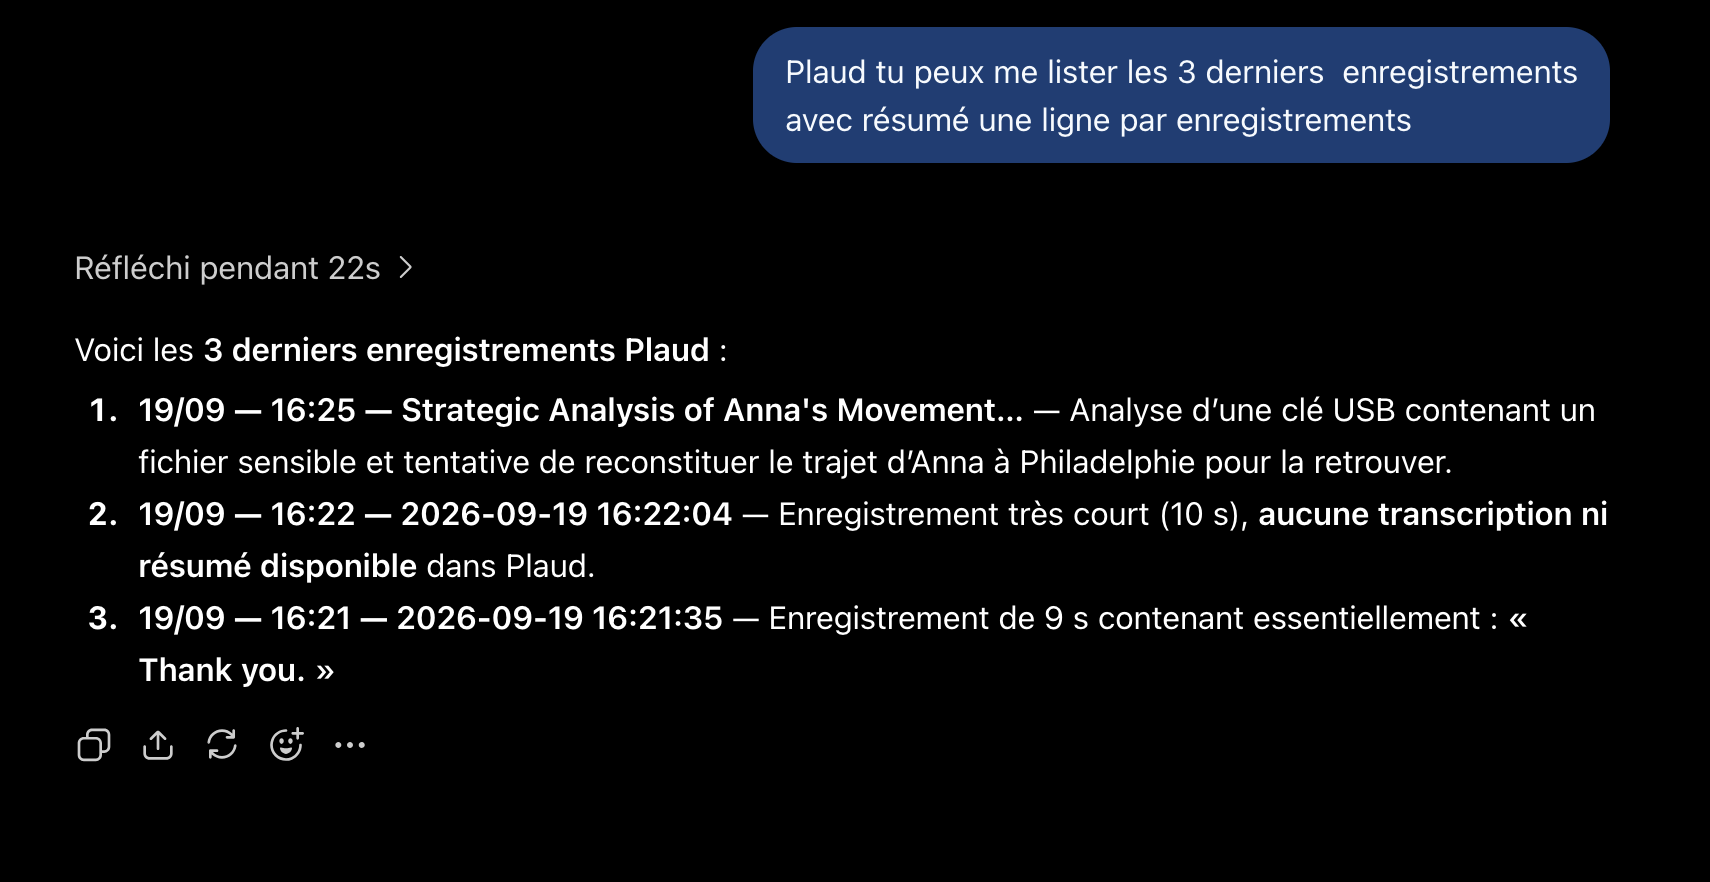
ChatGPT에서 Plaud에 질의해 최근 녹음을 찾는 예시입니다.
ChatGPT는 이 녹음들을 찾은 뒤 전사본을 바로 가져올 수 있습니다.
덕분에 훨씬 직접적인 워크플로를 그려 볼 수 있습니다.
실제 대화
        ↓
Plaud
        ↓
전사
        ↓
ChatGPT가 전사본을 직접 가져옴
        ↓
보존
        ↓
Contexte의 원본 소스
        ↓
인제스트
그래서 다음과 같은 일을 할 필요가 없습니다.
- 파일을 수동으로 내려받기
- 전사본 열기
- 복사하기
- ChatGPT로 돌아가기
- 붙여 넣기
이 모든 것을 휴대폰에서 음성으로, 자동으로 할 수 있습니다.
그리고 저는 단순한 요약보다 전체 원본 전사본을 Contexte에 넣는 쪽을 선호합니다.
요약은 이미 하나의 해석입니다.
전사본은 원래 자료에 훨씬 가깝게 남아 있습니다.
대화가 Contexte에 들어오면 이렇게 물어볼 수 있습니다.
- 이 사람이 방금 실제로 나에게 알려 준 것은 무엇인가?
- 이전 대화들과 모순되는 것은 무엇인가?
- 어떤 주장을 확인해 볼 필요가 있는가?
- 다음 사람에게는 어떤 질문을 해야 하는가?
필요한 요소들은 이미 각각 작동합니다.
다만 Plaud → ChatGPT → Contexte로 이어지는 이 워크플로를 긴 현장 일정 속에서 처음부터 끝까지 충분히 시험해 보지는 못했기 때문에, 완전히 매끄럽다고 말할 수는 없습니다.
그러니 아직 더 시험해 봐야 할 사용 방식입니다.
시스템을 재현하는 방법
엔진의 두 가지 지침 단계에 해당하는 파일 두 개를 준비해 두었습니다.
CORE
CORE는 여기에서 볼 수 있습니다.
이 부분을 ChatGPT 프로젝트 지침에 복사해야 합니다.
확장 지침
상세 지침은 여기에서 볼 수 있습니다.
이 지침은 ChatGPT가 접근할 수 있는 Google Doc에 복사해 두어야 합니다.
시작하기 전에 당연히 Google Drive를 ChatGPT에 연결하고, 엔진이 사용하는 문서에 접근할 수 있도록 허용해야 합니다.
ID 설정하기
CORE에는 특히 두 개의 ID가 들어 있습니다.
DOCUMENT_ID = xxxx
FOLDER_ID = xxxx
DOCUMENT_ID는 확장 지침이 들어 있는 Google Doc입니다.
다음과 같은 URL에서,
https://docs.google.com/document/d/xxxx/edit
xxxx 부분이 문서 ID입니다.
FOLDER_ID는 Contexte가 저장될 Google Drive 폴더입니다.
다음과 같은 URL이라면,
https://drive.google.com/drive/folders/xxxx
이번에도 xxxx 부분이 ID입니다.
각 사용자는 당연히 이 값들을 자기 환경의 값으로 바꿔야 합니다.
Contexte마다 Spreadsheet 하나
새 Contexte가 만들어지면 엔진은 다음을 담은 Spreadsheet를 만듭니다.
00-FRAME
01-STATE
03-SESSIONS
04-ATOMIC
05-OUTPUTS
그런 다음 그 Spreadsheet를 FOLDER_ID로 지정한 폴더에 넣습니다.
이 Spreadsheet 각각의 ID를 지침에 일일이 손으로 옮겨 적을 필요는 없습니다.
제가 이렇게 요청하면,
열기 내 Contexte
ChatGPT는 Contexte 폴더에서 해당 Spreadsheet를 찾아 ID를 가져온 뒤, 대화 내내 그 ID를 유지합니다.
이제 시스템을 쓸 준비가 끝났습니다.
이 직접 만든 해법으로 할 수 있는 것, 그리고 그 한계
이 ChatGPT 버전이 Codex나 Claude Code와 함께 쓰는 제 엔진을 대체하지는 않습니다.
애초에 그게 목표도 아니었습니다.
한계도 여럿 있습니다.
더 느립니다.
Python 스크립트, API 호출, 더 풍부한 실행 환경이 직접 필요한 Contexte에는 덜 적합합니다.
그리고 무엇보다, Contexte가 몇 주에 걸쳐 실제로 커졌을 때 어떻게 동작하는지 아직 충분히 지켜보지 못했습니다.
그래서 저는 이것을 보완적인 독립 모드로 봅니다.
Mac에서는 Codex나 Claude Code가 여전히 어떤 미션에는 더 적합합니다.
하지만 이제 휴대폰에서는 Mac이 켜져 있고 접속 가능한지에 기대지 않고 Contexte를 쓸 수 있습니다.
그리고 그것이 바로 제가 풀고 싶었던 문제였습니다.
Codex 사용량 한도와 관련해 재미있는 관찰도 하나 있습니다.
ChatGPT 안에서 이 실험을 하는 동안, 화면에 표시된 Codex 잔여 사용량은 전혀 줄지 않았습니다.
관찰된 사용량:
0
물론 이것이 OpenAI가 이런 사용을 청구하거나 집계하는 방식에 관한 일반 규칙이라고 주장하려는 것은 아닙니다.
다만 이 실험 동안에는 이 직접 만든 해법이 제 Codex 사용량을 소모하지 않았다는 사실을 확인했을 뿐입니다.
이 시스템은 이미 이 글을 쓰는 데 쓰였다
처음에 Google Sheets로 만든 첫 번째 해법은 꽤 제한된 질문에 답하는 것이었습니다.
ChatGPT에서 정보를 꺼내 오래 보관하려면 어떻게 해야 할까?
며칠 뒤, 질문은 이렇게 바뀌었습니다.
Contexte의 구조화된 메모리 전체를 밖으로 꺼내면 어떨까?
결국 이 시스템이 하는 일이 바로 그것입니다.
ChatGPT는 더 이상 "모든 것을 기억"할 필요가 없습니다.
무엇보다 다음을 알면 됩니다.
- 어디를 찾아야 하는지
- 무엇을 불러와야 하는지
- 무엇을 보존해야 하는지
- 정보를 어떻게 분류하고 평가해야 하는지
- 이미 배운 것을 어떻게 다시 찾는지
- 작업이 어디까지 왔는지
공식은 꽤 단순합니다.
ChatGPT가 추론합니다.
지침이 엔진을 정의합니다.
Google Sheets가 기억합니다.
그리고 이 글을 준비하고 쓰는 과정 자체가 이 글이 설명하는 시스템을 시험하는 데 쓰였다는 점에는 꽤 만족스러운 데가 있습니다.
이 글을 준비하면서 저는 ChatGPT 안의 이 Contexte만 사용했습니다.
그 안에 제 생각을 보존했습니다.
그 생각들을 인제스트했습니다.
함께 사각지대를 찾아냈습니다.
표현을 다듬었습니다.
작업을 만들고 끝냈습니다.
빠진 요소를 보탰습니다.
그런 다음 글의 첫 버전을 쓰고, 다시 읽고, 같은 Contexte를 사용해 이 V2를 준비했습니다.
다시 말해, 이 시스템은 기술 시연용으로만 쓰인 것이 아닙니다.
제가 이 시스템을 만든 목적인 바로 그 실제 작업에 이미 쓰였습니다.
그러니 질문은 더 이상 이것이 아닙니다.
이게 작동하는가?
작동합니다.
이제 제가 궁금한 질문은 오히려 이것입니다.
같은 Contexte를 업계 전시회가 이어지는 일주일 내내 현장에서 시험했을 때도 이 아키텍처가 지금처럼 실용적일까?
그것은 앞으로 실제로 써 보면서 확인하게 될 것입니다.