原文はフランス語です。AI により翻訳されました — 文体ではなく意味を保っています。
この記事は「Persiste ça:ChatGPTの情報を恒久的な保存先へ書き出す」の続きです。
その最初の手づくりの仕組みで、私はかなり単純な、けれども多くのことを変える事実に気づきました。ChatGPTはGoogle Sheetsに情報を書き込める。つまり、情報を自分自身のコンテキストウィンドウの外に出せるのです。
言い換えれば、ChatGPTに永続的な外部メモリを持たせられるということです。
その時点では、Google Sheetsは主に書き出し先の箱として使っていました。
そこで、別の問いが浮かびました。
この同じ仕組みだけで、私のContexteのシステムをChatGPTの中で直接動かせるのではないか。
なぜContexteをMacから切り離したかったのか
少し前から、私はCodexやClaude CodeでContexteを使っています。
ここで「Contexte」と言うとき、単なる会話履歴や、ちょっとしたメモを置いておく場所のことを言っているのではありません。
私が使っている定義はもっと広いものです。
Contexteとは、人間のミッションによって範囲を区切られたシステムです。その中でAIが、何がわかっているのか、それがどこからわかったのか、要素同士がどうつながっているのか、仕事がどこまで進んでいるのかを整理して動員し、人間がゼロからやり直すことなく目的を達成できるよう手助けします。その過程でシステムは、持続する情報資産を築き、育てていきます。生み出された知識は使える状態で残り、時間とともに豊かになり、ほかの目的にも再利用できます。
この原則をCodexやClaude Codeで動かすためのエンジンは、すでにつくってありました。
Macの上では、うまく動いています。
スマートフォンからも使えるよう、解決策を一つ見つけていました。Mac上で動いているCodexに遠隔からアクセスする方法です。
けれども、この方法にはかなりはっきりした弱点があります。
次の条件がそろっていなければなりません。
- Macの電源が入っていること
- Macがインターネットにつながったままであること
- 遠隔アクセスが機能していること
自宅にいるなら、たいした問題ではありません。
現場では、大きな問題になります。
私が特に気にしていたのは、近く控えていた二つの業界展示会でした。スマートフォンだけを持って一週間出かけ、出展者と話し、情報を収集し、インタビューを準備し、場合によってはその日のうちに記事を書く、という場面です。
何十キロ、何百キロも離れたどこかで電源の入ったMacに頼るのは避けたいと思いました。
そこで、Macを完全に不要にできないかと考えたのです。
きっかけ:ChatGPTにはほとんどすべてがそろっていた
問題を別の角度から眺めてみると、Contexteのエンジンに必要なのは、結局のところ三つの大きな部品だとわかりました。
- 情報について推論できるエンジンが必要です。
- ChatGPTはすでにそれができます。
- エンジンに仕事の進め方を教えるルールが必要です。
- ChatGPTのプロジェクトの指示がその役割を果たせます。
- そして最後に、会話が終わっても残るメモリが必要です。
- これが欠けていた部品でした。
つまり、私のアーキテクチャは次のようにできます。
エンジン   → ChatGPT
指示       → ChatGPTのプロジェクト
永続化     → Google Sheets
前回の記事で紹介した永続化のハックが、ちょうどこの三つ目の部品を提供してくれました。
そこから先、ContexteのエンジンをChatGPTに移植する作業は、ずっと身近なものになりました。
ChatGPTのまわりに完全なシステムを一からつくり直す必要はありませんでした。
AIのエンジンはすでにそこにあったのです。
必要なのは主に、エンジンにルールを与えることと、読み書きできる外部メモリを与えることでした。
エンジンをChatGPTにどう移植したか
最初は、エンジンのルールをすべてプロジェクトの指示に直接入れようとしました。
これは長くは持ちませんでした。
プロジェクトの指示には約8,000文字という上限があり、私のエンジンはすでにそれよりはるかに多くの分量を必要としていたのです。
そこで、ルールを二つの層に分けました。
一つ目の層がCOREです。
これはChatGPTのプロジェクトの指示に直接置く部分です。
エンジンが動くために絶対に欠かせない要素が入っています。
- Contexteとは何か
- どこに保存されているか
- どんなコマンドがあるか
- Contexteをどう開くか
- ソースをどう永続化するか
- ファイルの構造
- 主な不変条件
- 指示の階層
二つ目の層が拡張指示です。
こちらははるかに分量が多く、Google Docに置いてあります。
たとえば、次のようなものが入っています。
- インジェストの詳しい方法
- アトミックな知識をつくるための基準
- stateとsynthesisの管理
- 決定
- 矛盾
- todo
- 読み込みの戦略
- 成果物をつくるときのルール
- エラーや境界ケースの扱い
階層は次のようになります。
CORE
  ↓
拡張指示
  ↓
Contexte固有の指示
COREは拡張指示がどこにあるかを知っていて、新しい会話の最初にそれをロードするようChatGPTに指示します。
つまり、この分割はシステムを美しくするためだけのものではありません。
何よりも、とても具体的な制約に応えるためのものです。エンジン全体はChatGPTのプロジェクトの指示に収まらないのです。
Google SheetsがContexteのメモリになる
次に残ったのは、Contexteそのものをどう表現するかでした。
複数のGoogle Docを使うこともできたはずです。
- ソース用のドキュメント。
- 状態用のドキュメント。
- 知識用のドキュメント。
- タスク用のドキュメント。
- ...
けれども、それではすぐに探し出さなければならないファイルが大量に生まれ、同じ数だけ識別子を管理することになります(この技術的な制約については後で触れます)。
Google Sheetsのほうがはるかに便利だとわかりました。
一つのContexteが一つのSpreadsheetに対応します。
Spreadsheetの中では、情報の種類ごとにタブがあります。
現在は次の構造を使っています。
00-FRAME
01-STATE
03-SESSIONS
04-ATOMIC
05-OUTPUTS
00-FRAMEには、主にミッションと、必要に応じてContexte固有の指示が入ります。
01-STATEには、仕事がどこまで進んでいるかを知るために必要な情報が入ります。
- state
- synthesis
- todo
- 決定
- 矛盾
- handoff
03-SESSIONSには、永続化された生のソースが入ります。
04-ATOMICには、安定した知識が入ります。
05-OUTPUTSには、Contexteをもとにつくられた成果物が入ります。
つまりGoogle Sheetsは、ChatGPTが情報を保存するために書き込む場所というだけではなくなりました。
SpreadsheetがContexteの構造化されたメモリのすべてになるのです。
すべてをロードし直すのは絶対に避ける
だからといって、ChatGPTが会話のたびにSpreadsheet全体をロードするわけではありません。
それはおそらく、とても悪い考えです。
私が次のように書くと、
開く 私のContexte
ChatGPTはまず、対応するSpreadsheetを探し出します。
そして、その中核部分だけをロードします。
- ミッション
- 指示
- state
- synthesis
- todo
- 決定
- 矛盾
- handoff
ソース、アトミックな知識、過去のoutputsはSheetの中に残しておきます。
ChatGPTがそれらを取りに行くのは、必要になったときだけです。
これは、私がこのシステムをどう設計しているかという点で重要なところです。
メモリは次のようには働きません。
知っていることを、会話のたびにすべてプロンプトに入れ直す。
むしろ、次のように働きます。
外部メモリを持っていて、役に立つ瞬間が来たら、そこから関連する情報を取りに行ける。
Contexteはアドレス可能な外部メモリになるのです。
膨大な時間を奪っていた細部
最初のバージョンでは、Googleの識別子の解決をまだ最適化していませんでした。
ChatGPTはContexteを読んだり書いたりするたびに、対応するSpreadsheetを検索し、そのIDを探し直さなければなりませんでした。
そして次の操作でも、また同じことを繰り返していました。
それでも動きはしましたが、操作によっては50秒近くかかることもありました。
その時間のかなりの部分は、ほんの数秒前に見つけたばかりのものを探し直すことに費やされていたのです。
そこで、とても単純なルールを一つ加えました。
Contexteを開いたら、ChatGPTは会話のあいだ次の情報を保持します。
Contexteの名前
→ Spreadsheet
→ SpreadsheetのID
その後の操作はすべて、このIDを直接使います。
IDを解決し直すのは、次の場合だけです。
- 別のContexteに切り替えたとき
- IDが使えなくなったとき
- アクセスに失敗したとき
当たり前に見えるかもしれません。
けれども、システムの軽快さはこれで大きく変わります。
永続化は学習ではない
エンジン自体が提供するコマンドは、結局ごくわずかです。
開く <contexte>
永続化 <内容>
Todo <アクション>
インジェスト
保存
開くはContexteをロードします。
永続化は新しいソースを保持します。
Todoは実行すべきアクションを追加します。
インジェストは新しいソースを分析し、構造化された知識を更新します(ノートの作成や拡充)。
保存は、次の会話でミッションを正しく再開するための要素を最新の状態にします。
けれども、このシステムでいちばん重要な区別は、おそらく次のものです。
永続化はインジェストではありません。
私が次のように言うとき、
永続化 ...
いま言ったことを真実とみなすよう、エンジンに求めているわけではありません。
求めているのは、これだけです。
この素材を保持しておいて。
その素材はソースになります。
インジェストの段階で、エンジンはその中身が次のどれにあたるかを判断できます。
- 実際に確定した決定
- タスク
- 矛盾
- 現在の状態に役立つ情報
- アトミックなノートにできるほど安定した知識
- あるいは、それ以上は踏み込まずにソースとして保持しておけばよいもの
こうすることで、AI向けのメモリシステムで特に危険だと私が考えている逸脱を避けられます。
AIが生み出したものがすべて自動的にシステムの知識になってしまうと、AIはいずれ、自分が以前に生み出したものを証拠として使えるようになってしまいます。
だから私は、厳密な区別を保つようにしています。
ソース ≠ 知識 ≠ 状態 ≠ 統合 ≠ 成果物
ソースが語るのは、
これが、言われたこと、あるいは観察されたことです。
安定した知識が語るのは別のことです。
これが、システムがいまや十分に確立され、再利用できるとみなしているものです。
ポケットの中のContexte
この移植が私にとって本当に面白くなるのは、スマートフォンの上です。
私はもともと、音声入力でかなりの仕事をしています。
そしてこの場面では、システムとの付き合い方がまったく変わります。
もう一度、業界展示会の例で考えてみましょう。
私は、あらかじめ準備したContexteを持って会場に着きます。
スマートフォンから、
開く 展示会-X
一人目の出展者と話します。
ブースを離れるとき、立ち止まってメモアプリを開き、小さなキーボードで五分間も入力したいとは限りません。
次のブースへ歩きながら、いま知ったことをChatGPTに音声で吹き込むだけです。
それから、
永続化 <いま吹き込んだ内容>
これには数十秒かかることもあります。
私はそのまま一日を続けます。
何人かと話したあとで、
インジェスト
するとエンジンが、私の収集したものを構造化し始めます。
ここからが、単なるメモ取りのシステムよりも面白くなるところです。
ChatGPTにこう尋ねることができます。
このテーマを本当に理解するために、まだ何が足りていませんか。
あるいは、
次の出展者に確認すべき矛盾はどれですか。
さらには、
まだ誰にも聞いていない重要な質問は何ですか。
この答えを、まだ展示会の会場にいるうちに得られるのです。
その場で、足りない質問をすぐに聞きに行けます。
サイクルは次のようになります。
会話
   ↓
歩きながらの音声入力
   ↓
永続化
   ↓
インジェスト
   ↓
死角を探す
   ↓
質問をしに戻る
   ↓
Contexteを補う
私の使い方をいちばん大きく変えるのは、おそらくこの点です。
AIが出てくるのは、もはや収集のあとに何かをつくる手伝いをするときだけではありません。
収集のさなかに、まだ情報の質を高められるうちに、AIが関われるのです。
Plaud:会話をContexteに取り込む
私はPlaud Note Proも使っています。
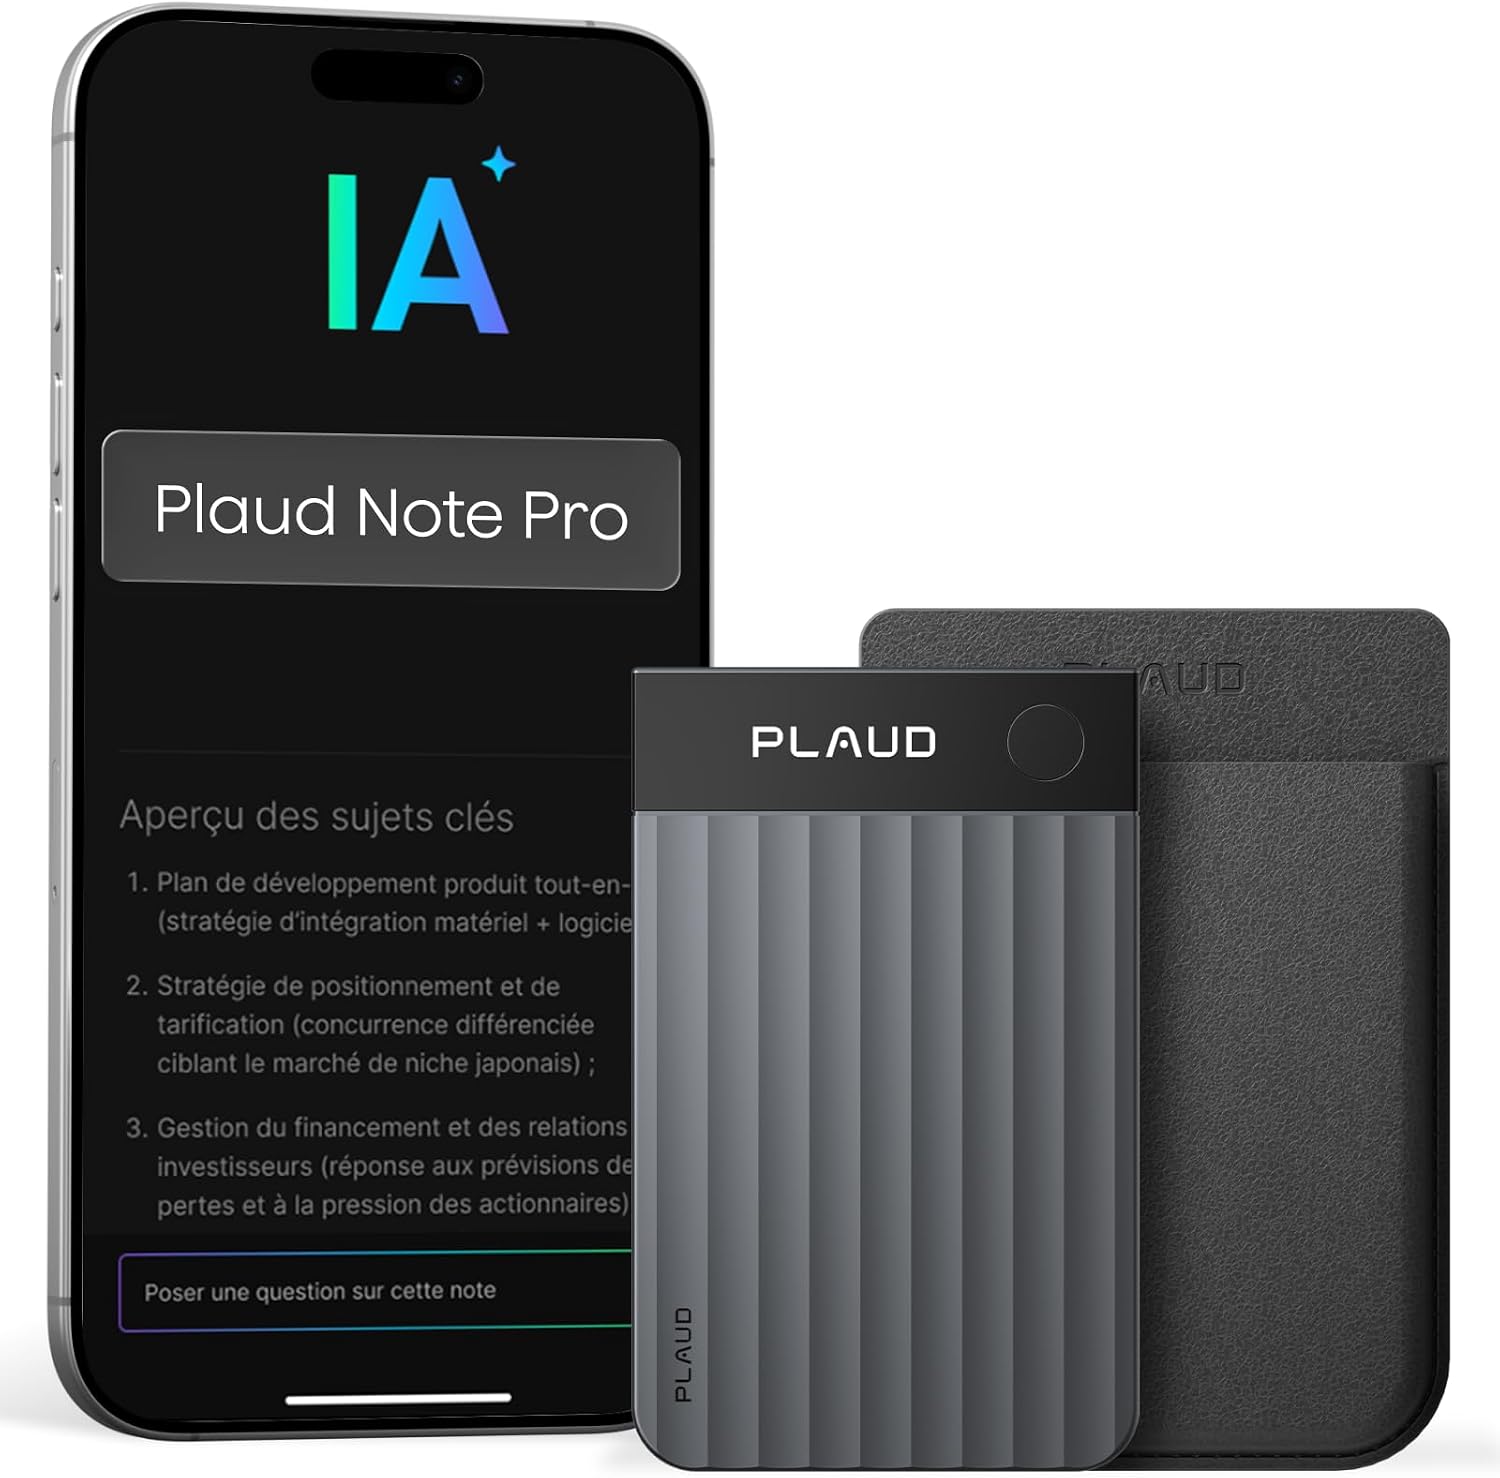
私のPlaud Note Pro。現場での会話やインタビューの録音に使えます。
Plaud Note Proは小さなボイスレコーダーで、会議や会話、インタビューの録音に使えます。
録音はその後Plaudで利用でき、文字起こしもできます。
とはいえ、私のシステムにとっていちばん関心があるのは、Plaudが自動で作る要約ではありません。
欲しいのは完全な文字起こしです。
そして、もう一つ重要な部品があります。ChatGPTは専用のコネクタを通じてPlaudに直接アクセスできるのです。
そのため、ChatGPTから、たとえば次のように頼めます。
私のPlaudの最新の録音を三つ挙げて、それぞれ何について話しているかを一行で教えて。
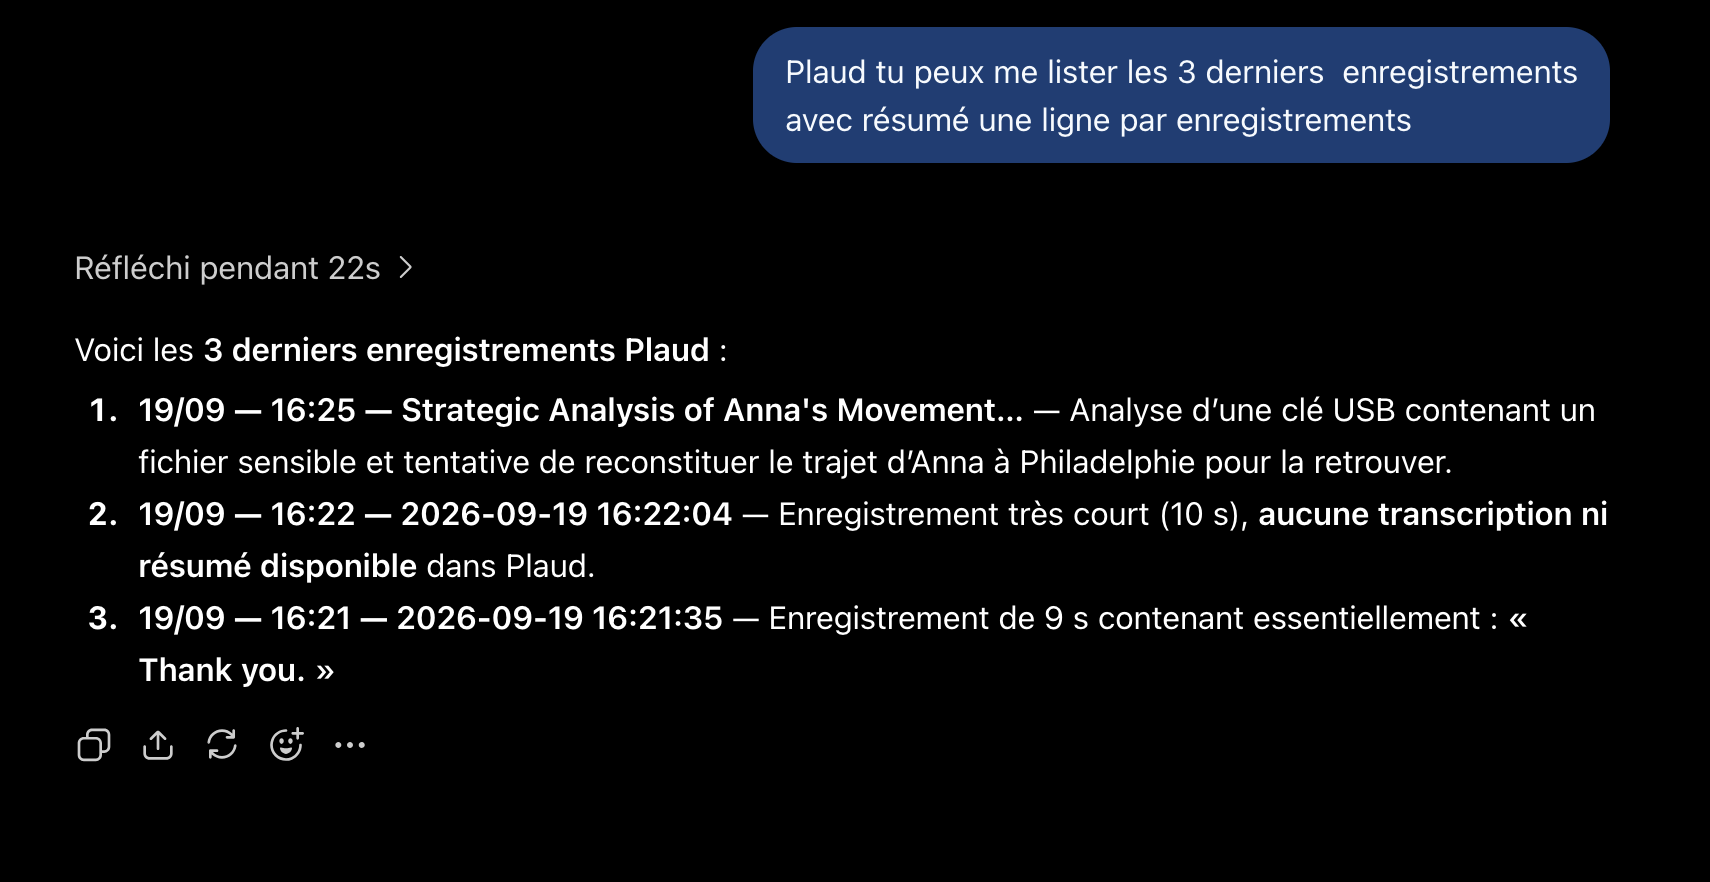
ChatGPTからPlaudに問い合わせて、最新の録音を探し出した例です。
ChatGPTはこれらの録音を探し出し、その文字起こしを直接取得できます。
これによって、はるかに直接的なワークフローが考えられます。
実際の会話
        ↓
Plaud
        ↓
文字起こし
        ↓
ChatGPTが文字起こしを直接取得する
        ↓
永続化
        ↓
Contexteの生のソース
        ↓
インジェスト
つまり、次のことをする必要がありません。
- ファイルを手作業でダウンロードする
- 文字起こしを開く
- それをコピーする
- ChatGPTに戻る
- 貼り付ける
これらをすべて、スマートフォンから音声で、自動的に行えます。
そして私は、ただの要約よりも、生の完全な文字起こしをContexteに入れるほうを選びます。
要約はすでに一つの解釈です。
文字起こしのほうが、元の素材にずっと近いままです。
会話をContexteに入れたら、次のように尋ねられます。
- この人は、実際に私に何を教えてくれたのか。
- これまでの会話と矛盾しているのは何か。
- 確認すべき主張はどれか。
- 次の人にはどんな質問をすべきか。
必要な部品は、それぞれすでに動いています。
ただし、このPlaud → ChatGPT → Contexteというワークフローを、現場での長い一日を通して端から端まで十分に試したわけではありません。完全にスムーズだと言える段階ではまだありません。
ですから、これはもっと試してみる必要のある使い方です。
このシステムを再現する方法
エンジンの指示の二つの層に対応する、二つのファイルを用意しました。
CORE
COREはこちらで公開しています。
ChatGPTのプロジェクトの指示にコピーするのは、この部分です。
拡張指示
詳しい指示はこちらで公開しています。
これは、ChatGPTがアクセスできるGoogle Docにコピーしてください。
始める前に、当然ながらGoogle DriveをChatGPTに接続し、エンジンが使うドキュメントにアクセスできるようにしておく必要があります。
IDを設定する
COREには、特に次の二つの識別子が含まれています。
DOCUMENT_ID = xxxx
FOLDER_ID = xxxx
DOCUMENT_IDは、拡張指示が入ったGoogle Docを指します。
次のようなURLでは、
https://docs.google.com/document/d/xxxx/edit
xxxxの部分がドキュメントの識別子です。
FOLDER_IDは、Contexteを保存するGoogle Driveのフォルダを指します。
次のようなURLでも、
https://drive.google.com/drive/folders/xxxx
識別子はやはりxxxxの部分です。
もちろん、利用者はそれぞれ、これらの値を自分の環境のものに置き換える必要があります。
ContexteごとにSpreadsheetを一つ
新しいContexteがつくられると、エンジンは次のタブを持つSpreadsheetを作成します。
00-FRAME
01-STATE
03-SESSIONS
04-ATOMIC
05-OUTPUTS
そのSpreadsheetは、FOLDER_IDで指定したフォルダに置かれます。
これらのSpreadsheetの識別子を一つずつ手作業で指示に書き写す必要はありません。
私が次のように頼むと、
開く 私のContexte
ChatGPTはContexteのフォルダの中から対応するSpreadsheetを探し、そのIDを取得して、会話のあいだ保持します。
これで、システムは使える状態になります。
この手づくりの仕組みでできること、そしてその限界
このChatGPT版は、CodexやClaude Codeで使っている私のエンジンに取って代わるものではありません。
もともと、それが目的ではありませんでした。
いくつかの限界があります。
動作が遅くなります。
PythonスクリプトやAPI呼び出し、より充実した実行環境を直接必要とするContexteには、あまり向いていません。
そして何より、Contexteが数週間にわたって本当に大きくなったときにどう振る舞うのかについては、まだ十分な経験がありません。
そういうわけで私はこれを、補完的な単独モードと位置づけています。
Macの上では、ミッションによってはCodexやClaude Codeのほうが向いています。
けれども今では、スマートフォンから、Macの電源が入っていてつながるかどうかに左右されずにContexteを使えます。
そしてそれこそが、私の解決したかった問題でした。
Codexの利用枠について、ちょっと面白い観察もあります。
ChatGPTでのこの実験のあいだずっと、表示されているCodexの利用枠は減りませんでした。
観測された消費量は、
0
もちろん、これがOpenAIのこの種の利用に対する課金や計上の仕方について、一般的なルールになると言うつもりはありません。
この実験のあいだ、この手づくりの仕組みは私のCodexの利用枠を消費しなかった。そう確認しただけです。
このシステムは、すでにこの記事をつくるのに使われた
もともと、最初のGoogle Sheetsのハックは、かなり限られた問いに答えるものでした。
ChatGPTから情報を書き出して、長く保持するにはどうすればよいか。
数日後、問いは次のように変わっていました。
Contexteの構造化されたメモリを丸ごと外に出したらどうなるか。
結局、このシステムがしているのはそれです。
ChatGPTはもう「すべてを覚えておく」必要はありません。
何より知っておくべきなのは、次のことです。
- どこを探すか
- 何をロードするか
- 何を永続化するか
- 情報をどう位置づけるか
- すでに学んだことをどう探し出すか
- 仕事がどこまで進んでいるか
公式はかなり単純なままです。
ChatGPTが推論する。
指示がエンジンを定める。
Google Sheetsが記憶する。
そして、この記事の準備と執筆そのものが、記事で説明しているシステムのテストになったことには、なかなかの満足感があります。
この文章を準備するのに、私はChatGPTの中のこのContexteだけを使いました。
そこに自分のアイデアを永続化しました。
それをインジェストしました。
私たちは死角を見つけました。
表現を手直ししました。
私たちはタスクをつくり、それを完了させました。
足りない要素を加えました。
それから記事の最初の版を書き、読み直し、同じContexteを使ってこのV2を準備しました。
つまり、このシステムは単なる技術デモとして使われただけではありません。
私がこのシステムをつくった目的である仕事を、実際にこなすためにすでに使われたのです。
だからこそ、問いはもう、
これは動くのか。
ではありません。
動きます。
いま私が関心を持っている問いは、むしろ次のものです。
同じContexteを、業界展示会の丸一週間という現場で試したときにも、このアーキテクチャは同じくらい便利なままでいられるのか。
それは、これから使い続けることで確かめられるはずです。