原文はフランス語です。AI により翻訳されました — 文体ではなく意味を保っています。
Graphifyは、AIにお金を払って各ファイルを読ませ、コードのマップを作るためのツールです。私はこれを転用して、自分のナレッジwikiのマップを作りました。AIもAPIキーも使っていません。160行のPythonファイル1つ、計算時間0.2秒で、1,000枚のノートが、探索し、問い合わせ、たどることのできるグラフになります。
マーケティングに関する1,000枚のノート。アトミックノート、用語集の定義、本ごとの読書マップ。すべてが互いにリンクされ、どのリンクにも、なぜそこに張られているのかの説明が添えられています。
それなのに、全体の形が見えません。たとえば次のような問いに、簡単に答えられないのです。Cialdiniの返報性とSaaSの解約(churn)はどうつながるのか。どのノートがテーマの中心にあり、どのノートが孤立しているのか。
Obsidianのグラフビューに表示されるのは毛糸玉です。美しいけれど、何も語りません。
この記事では、コード向けに作られたツールであるGraphifyを転用して、このwikiから実際に使えるグラフを手に入れた方法と、そのグラフが自分のナレッジベースについて教えてくれたことをお話しします。
出発点:リンクに意味があるwiki
なぜAIが管理するナレッジベースを作ったのかは、以前に書きました。仕組みはこうです。私が本や資料をClaudeに渡すと、Claudeはそこからアトミックノートや用語集の項目などのカードを取り出し、互いにリンクします。
この先の話で何より重要なルールが1つあります。リンクは決して飾りであってはならない。どのリンクの後にも、関係を説明する短い一文が続きます。
- [[GLO00614-marche-minimal-viable]] — MVMarketはキャズムを越えるための
  戦略であって、キャズムそのものではない。
- [[GLO00619-technology-adoption-life-cycle]] — キャズムが位置づけられる
  枠組み。
つまり、アイデア同士の関係は、ノートの中にすでにはっきりと書かれているのです。この細部こそが、ほかのすべてを可能にしています。
Graphifyとは何か
Graphifyは、コードや文書のフォルダをナレッジグラフに変換するツールです。できたグラフには、Claude Codeのようなアシスタントから問い合わせることができます。
動作は2段階です。
- 構築。Graphifyは各ファイルをAIに読ませ、AIが重要な要素とその間の関係を推論します。ここが高くつく段階です。トークンを消費し、結果は実行のたびに変わります。
- 探索。グラフが構築されると、Graphifyはそれを近いノード同士のグループに分け、インタラクティブマップとレポートを生成し、質問に答えます。ある要素にはどんなつながりがあるか、AとBを結ぶのはどんな経路か、といった質問です。
転用のアイデア
コードのリポジトリなら、構築の段階には意味があります。ある関数が別の関数を呼び出すことを、誰もはっきりとは書いていないので、推論するしかありません。
私のwikiでは逆です。AIが推論すべきことは何もありません。関係はすでにそこにあり、手で書かれたか、取り込みの時点で確認されています。それをAIにお金を払って再発見させるのは、高くつき、遅く、すでに書かれているものほど忠実でもありません。
そこで私は、構築を小さな自作スクリプトに置き換え、Graphifyのそれ以外の部分はすべてそのまま使うことにしました。
wikiのノート (.md)
      │
      │  自作スクリプト:[[...]] リンクとその説明を読む
      ▼
graph.json  (NetworkX標準形式)
      │
      │  Graphify:グループ、マップ、レポート、質問
      ▼
graph.html · GRAPH_REPORT.md · explain · path · query
転用を可能にしているのは、GraphifyがNetworkXライブラリの標準形式であれば、どんなグラフでも受け付けるという点です。そのグラフがどこから来たのかは確認しません。渡すだけでいいのです。
内部の仕組み:ファイルは1つだけ
スクリプトがすることは3つです。
1. ノートを洗い出す。Markdownファイルはそれぞれ1つのノードになります。識別子はファイル名で、種類は接頭辞から判定します。ATOならアトミックノート、GLOなら用語集、MOCなら読書マップ、という具合です。
2. リンクを見つける。正規表現で本文中の[[ID-slug]]をすべて探します。リンク先のノートが存在すれば、リンクを作成します。
3. 関係に名前をつける。リンクの後のダッシュに続く文が、関係名になります。これによってGraphifyは、単なる「リンク」ではなく、「MVMarketはキャズムを越えるための戦略」と表示できるのです。
for line in text.splitlines():
    matches = LINK_RE.findall(line)
    relation_match = re.search(r"\]\]\s*[—-]+\s*(.+)", line)
    relation = relation_match.group(1).strip()[:80] if relation_match else "links"
インストールすべきライブラリはありません。スクリプトはPythonに標準で付属するモジュールしか使っていません。ファイル全文は次のとおりです。
"""
Build graph.json from Obsidian [[links]] in wiki notes — no LLM needed.
Output format: NetworkX node_link_graph (compatible with graphify path/explain/query).

Usage:
    .venv/bin/python scripts/build_graph.py [--theme maintenance] [--output _GRAPHITY/]
"""

import argparse
import json
import re
import uuid
from pathlib import Path

WIKI_ROOT = Path(__file__).resolve().parent.parent.parent.parent / "wiki"
LINK_RE = re.compile(r"\[\[([A-Z]{2,3}\d{5}-[^\]\|]+?)(?:\|[^\]]*)?\]\]")
FRONTMATTER_RE = re.compile(r"^---\n(.*?)\n---", re.DOTALL)

TYPE_MAP = {
    "ATO": "atomic_note",
    "GLO": "glossary_term",
    "NOR": "norm_reference",
    "EXN": "normative_requirement",
    "PRO": "business_process",
    "OBJ": "domain_object",
    "BRL": "business_rule",
    "REG": "regulatory_text",
    "HAB": "habilitation",
    "IND": "indicator",
    "MOC": "moc",
    "SRC": "source_record",
}


def parse_frontmatter(text: str) -> dict:
    m = FRONTMATTER_RE.match(text)
    if not m:
        return {}
    result = {}
    for line in m.group(1).splitlines():
        if ":" in line:
            k, _, v = line.partition(":")
            result[k.strip()] = v.strip().strip('"')
    return result


def slug_to_id(slug: str) -> str:
    """Extract the ID prefix (e.g. 'ATO00001') from a slug like 'ATO00001-some-title'."""
    parts = slug.split("-", 1)
    return parts[0].upper()


def build_graph(theme: str, output_dir: Path) -> dict:
    notes_root = WIKI_ROOT / "themes" / theme / "notes"
    if not notes_root.exists():
        raise SystemExit(f"Notes directory not found: {notes_root}")

    nodes = {}   # node_id -> node dict
    edges = []   # list of {source, target, relation}

    md_files = list(notes_root.rglob("*.md"))
    md_files = [f for f in md_files if f.name != "README.md"]

    # Index: slug -> node_id (file stem without extension)
    slug_index = {}
    for f in md_files:
        stem = f.stem  # e.g. ATO00001-some-title
        slug_index[stem] = stem
        # Also index by bare ID (ATO00001) for robustness
        bare_id = stem.split("-")[0]
        slug_index.setdefault(bare_id, stem)

    print(f"[build_graph] {len(md_files)} notes found in {notes_root}")

    for f in md_files:
        text = f.read_text(encoding="utf-8")
        fm = parse_frontmatter(text)

        node_id = f.stem
        prefix = node_id[:3].upper()
        node_type = TYPE_MAP.get(prefix, "note")
        title = fm.get("title") or fm.get("term") or fm.get("name") or node_id
        subdir = f.parent.name  # e.g. "atomiques", "glossaire"

        nodes[node_id] = {
            "id": node_id,
            # label = slug so graphify path/explain resolve by ID (e.g. "ATO00001-...")
            "label": node_id,
            "title": title,
            # norm_label includes slug tokens for fuzzy matching
            "norm_label": node_id.lower().replace("-", " "),
            "type": node_type,
            "kind": node_type,
            "source_file": str(f.relative_to(WIKI_ROOT.parent)),
            "subdir": subdir,
            "status": fm.get("status", "draft"),
            "uid": fm.get("uid") or str(uuid.uuid4()),
            "wiki_id": fm.get("id", ""),
        }

    # Second pass: extract links
    seen_edges = set()
    for f in md_files:
        text = f.read_text(encoding="utf-8")
        source_id = f.stem

        # Extract label from link context line (text after — )
        for line in text.splitlines():
            matches = LINK_RE.findall(line)
            # Extract relation label from "— relation text" after the link
            relation_match = re.search(r"\]\]\s*[—-]+\s*(.+)", line)
            relation = relation_match.group(1).strip()[:80] if relation_match else "links"

            for slug in matches:
                # Resolve target
                target_id = slug_index.get(slug) or slug_index.get(slug.split("-")[0])
                if not target_id or target_id == source_id:
                    continue
                if target_id not in nodes:
                    continue
                key = (source_id, target_id)
                if key in seen_edges:
                    continue
                seen_edges.add(key)
                edges.append({
                    "source": source_id,
                    "target": target_id,
                    "relation": relation,
                    "key": 0,
                })

    node_list = list(nodes.values())

    graph_data = {
        "directed": True,
        "multigraph": False,
        "graph": {"theme": theme},
        "nodes": node_list,
        "links": edges,
    }

    output_dir.mkdir(parents=True, exist_ok=True)
    graph_path = output_dir / "graph.json"
    graph_path.write_text(json.dumps(graph_data, ensure_ascii=False, indent=2), encoding="utf-8")

    print(f"[build_graph] {len(node_list)} nodes, {len(edges)} edges")
    print(f"[build_graph] graph.json → {graph_path}")
    return graph_data


if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("--theme", default="maintenance")
    parser.add_argument("--output", default="_GRAPHITY/")
    args = parser.parse_args()

    build_graph(args.theme, Path(args.output) / args.theme)
マーケティングのテーマでの結果
私のwikiのマーケティングのテーマは、20冊ほどの本をもとにしています。Dunford、Seth Godin、Cialdini、Moore、RiesとTrout、Nagle、Byron Sharp、Rob Fitzpatrick……。
| 指標 | 値 |
|---|---|
| ノート | 1,013 |
| リンク | 6,442 |
| 検出されたノートのグループ | 22 |
| グラフの構築時間 | 0.2秒 |
| 消費したAIトークン | 0 |
マップとノートのグループ
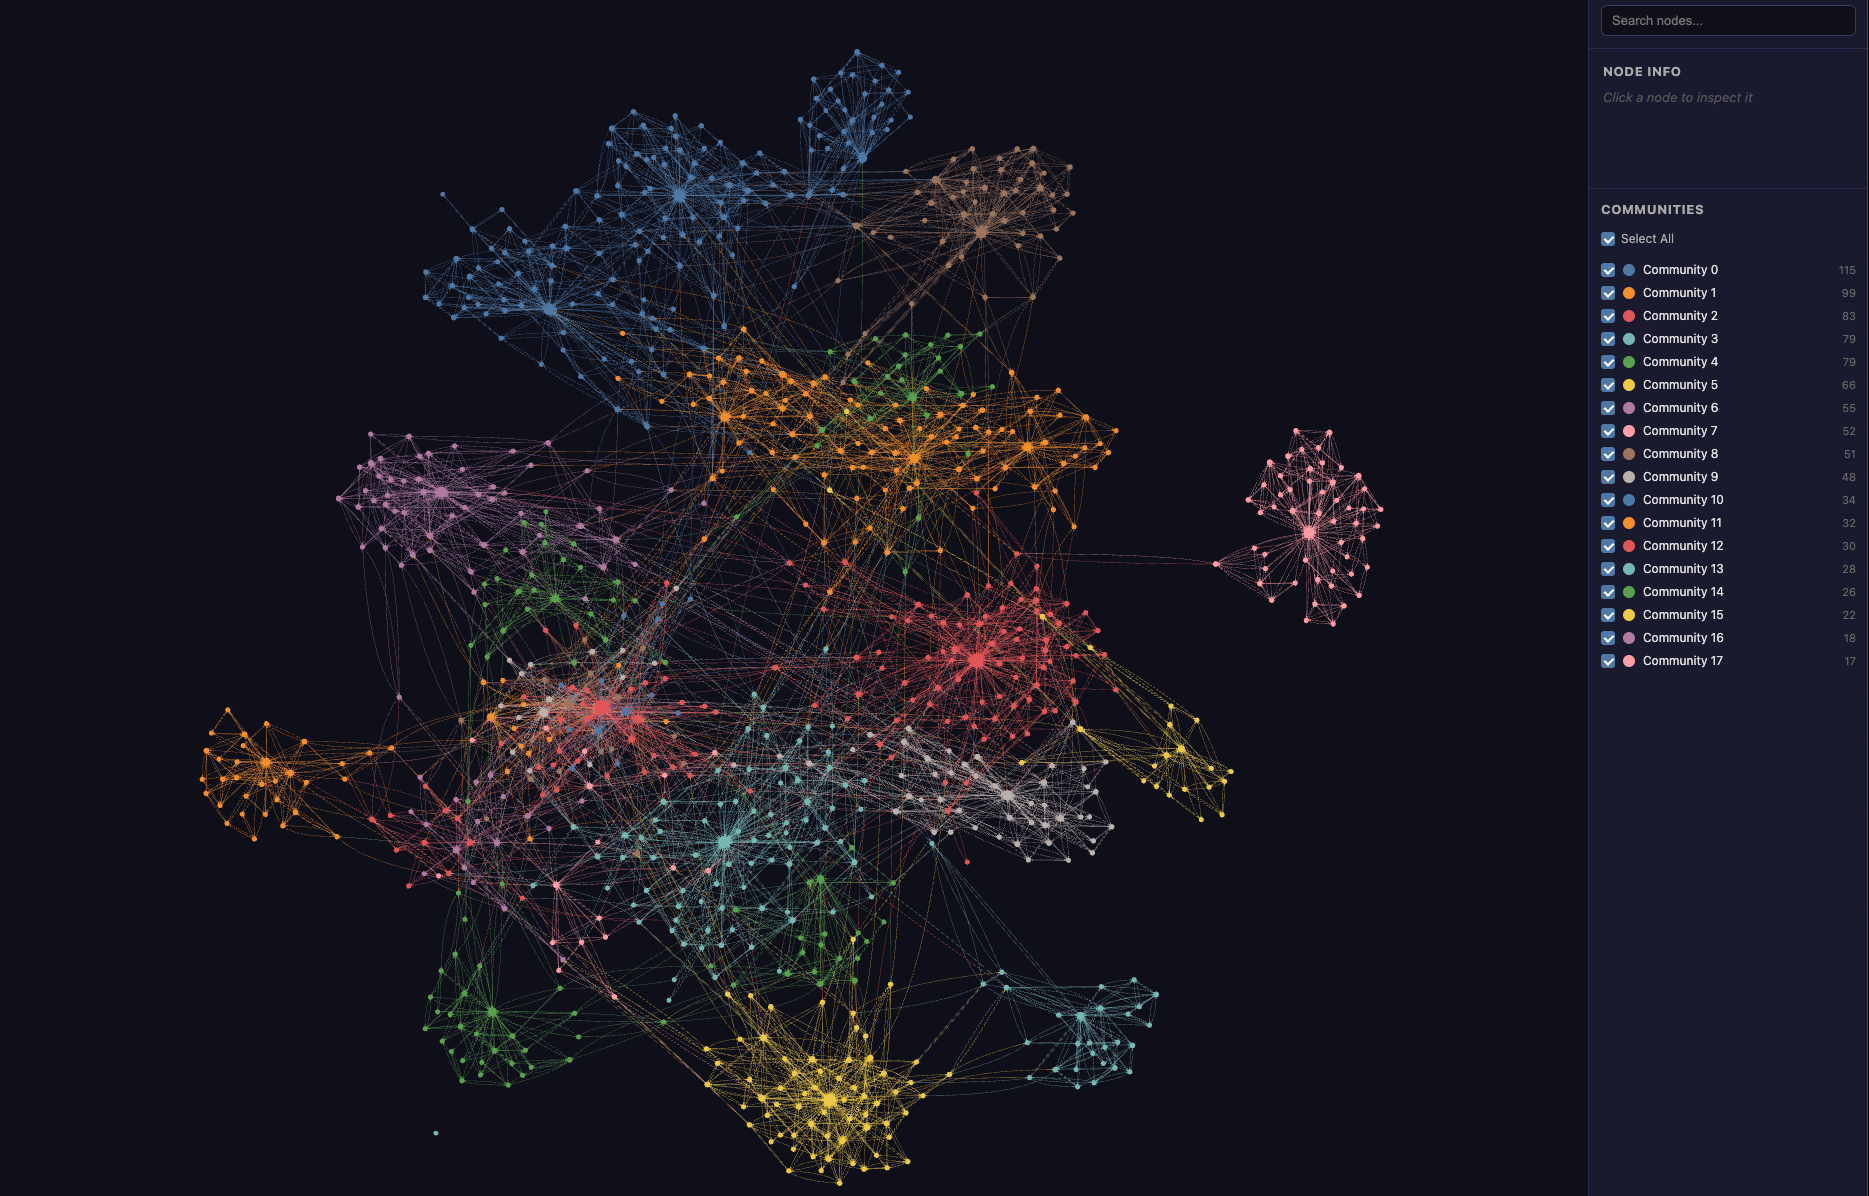
Graphifyは、グラフをノートのグループに分けます。グループとは、ほかの部分よりも互いに強くリンクし合っているノートの集まりです。マーケティングのテーマで見つかったグループをいくつか挙げます。
- Mom Testを中心とする53枚のノートのグループ:顧客との会話、何の価値もないお世辞、約束ではなく過去の事実。
- 影響力に関する52枚のノートのグループ:Cialdiniの6つの原理、返報性、知覚のコントラスト、服従を引き起こす「なぜなら」。
- キャズムに関する46枚のノートのグループ:アーリーアダプターと実利的な多数派の間の溝、ボウリングピン戦略。
- カスタマーサクセスに関する26枚のノートのグループ:死のスパイラルとしての解約、カスタマーサクセスとサポートの違い。
レポートは、最もつながりの多いノートも特定します。上位10枚はすべて読書マップでした。トップはDunfordのObviously Awesomeの読書マップでリンク180本、続いてSeth GodinのThis is Marketingが156本です。
最後に、孤立したノートも指摘します。1,013枚のうち、たった1枚でした。ペルソナマーケティングに関するノートで、ほかのどこともリンクしていません。wikiの穴が、コストをかけずに見つかったわけです。
1枚のノートのつながり
Graphifyに、キャズムに関する用語集のノートを説明させてみます。
graphify explain "GLO00618-chasm"
Graphifyは、出入りの両方向をあわせた30のつながりと、それぞれの関係を返します。抜粋です。
| 向き | リンク先のノート | ノートに書かれた関係 |
|---|---|---|
| ← | Crossing the Chasmの読書マップ | モデルの中心にある溝 |
| → | テクノロジー・アダプション・ライフサイクル | キャズムが位置づけられる枠組み |
| → | アーリーアダプターは劇的な優位を求め、多数派は段階的な改善を求める | キャズムのサイコグラフィックな原因を説明する |
| ← | ホールプロダクト(whole product) | キャズムの一因はホールプロダクトの欠如にある |
| ← | ボウリング・アレー | キャズムを越えた後に始まる |
| → | Mooreの溝はアーリーアダプターとマス市場を隔てる | 同じアイデア。Mooreを引用するSeth Godinから |
→:キャズムがこのノートを引用している。←:このノートがキャズムを引用している。
いちばん興味深いのは最後の行です。キャズムはGeoffrey Mooreの概念ですが、Seth Godinも別の本でそれに触れています。グラフは、2つの情報源が同じアイデアで合流していることを示しているのです。
離れた2つのアイデアを結ぶ経路
社会心理学の原理であるCialdiniの返報性のルールと、サブスクリプションビジネスの解約は、どうつながるのでしょうか。
graphify path \
  "ATO01269-la-regle-de-reciprocite..." \
  "ATO01404-dans-un-business-de-revenus-recurrents-le-churn..."
Graphifyは8ステップの経路を見つけます。
- 返報性のルールは普遍的であり、人間の協力の土台となる
- → Influence(Cialdini)の読書マップ
- → 最初のコミットメントは自己イメージを変え、自動的な一貫性を生む
- → 高いリスクが信頼をつくる。値下げは信頼を損なう
- → 類似:高い価格は品質を示し、信頼を支える → 価格品質効果により、高い価格は品質のシグナルとして受け取られる
- → The Strategy and Tactics of Pricing(Nagle)の読書マップ
- → スイッチングコストは価格感度を下げる → 収束:スイッチングコストはリテンションの主要なレバー → リテンションは最も強力な成長の乗数である
- → カスタマーサクセスの主張との収束:解約は成長を破壊する → 継続課金ビジネスでは、解約は死のスパイラルである
この経路は1つの物語を語っています。コミットメントの心理から信頼のシグナルとしての価格へ、そしてスイッチングコストからリテンションへ。この推論を一続きに書いた人はいません。ノートからノートへ、本から本へと張られたリンクから、浮かび上がってくるのです。
Obsidianのグラフビューにはないもの
Obsidianのグラフビューはリンクを描きます。Graphifyはそれに加えて、次のことをします。
- ノートのグループを自動で検出する
- ノートに書かれた説明を使って、関係に名前をつける
- 2つのノートを結ぶ最短の経路を見つける
- 中心的なノート、孤立したノート、意外なつながりをまとめたレポートを作る
- コマンドラインで使える。そのため、Claudeはwikiで作業しながら自分でGraphifyに問い合わせられる
限界
質問による検索はタイトルしか読みません。Graphifyには自由検索のコマンドもあります。これは質問の言葉をノートの本文ではなく名前の中で探し、それから隣接するノートへ範囲を広げます。質問にタイトルの言葉が含まれていなければ、何も見つかりません。
グループは概念よりも本に沿ってまとまります。たとえばポジショニングは5つのグループに分かれていて、その分かれ方はおおむね出典の本によるものです。Dunfordが一方、RiesとTroutがもう一方、という具合です。本ごとの読書マップにリンクが集中しすぎて、グラフ全体の構造を決めてしまうのです。経路にも同じ影響があります。キャズムと支払意欲を結ぶ経路は3つの読書マップを経由します。正しくはあっても、あまり学びはありません。
グループに名前がありません。GraphifyはAIでグループに名前をつけることもできますが、それでは避けたかったコストを再び持ち込むことになります。そのためグループは「Community 0」「Community 1」……と呼ばれ、解釈するのは私の仕事です。
Graphifyはあくまでコード向けのツールです。構築のたびに12,884件の警告が出ます。リンクに「ソースファイル」がないという警告ですが、これはコードにしか意味のない概念です。実害はありませんが、ツールを本来の用途の外で使っていることを思い出させます。
グラフの価値はリンクの価値で決まります。説明のないリンクは、何も語らない「links」という関係になります。リンクの貼り方が悪いノートは孤立したままです。グラフは何も直しません。見せるだけです。
自分の環境で再現する
[[...]]リンクでつながったMarkdownのノートが必要です。
- 自分でリンクを貼るObsidianの保管庫でも
- こちらの記事で紹介したような、AIが管理するwikiでもかまいません。
上のスクリプトは、ATO00001-slug形式の識別子と、テーマごとのフォルダ構成を前提にしています。リンクの正規表現とノートのフォルダは、自分の構成に合わせて調整してください。
あとは3つのコマンドです。
pip install graphifyy

python build_graph.py --theme marketing --output _GRAPHITY/

graphify cluster-only _GRAPHITY/marketing/ --no-label \
  --graph _GRAPHITY/marketing/graph.json
インタラクティブマップは_GRAPHITY/marketing/graphify-out/graph.htmlに、レポートはその隣のGRAPH_REPORT.mdにできます。explainとpathのコマンドは、graph.jsonファイルに対してそのまま使えます。
AIが推論すべきことは何もありませんでした。すでに書いたものを読めば、それで十分だったのです。